> ## Documentation Index
> Fetch the complete documentation index at: https://docs.acedata.cloud/llms.txt
> Use this file to discover all available pages before exploring further.
# Solicitud y uso de la API Responses de OpenAI
> OpenAI generation API guide - Ace Data Cloud
OpenAI ha proporcionado recientemente una interfaz para crear respuestas de modelos. Proporcione entradas de texto o imágenes para generar salidas de texto o imágenes. Permita que el modelo llame a su propio código personalizado o utilice herramientas integradas, como búsqueda web o búsqueda de archivos, para utilizar sus propios datos como entrada para las respuestas del modelo.
Este documento presenta principalmente el proceso de uso de las operaciones de OpenAI Responses API; con ella podemos utilizar fácilmente la función oficial de OpenAI para crear respuestas de modelos.
## Proceso de solicitud
Para utilizar OpenAI Responses API, primero vaya a la [consola de Ace Data Cloud](https://platform.acedata.cloud/console/applications) para obtener su API Token y guárdelo como respaldo.
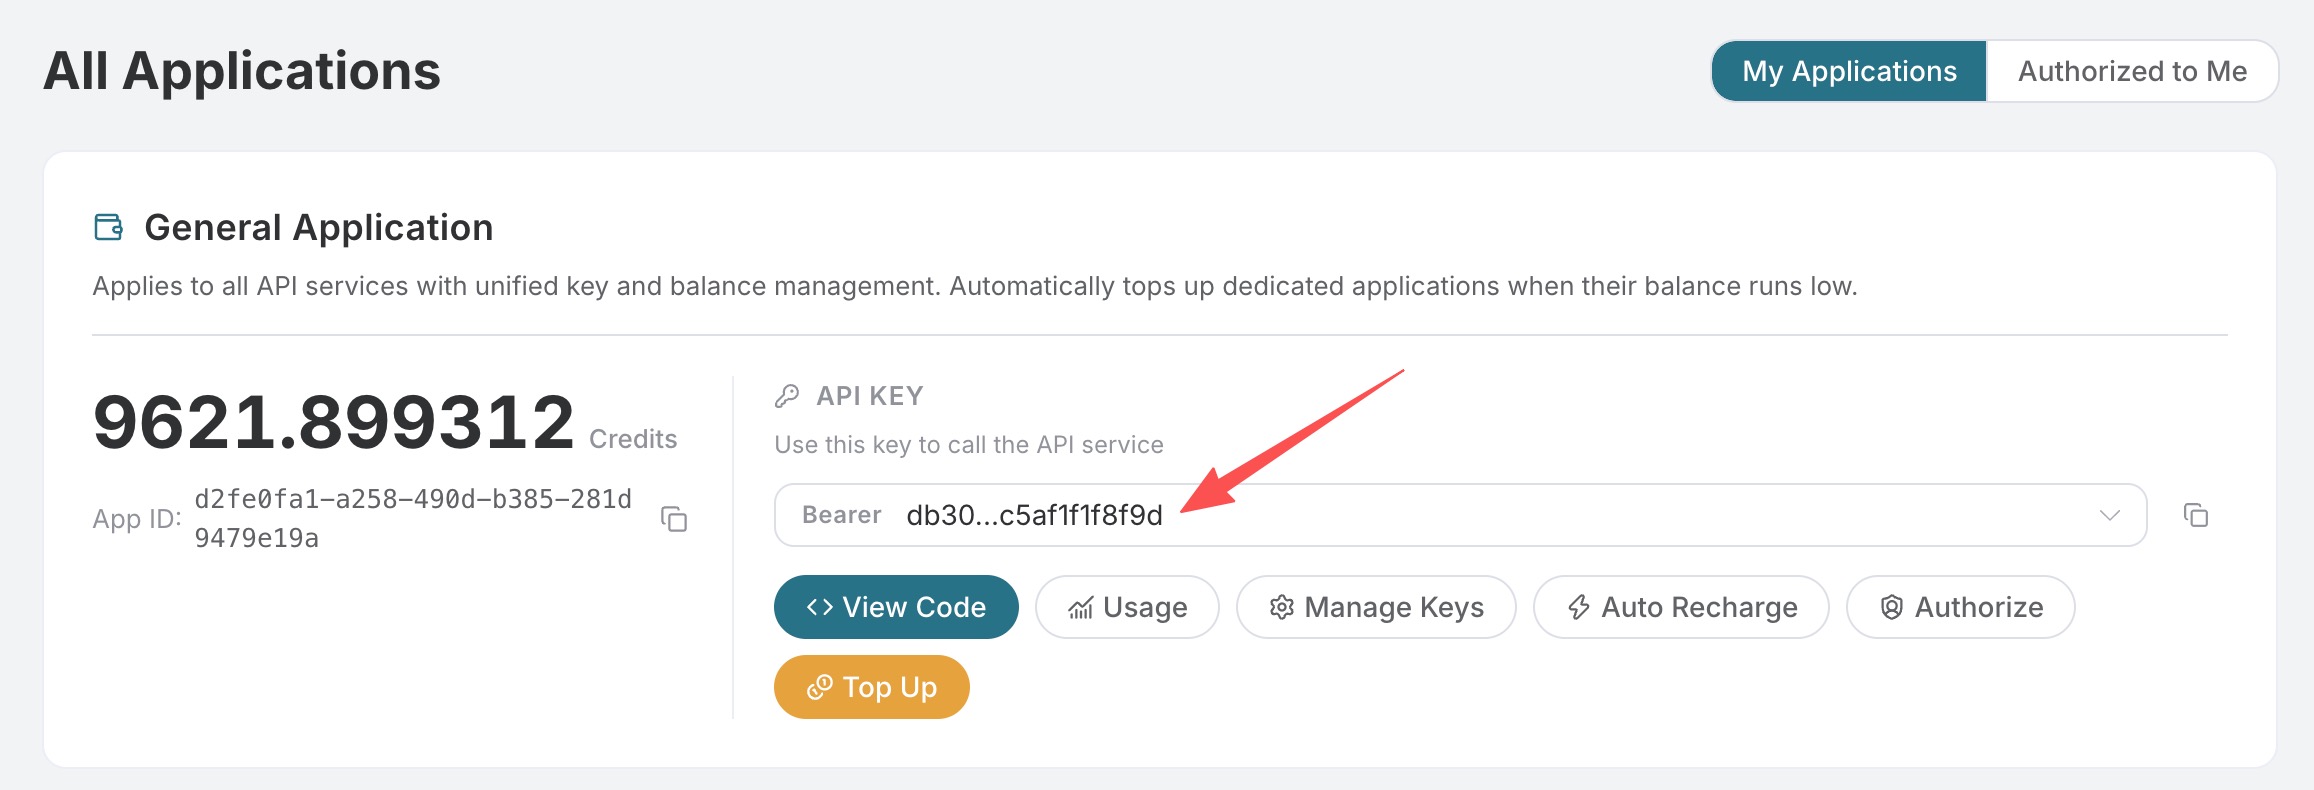
Si aún no ha iniciado sesión o no se ha registrado, será redirigido automáticamente a la página de inicio de sesión para invitarle a registrarse e iniciar sesión; al finalizar, volverá automáticamente a la página actual.
**Un solo API Token puede llamar a todos los servicios de la plataforma, sin necesidad de solicitar uno por separado para cada servicio.** La primera solicitud incluye crédito gratuito, que permite una experiencia gratuita; cuando el crédito sea insuficiente, puede recargar saldo general en la [consola](https://platform.acedata.cloud/console/coin).
> 📘 Documentación completa: [OpenAI Responses API →](https://platform.acedata.cloud/documents/openai-responses)
## Uso básico
A continuación, puede completar el contenido correspondiente en la interfaz, como se muestra en la imagen:
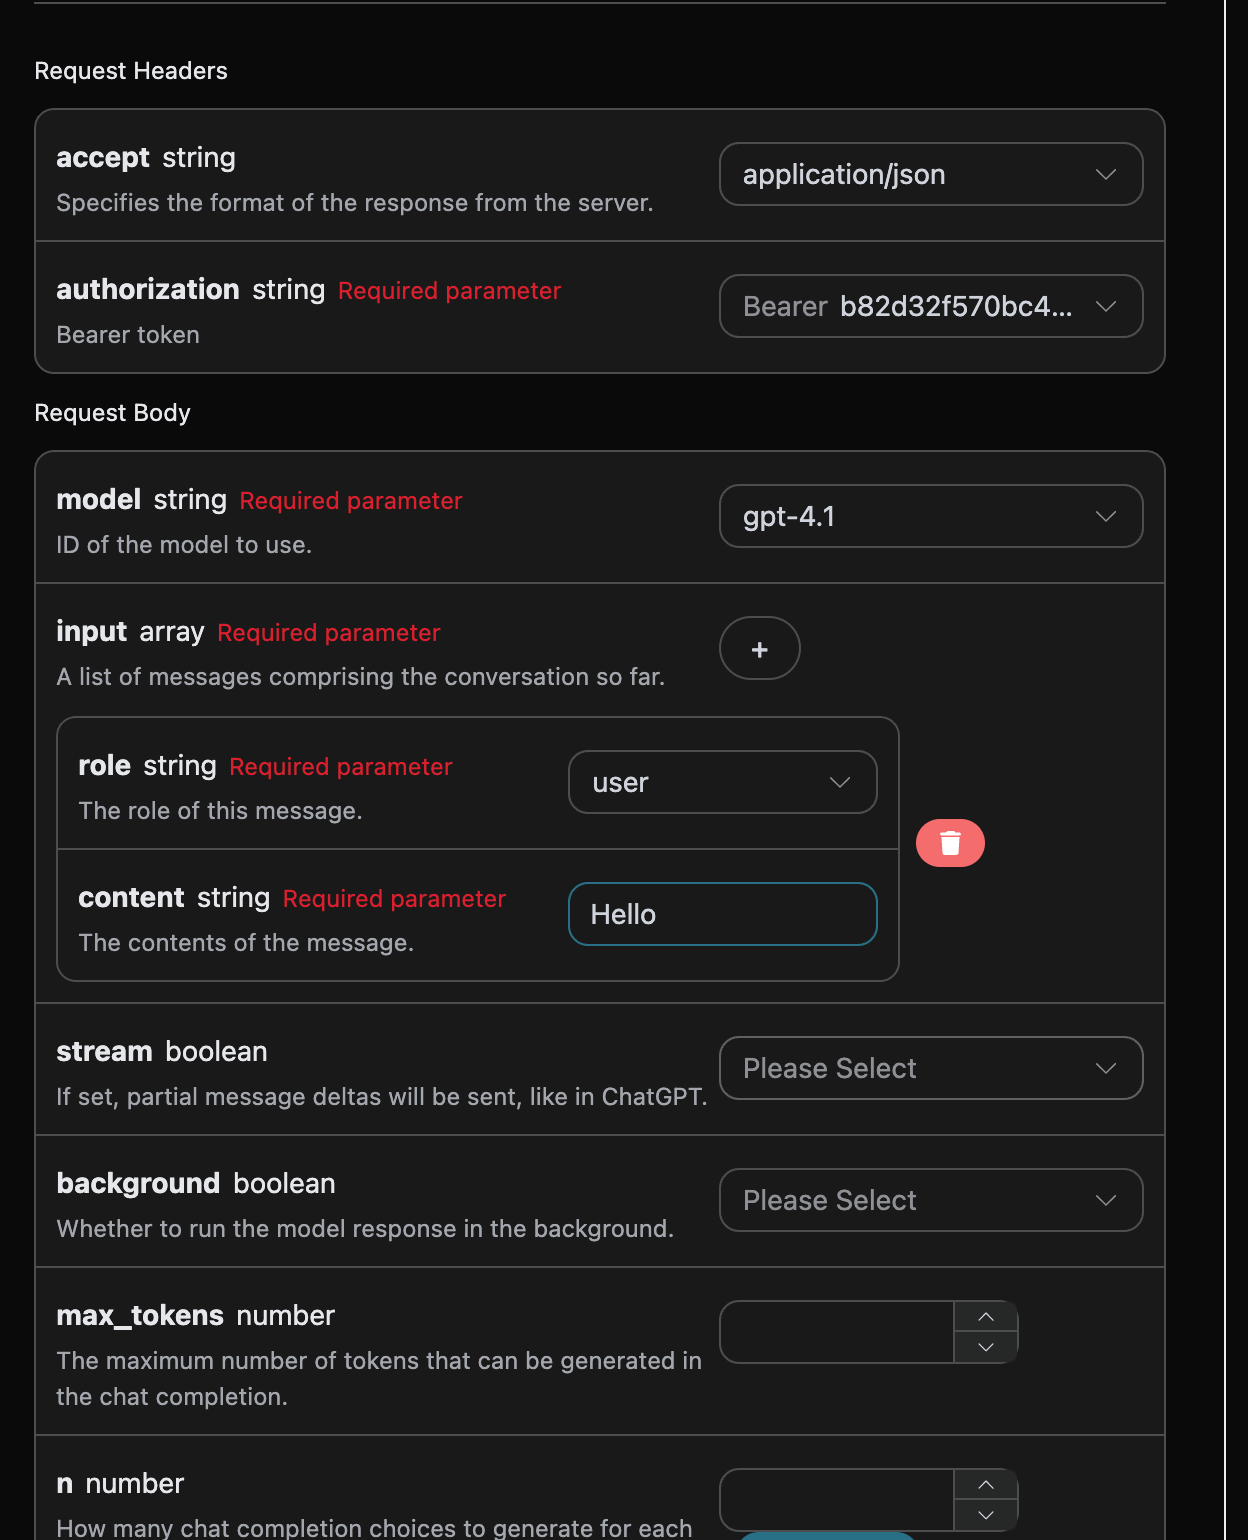
Al utilizar esta interfaz por primera vez, necesitamos completar al menos tres contenidos: uno es `authorization`, que puede seleccionarse directamente en la lista desplegable. Otro parámetro es `model`; `model` es la categoría de modelo del sitio web oficial de OpenAI ChatGPT que elegimos utilizar. Aquí contamos principalmente con 20 tipos de modelos; para más detalles puede consultar los modelos que proporcionamos. El último parámetro es `input`; `input` es el arreglo de consultas que introducimos. Es un arreglo, lo que indica que se pueden cargar varias consultas al mismo tiempo. Cada consulta contiene `role` y `content`, donde `role` indica el rol del consultante. Proporcionamos tres identidades: `user`, `assistant` y `system`. El otro, `content`, es el contenido específico de nuestra consulta.
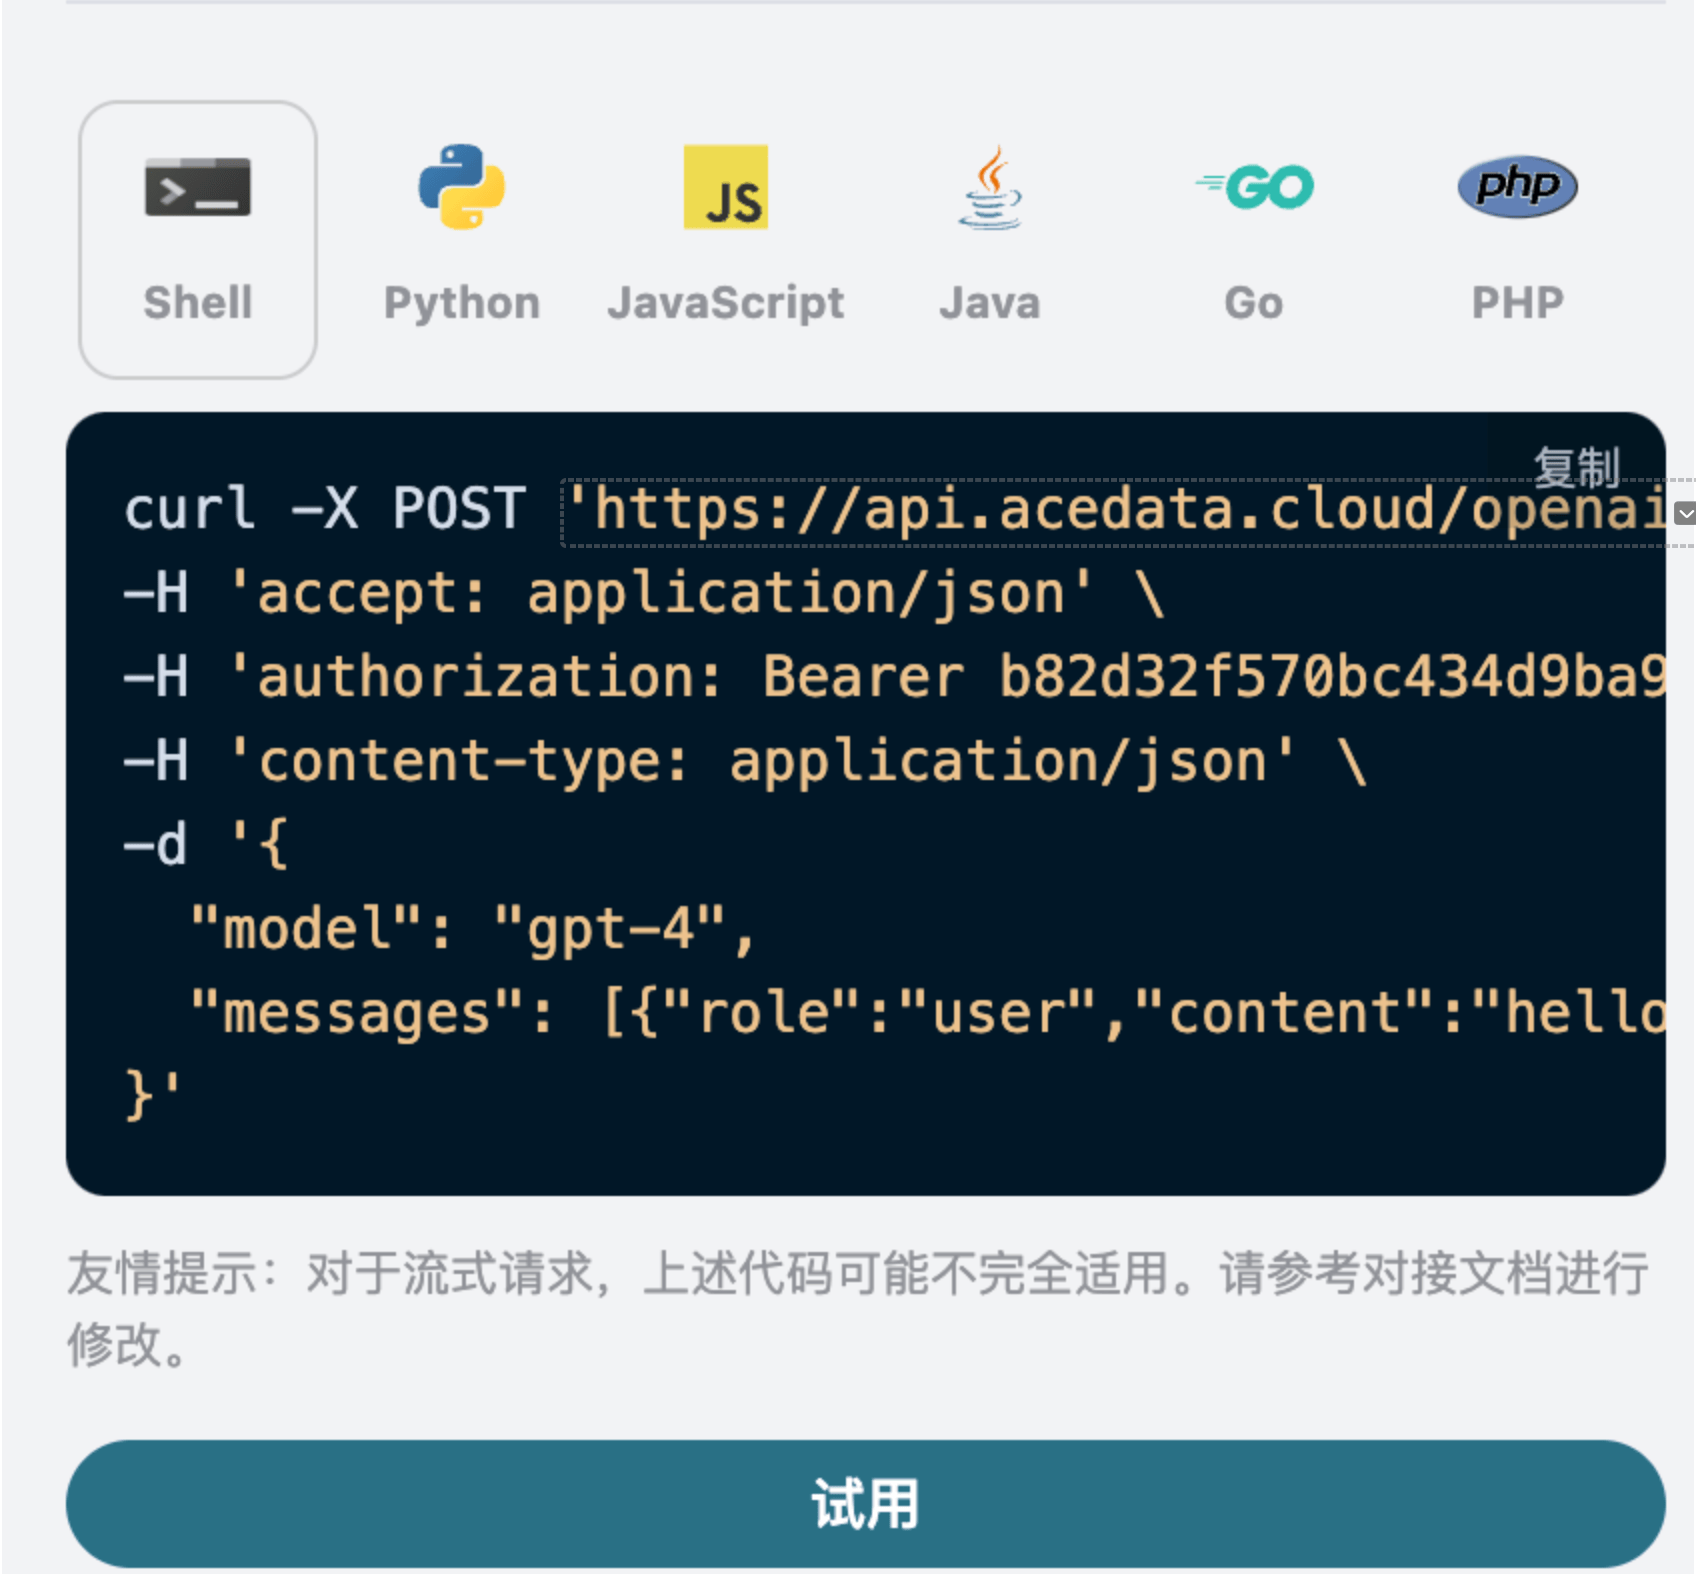
Al mismo tiempo, puede observar que hay una generación de código de llamada correspondiente a la derecha. Puede copiar el código y ejecutarlo directamente, o hacer clic directamente en el botón «Try» para realizar pruebas.
Parámetros opcionales comunes:
* `max_tokens`: limita el número máximo de tokens en una sola respuesta.
* `temperature`: aleatoriedad de la generación, entre 0 y 2; cuanto mayor sea el valor, más divergente será.
* `n`: cuántas respuestas candidatas se generan de una vez.
* `response_format`: configuración del formato de retorno.
* `tools`: definición de llamadas a funciones/herramientas.
* `background`: si se ejecuta de forma asíncrona en segundo plano.
Después de la llamada, encontramos que el resultado devuelto es el siguiente:
```json theme={null}
{
"id": "resp_68a98322e3c88191a027de2711a02a490554cad0b36c0400",
"object": "response",
"created_at": 1755939618,
"status": "completed",
"background": false,
"content_filters": null,
"error": null,
"incomplete_details": null,
"instructions": null,
"max_output_tokens": null,
"max_tool_calls": null,
"model": "gpt-5.5",
"output": [
{
"id": "msg_68a98323422c8191a7f383eea48ba5160554cad0b36c0400",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"annotations": [],
"text": "Hello! How can I assist you today?"
}
],
"role": "assistant"
}
],
"parallel_tool_calls": true,
"previous_response_id": null,
"prompt_cache_key": null,
"reasoning": {
"effort": null,
"summary": null
},
"safety_identifier": null,
"service_tier": "default",
"store": true,
"temperature": 1,
"text": {
"format": {
"type": "text"
}
},
"tool_choice": "auto",
"tools": [],
"top_p": 1,
"truncation": "disabled",
"usage": {
"input_tokens": 8,
"input_tokens_details": {
"cached_tokens": 0
},
"output_tokens": 10,
"output_tokens_details": {
"reasoning_tokens": 0
},
"total_tokens": 18
},
"user": null,
"metadata": {}
}
```
El resultado devuelto cuenta con varios campos, que se presentan a continuación:
* `id`, el ID que genera esta tarea de conversación, utilizado para identificar de forma única esta tarea de conversación.
* `model `, el modelo del sitio web oficial de OpenAI ChatGPT seleccionado.
* `output`, la información de respuesta proporcionada por ChatGPT para la consulta.
* `usage `: información estadística sobre los tokens de esta sesión de preguntas y respuestas.
Entre ellos, `output` contiene la información de respuesta de ChatGPT; el `output` dentro de él es ChatGPT, como se puede observar en la imagen.
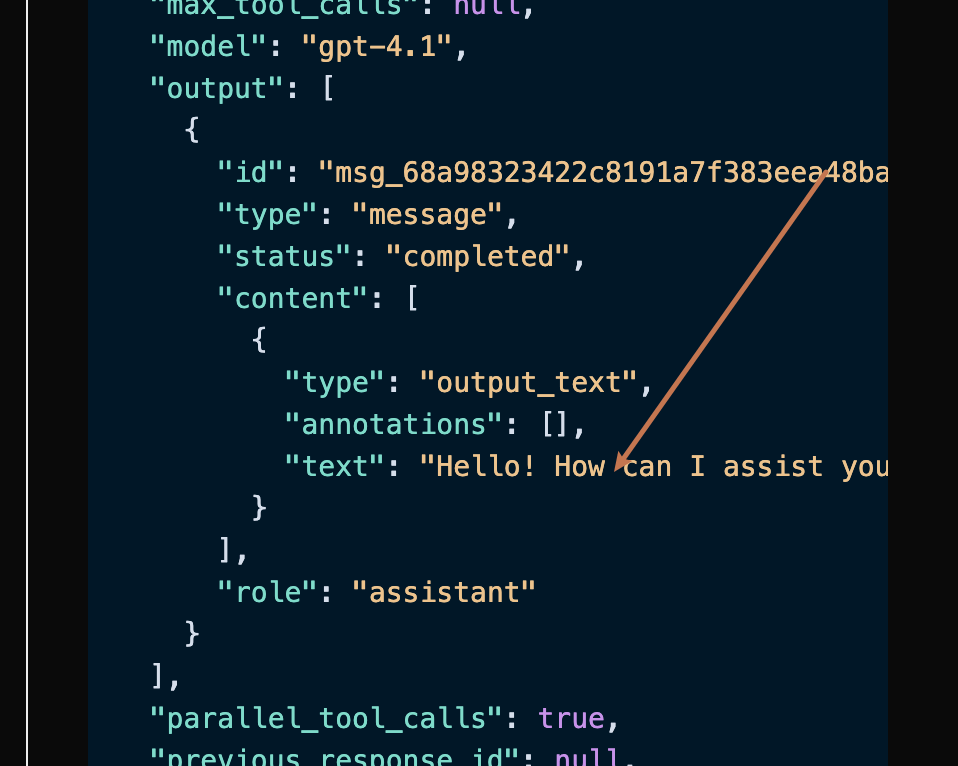
Se puede ver que el campo `content` dentro de `output` contiene el contenido específico de la respuesta de ChatGPT.
## Respuesta en streaming
Esta interfaz también admite respuestas en streaming, lo cual es muy útil para la integración con páginas web y permite que la página web logre un efecto de visualización carácter por carácter.
Si desea devolver la respuesta en streaming, puede cambiar el parámetro `stream ` en el encabezado de la solicitud a `true`.
La modificación se muestra en la imagen; sin embargo, el código de llamada debe tener los cambios correspondientes para admitir respuestas en streaming.
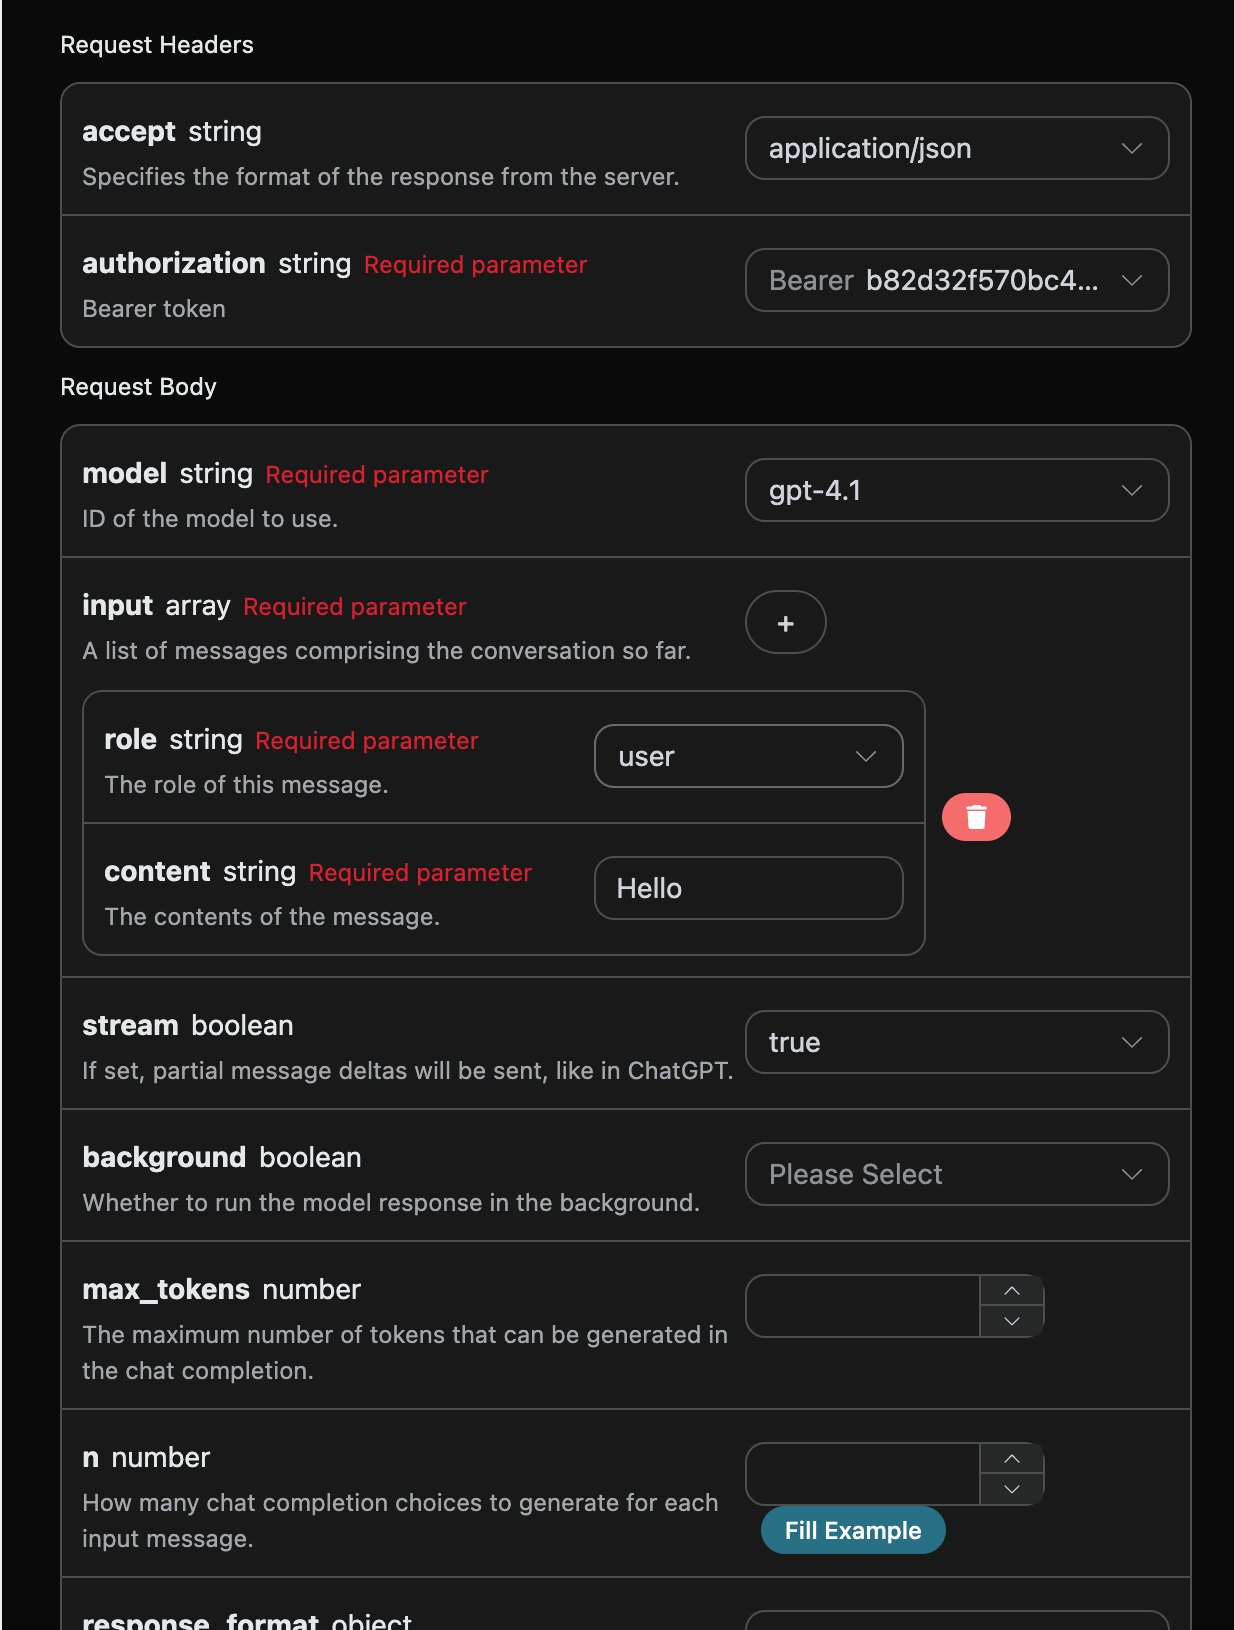
Después de modificar `stream` a `true`, la API devolverá los datos JSON correspondientes línea por línea; a nivel de código, necesitamos realizar las modificaciones correspondientes para obtener los resultados línea por línea.
Código de llamada de ejemplo en Python:
```python theme={null}
import requests
url = "https://api.acedata.cloud/openai/responses"
headers = {
"accept": "application/json",
"authorization": "Bearer {token}",
"content-type": "application/json"
}
payload = {
"model": "gpt-4.1",
"input": [{"role":"user","content":"Hello"}],
"stream": True
}
response = requests.post(url, json=payload, headers=headers)
print(response.text)
```
El efecto de salida es el siguiente:
```json theme={null}
data: {"type": "response.created", "sequence_number": 0, "response":
{"id": "resp_68a9837bb9bc8190b403947311db6faa0721186e8fbb89d0", "object": "response", "created_at": 1755939707, "status": "in_progress", "background": false, "content_filters": null, "error": null, "incomplete_details": null, "instructions": null, "max_output_tokens": null, "max_tool_calls": null, "model": "gpt-4.1-data", "output": [], "parallel_tool_calls": true, "previous_response_id": null, "prompt_cache_key": null, "reasoning": {"effort": null, "summary": null}, "safety_identifier": null, "service_tier": "auto", "store": true, "temperature": 1.0, "text": {"format": {"type": "text"}}, "tool_choice": "auto", "tools": [], "top_p": 1.0, "truncation": "disabled", "usage": null, "user": null, "metadata": {}}, "model": "gpt-4.1"}
data: {"type": "response.in_progress", "sequence_number": 1, "response": {"id": "resp_68a9837bb9bc8190b403947311db6faa0721186e8fbb89d0", "object": "response", "created_at": 1755939707, "status": "in_progress", "background": false, "content_filters": null, "error": null, "incomplete_details": null, "instructions": null, "max_output_tokens": null, "max_tool_calls": null, "model": "gpt-4.1-data", "output": [], "parallel_tool_calls": true, "previous_response_id": null, "prompt_cache_key": null, "reasoning": {"effort": null, "summary": null}, "safety_identifier": null, "service_tier": "auto", "store": true, "temperature": 1.0, "text": {"format": {"type": "text"}}, "tool_choice": "auto", "tools": [], "top_p": 1.0, "truncation": "disabled", "usage": null, "user": null, "metadata": {}}, "model": "gpt-4.1"}
data: {"type": "response.output_item.added", "sequence_number": 2, "output_index": 0, "item": {"id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "type": "message", "status": "in_progress", "content": [], "role": "assistant"}, "model": "gpt-4.1"}
data: {"type": "response.content_part.added", "sequence_number": 3, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "part": {"type": "output_text", "annotations": [], "text": ""}, "model": "gpt-4.1"}
data: {"type": "response.output_text.delta", "sequence_number": 4, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": "¡Hola", "model": "gpt-4.1"}
data: {"type": "response.output_text.delta", "sequence_number": 5, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": "!", "model": "gpt-4.1"}
data: {"type": "response.output_text.delta", "sequence_number": 6, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " ¿Cómo", "model": "gpt-4.1"}
data: {"type": "response.output_text.delta", "sequence_number": 7, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " puedo", "model": "gpt-4.1"}
data: {"type": "response.output_text.delta", "sequence_number": 8, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " ayudarte", "model": "gpt-4.1"}
data: {"type": "response.output_text.delta", "sequence_number": 9, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " hoy", "model": "gpt-4.1"}
data: {"type": "response.output_text.delta", "sequence_number": 10, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": "?", "model": "gpt-4.1"}
data: {"type": "response.output_text.delta", "sequence_number": 11, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " 😊", "model": "gpt-4.1"}
data: {"type": "response.output_text.done", "sequence_number": 14, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "text": "¡Hola! ¿Cómo puedo ayudarte hoy? 😊", "model": "gpt-4.1"}
data: {"type": "response.content_part.done", "sequence_number": 15, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "part": {"type": "output_text", "annotations": [], "text": "¡Hola! ¿Cómo puedo ayudarte hoy? 😊"}, "model": "gpt-4.1"}
data: {"type": "response.output_item.done", "sequence_number": 16, "output_index": 0, "item": {"id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "type": "message", "status": "completed", "content": [{"type": "output_text", "annotations": [], "text": "¡Hola! ¿Cómo puedo ayudarte hoy? 😊"}], "role": "assistant"}, "model": "gpt-4.1"}
data: {"type": "response.completed", "sequence_number": 17, "response":
{"id": "resp_68a9837bb9bc8190b403947311db6faa0721186e8fbb89d0", "object": "response", "created_at": 1755939707, "status": "completed", "background": false, "content_filters": null, "error": null, "incomplete_details": null, "instructions": null, "max_output_tokens": null, "max_tool_calls": null, "model": "gpt-4.1-data", "output": [{"id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "type": "message", "status": "completed", "content": [{"type": "output_text", "annotations": [], "text": "¡Hola! ¿Cómo puedo ayudarte hoy? 😊"}], "role": "assistant"}], "parallel_tool_calls": true, "previous_response_id": null, "prompt_cache_key": null, "reasoning": {"effort": null, "summary": null}, "safety_identifier": null, "service_tier": "default", "store": true, "temperature": 1.0, "text": {"format": {"type": "text"}}, "tool_choice": "auto", "tools": [], "top_p": 1.0, "truncation": "disabled", "usage": {"input_tokens": 8, "input_tokens_details": {"cached_tokens": 0}, "output_tokens": 11, "output_tokens_details": {"reasoning_tokens": 0}, "total_tokens": 19}, "user": null, "metadata": {}}, "model": "gpt-4.1"}
```
Se puede ver que hay muchos `data` en la respuesta, y el `delta` dentro de `data` es el contenido de respuesta más reciente, lo cual es consistente con el contenido presentado anteriormente. `delta` es el contenido de respuesta añadido, puede integrarlo en su sistema según el resultado. La respuesta en streaming utiliza `response.completed` o `response.incomplete` como estado final; el `usage` en el estado final es el uso final de tokens de esta solicitud y también la base de facturación.
Si el cliente desconecta la conexión antes de que llegue el estado final, esta solicitud se registra como cerrada por el cliente (499), y no se facturará utilizando la estimación local de tokens; si la conexión termina normalmente pero no se recibe el estado final ni el `usage` final, esta solicitud se registra como respuesta incompleta (502), y tampoco se facturará utilizando la estimación de tokens. Cuando se encuentre con estas dos situaciones, vuelva a iniciar la solicitud.
El resultado `data` devuelto tiene varios campos en total, que se presentan a continuación:
* `item_id`, el ID de la tarea de conversación generada esta vez, utilizado para identificar de forma única esta tarea de conversación.
* `type`, el tipo de la tarea de Responses de conversación generada esta vez.
* `model `, el modelo seleccionado del sitio web oficial de OpenAI ChatGPT.
* `delta`, la información de respuesta proporcionada por ChatGPT para las palabras de consulta.
JavaScript también es compatible, por ejemplo, el código de llamada en streaming de Node.js es el siguiente:
```javascript theme={null}
const options = {
method: "post",
headers: {
accept: "application/json",
authorization: "Bearer b82d32f570bc434d9ba9923aa0e7dce0",
"content-type": "application/json",
},
body: JSON.stringify({
model: "gpt-4.1",
input: [{ role: "user", content: "Hello" }],
stream: true,
}),
};
fetch("https://api.acedata.cloud/openai/responses", options)
.then((response) => response.json())
.then((response) => console.log(response))
.catch((err) => console.error(err));
```
Código de ejemplo de Java:
```java theme={null}
JSONObject jsonObject = new JSONObject();
jsonObject.put("model", "gpt-4.1");
jsonObject.put("input", [{"role":"user","content":"Hello"}]);
jsonObject.put("stream", true);
MediaType mediaType = "application/json; charset=utf-8".toMediaType();
RequestBody body = jsonObject.toString().toRequestBody(mediaType);
Request request = new Request.Builder()
.url("https://api.acedata.cloud/openai/responses")
.post(body)
.addHeader("accept", "application/json")
.addHeader("authorization", "Bearer b82d32f570bc434d9ba9923aa0e7dce0")
.addHeader("content-type", "application/json")
.build();
OkHttpClient client = new OkHttpClient();
Response response = client.newCall(request).execute();
System.out.print(response.body!!.string())
```
Otros lenguajes pueden adaptarse por su cuenta, el principio es el mismo.
## Conversación de múltiples turnos
Si desea integrar la función de conversación de múltiples turnos, necesita cargar múltiples palabras de consulta en el campo `input`; un ejemplo específico de múltiples palabras de consulta se muestra en la siguiente imagen:
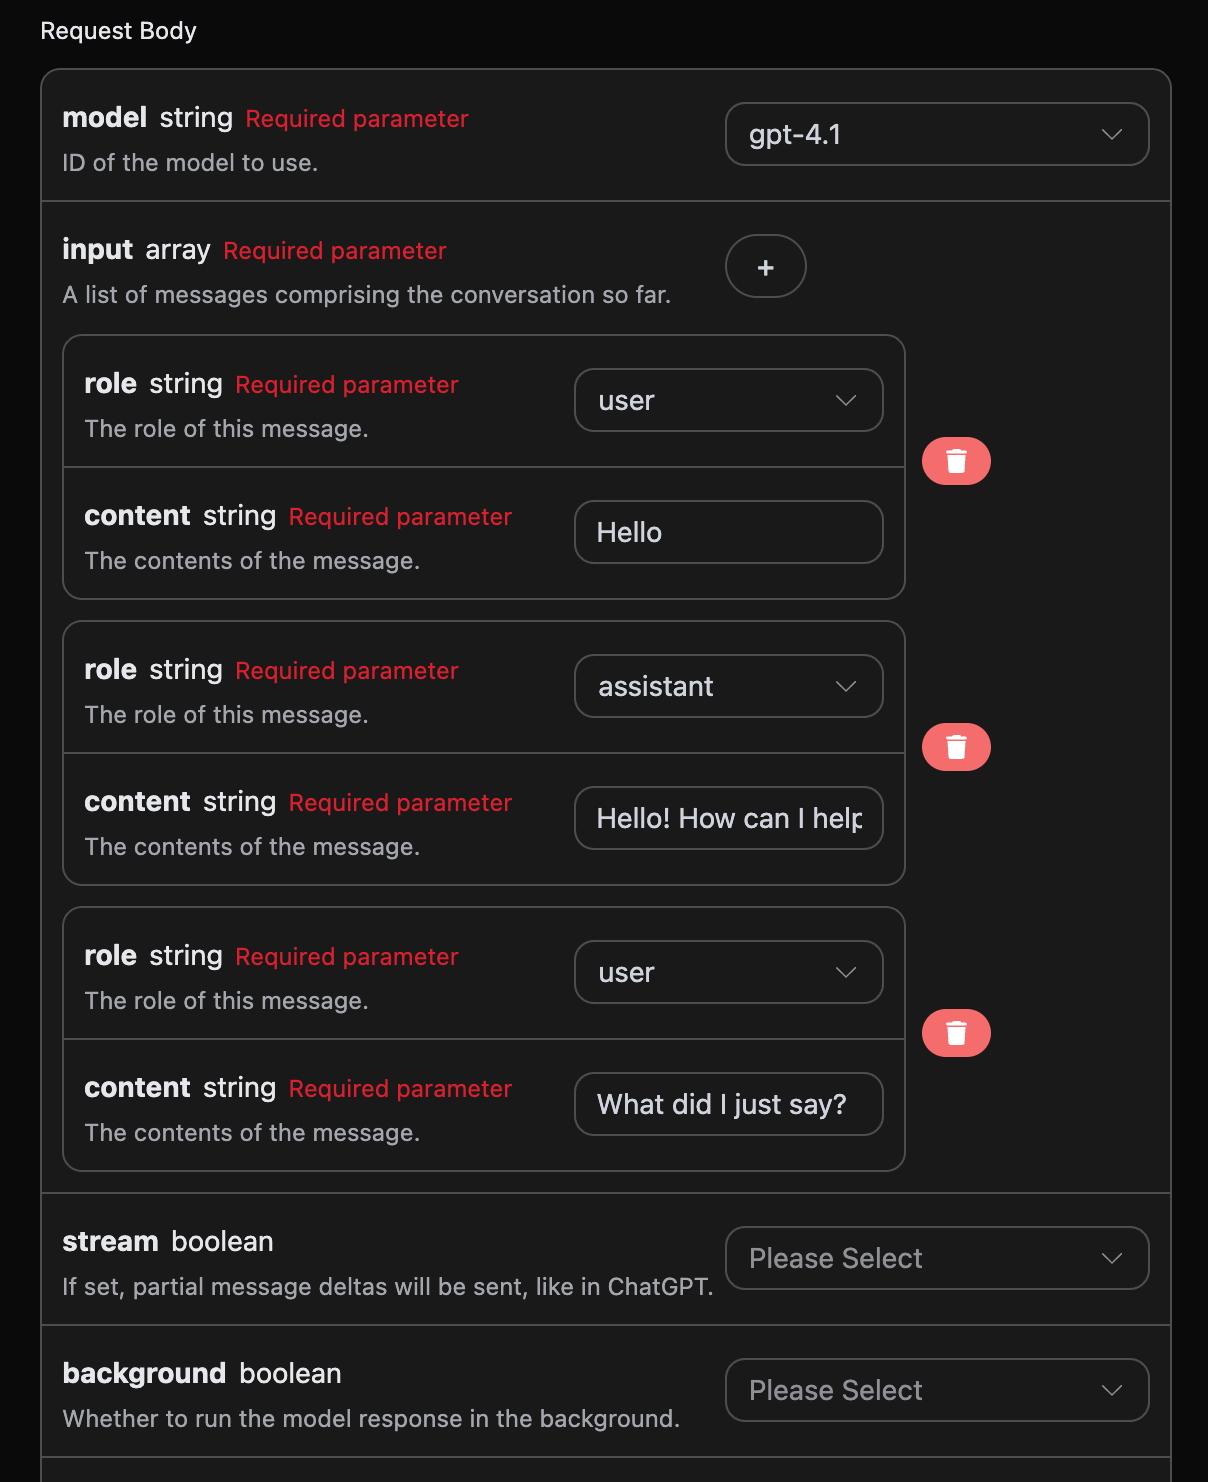
Código de llamada de ejemplo en Python:
```python theme={null}
import requests
url = "https://api.acedata.cloud/openai/responses"
headers = {
"accept": "application/json",
"authorization": "Bearer {token}",
"content-type": "application/json"
}
payload = {
"model": "gpt-4.1",
"input": [{"role":"user","content":"Hello"},{"role":"assistant","content":"Hello! How can I help you today? 😊"},{"role":"user","content":"What did I just say?"}]
}
response = requests.post(url, json=payload, headers=headers)
print(response.text)
```
Al cargar múltiples palabras de consulta, se puede implementar fácilmente una conversación de múltiples turnos y se puede obtener la siguiente respuesta:
```json theme={null}
{
"id": "resp_68a989c03c508191a1dd82ce2e37e88a0932a4328c0a5d5b",
"object": "response",
"created_at": 1755941312,
"status": "completed",
"background": false,
"content_filters": null,
"error": null,
"incomplete_details": null,
"instructions": null,
"max_output_tokens": null,
"max_tool_calls": null,
"model": "gpt-4.1",
"output": [
{
"id": "msg_68a989c092e4819189821a9eb8247e1e0932a4328c0a5d5b",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"annotations": [],
"text": "You just said \"Hello.\" \n\nWould you like to continue the conversation or ask a question?"
}
],
"role": "assistant"
}
],
"parallel_tool_calls": true,
"previous_response_id": null,
"prompt_cache_key": null,
"reasoning": {
"effort": null,
"summary": null
},
"safety_identifier": null,
"service_tier": "default",
"store": true,
"temperature": 1,
"text": {
"format": {
"type": "text"
}
},
"tool_choice": "auto",
"tools": [],
"top_p": 1,
"truncation": "disabled",
"usage": {
"input_tokens": 32,
"input_tokens_details": {
"cached_tokens": 0
},
"output_tokens": 20,
"output_tokens_details": {
"reasoning_tokens": 0
},
"total_tokens": 52
},
"user": null,
"metadata": {}
}
```
Se puede ver que la información incluida en `output` es consistente con el contenido del uso básico; esto incluye el contenido específico de la respuesta de ChatGPT a múltiples conversaciones, de esta manera se pueden responder las preguntas correspondientes según el contenido de múltiples conversaciones.
## Modelo visual
gpt-4o es un modelo de lenguaje grande multimodal desarrollado por OpenAI; añade capacidades de comprensión visual sobre la base de GPT-4. Este modelo puede procesar simultáneamente entradas de texto e imágenes, logrando comprensión y generación multimodal.
El procesamiento de texto utilizando el modelo gpt-4o es coherente con el contenido básico de uso mencionado anteriormente. A continuación, se presentará brevemente cómo utilizar la capacidad de procesamiento de imágenes del modelo.
La capacidad de procesamiento de imágenes del modelo gpt-4o se utiliza principalmente añadiendo un campo `type` sobre la base del contenido original de `content`. Mediante este campo se puede saber si lo que se carga es texto o una imagen, para así utilizar la capacidad de procesamiento de imágenes del modelo gpt-4o. A continuación se describe principalmente cómo llamar a esta función mediante Curl y Python.
* Método de script Curl
```
curl -X POST 'https://api.acedata.cloud/openai/responses' \
-H 'accept: application/json' \
-H 'authorization: Bearer {token}' \
-H 'content-type: application/json' \
-d '{
"model": "gpt-4.1",
"input": [
{
"role": "user",
"content": [
{"type": "input_text", "text": "what is in this image?"},
{
"type": "input_image",
"image_url": "https://cdn.acedata.cloud/e724d7f13d.png"
}
]
}
]
}'
```
* Método de script Python
```python theme={null}
import requests
url = "https://api.acedata.cloud/openai/chat/completions"
headers = {
"accept": "application/json",
"authorization": "Bearer {token}",
"content-type": "application/json"
}
payload = {
"model": "gpt-4.1",
"input": [
{
"role": "user",
"content": [
{"type": "input_text", "text": "what is in this image?"},
{
"type": "input_image",
"image_url": "https://cdn.acedata.cloud/e724d7f13d.png"
}
]
}
]
}
response = requests.post(url, json=payload, headers=headers)
print(response.text)
```
Luego se puede obtener el siguiente resultado. La información de los campos del resultado es coherente con la mencionada anteriormente, específicamente de la siguiente manera:
```json theme={null}
{
"id": "resp_68a98c1bb784819e9b9f622007a2d37602483949012d2193",
"object": "response",
"created_at": 1755941915,
"status": "completed",
"background": false,
"content_filters": null,
"error": null,
"incomplete_details": null,
"instructions": null,
"max_output_tokens": null,
"max_tool_calls": null,
"model": "gpt-4.1",
"output": [
{
"id": "msg_68a98c1dd030819e97fb71e6ee33f5a902483949012d2193",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"annotations": [],
"text": "This image shows a scenic path, possibly a boardwalk, running through a lush green field or meadow. The sky above is bright blue with some white clouds, and there are green trees and bushes in the background. It looks like a peaceful nature scene, possibly in a park, wetland, or prairie area. The image conveys a sense of tranquility and natural beauty."
}
],
"role": "assistant"
}
],
"parallel_tool_calls": true,
"previous_response_id": null,
"prompt_cache_key": null,
"reasoning": {
"effort": null,
"summary": null
},
"safety_identifier": null,
"service_tier": "default",
"store": true,
"temperature": 1,
"text": {
"format": {
"type": "text"
}
},
"tool_choice": "auto",
"tools": [],
"top_p": 1,
"truncation": "disabled",
"usage": {
"input_tokens": 1118,
"input_tokens_details": {
"cached_tokens": 0
},
"output_tokens": 75,
"output_tokens_details": {
"reasoning_tokens": 0
},
"total_tokens": 1193
},
"user": null,
"metadata": {}
}
```
Se puede ver que el contenido de la respuesta se basa en la imagen. Por lo tanto, mediante los dos métodos anteriores se pueden utilizar fácilmente las capacidades de procesamiento de texto e imágenes del modelo gpt-4.1.
Además de gpt-4.1, existe un modelo de menor costo llamado gpt-4o-mini. gpt-4o-mini es la última generación de modelos de lenguaje grandes desarrollada por OpenAI. No solo tiene una velocidad de respuesta rápida, sino que también es más económico y admite multimodalidad. Para el uso de la función vision, se puede consultar el contenido anterior sobre el uso del modelo gpt-4.1.
## Creación del modelo de procesamiento de archivos
Ejemplo de solicitud:
```json theme={null}
{
"model": "gpt-4.1",
"input": [
{
"role": "user",
"content": [
{ "type": "input_text", "text": "what is in this file?" },
{
"type": "input_file",
"file_url": "https://cdn.acedata.cloud/assets/examples/fish/64adc04b-c196-4a0f-9070-222ba101ce6c-fc50de38c165.wav"
}
]
}
]
}
```
Resultado de ejemplo:
```json theme={null}
{
"id": "resp_68a98d7bb57c819ba25424f5f50a29a300a1af2af822e88a",
"object": "response",
"created_at": 1755942267,
"status": "completed",
"background": false,
"content_filters": null,
"error": null,
"incomplete_details": null,
"instructions": null,
"max_output_tokens": null,
"max_tool_calls": null,
"model": "gpt-4.1",
"output": [
{
"id": "msg_68a98d7d9b80819b9b0f09b7bcd00bf900a1af2af822e88a",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"annotations": [],
"text": "The file you posted contains the **2024 annual letter to shareholders from Berkshire Hathaway Inc.**, written by Warren E. Buffett, Chairman of the Board. This document is a comprehensive communication that is typically included in Berkshire's annual report to shareholders.\n\n### What's Inside the File:\n\n#### 1. **Chairman's Letter to Shareholders**\n - **Introduction & Philosophy:** Warren Buffett discusses the purpose of the annual report, Berkshire Hathaway’s communication style, and his philosophy for transparency and candid discussion of both successes and failures.\n - **Discussion of Mistakes:** He talks openly about the mistakes made in capital allocation and personnel decisions, emphasizing the importance of admitting errors and acting promptly to correct them.\n - **Succession Comments:** Buffett references his eventual retirement, and that Greg Abel will succeed him as CEO and writer of these letters.\n - **Anecdotal Story:** The story of Pete Liegl, founder of Forest River (an RV manufacturer acquired by Berkshire), is told to illustrate management philosophy and business decision-making.\n\n#### 2. **2024 Business and Financial Performance**\n - **Key Results:** Summary of how Berkshire performed financially in 2024 vs. 2023, including operating earnings breakdown by business segments such as insurance, BNSF railroad, and energy.\n - **Insurance Business:** GEICO and the property-casualty insurance division had a standout year, with commentary on the industry and how Berkshire approaches insurance risk, pricing, and investment of insurance \"float.\"\n - **Investments:** Discussion on Berkshire’s strategy of owning both full businesses and partial stakes (marketable securities) in large companies (e.g., Apple, American Express, Coca-Cola), and its deployment of cash.\n - **Taxes:** Reference to Berkshire breaking records in corporate tax payments ($26.8 billion to the IRS in 2024).\n\n#### 3. **Long-term Philosophy & Capitalism Commentary**\n - **On Equities:** Buffett explains why Berkshire prioritizes ownership of businesses (equities) over cash or bonds, and why the company favors long-term investments.\n - **On Capitalism:** There’s a reflection on America’s growth, the role of capitalism, savings, and capital allocation in the nation’s success, and a nod to the importance of maintaining a stable currency.\n\n#### 4. **Japanese Investments**\n - **Update on Japanese Holdings:** Berkshire’s growing investments in five Japanese trading companies, and the positive view of their management and governance.\n\n#### 5. **Berkshire Hathaway Annual Meeting**\n - **Annual Gathering Info:** Details about the annual meeting in Omaha, including social events, book sales, and charitable initiatives related to the meeting.\n - **Personal Stories:** Personal anecdotes involving Buffett’s family, (including his sister Bertie), to add a human touch to the letter.\n\n#### 6. **Performance Tables**\n - **Berkshire vs S&P 500 (1965-2024):** Two detailed tables showing annual percentage change in Berkshire’s share price vs. total return for the S&P 500, as well as long-term compounded and overall gains.\n\n---\n\n### In Summary\n\nThis file is the **2024 Berkshire Hathaway annual letter to shareholders**, primarily written by Warren Buffett. It covers business performance, management philosophy, investment strategy, earnings and taxes, insurance operations, significant holdings, capital allocation, succession updates, and more. Tables show a remarkable outperformance of Berkshire Hathaway vs. the S&P 500 over nearly six decades – a central point of pride in the letter.\n\nIf you want specifics from any particular section, let me know!"
}
],
"role": "assistant"
}
],
"parallel_tool_calls": true,
"previous_response_id": null,
"prompt_cache_key": null,
"reasoning": {
"effort": null,
"summary": null
},
"safety_identifier": null,
"service_tier": "default",
"store": true,
"temperature": 1,
"text": {
"format": {
"type": "text"
}
},
"tool_choice": "auto",
"tools": [],
"top_p": 1,
"truncation": "disabled",
"usage": {
"input_tokens": 8438,
"input_tokens_details": {
"cached_tokens": 0
},
"output_tokens": 731,
"output_tokens_details": {
"reasoning_tokens": 0
},
"total_tokens": 9169
},
"user": null,
"metadata": {}
}
```
Se puede ver que también hemos procesado los archivos de entrada, y el resultado es similar al anterior.
## Manejo de errores
Al llamar a la API, si se produce un error, la API devolverá el código de error y la información correspondientes. Por ejemplo:
* `400 token_mismatched`:Solicitud incorrecta, posiblemente debido a parámetros faltantes o no válidos.
* `400 api_not_implemented`:Solicitud incorrecta, posiblemente debido a parámetros faltantes o no válidos.
* `401 invalid_token`:No autorizado, token de autorización no válido o faltante.
* `429 too_many_requests`:Demasiadas solicitudes, ha excedido el límite de tasa.
* `500 api_error`:Error interno del servidor, algo salió mal en el servidor.
### Ejemplo de respuesta de error
```
{
"success": false,
"error": {
"code": "api_error",
"message": "fetch failed"
},
"trace_id": "2cf86e86-22a4-46e1-ac2f-032c0f2a4e89"
}
```
## Conclusión
A través de este documento, ya ha aprendido cómo utilizar la API de OpenAI Responses para implementar fácilmente la funcionalidad oficial de creación de Responses de OpenAI. Esperamos que este documento pueda ayudarle a integrar y utilizar mejor esta API. Si tiene alguna pregunta, no dude en ponerse en contacto con nuestro equipo de soporte técnico.