Google Gemini es un sistema de conversación con IA muy potente; solo con introducir un prompt, puede generar respuestas fluidas y naturales en apenas unos segundos. Gemini puede proporcionar una asistencia inteligente sorprendente, mejorando enormemente la eficiencia laboral y la creatividad humanas. Este documento presenta principalmente el flujo de uso de las operaciones de Gemini Chat Completion API; utilizándolo podemos usar fácilmente la función de conversación del Gemini oficial.

Proceso de solicitud

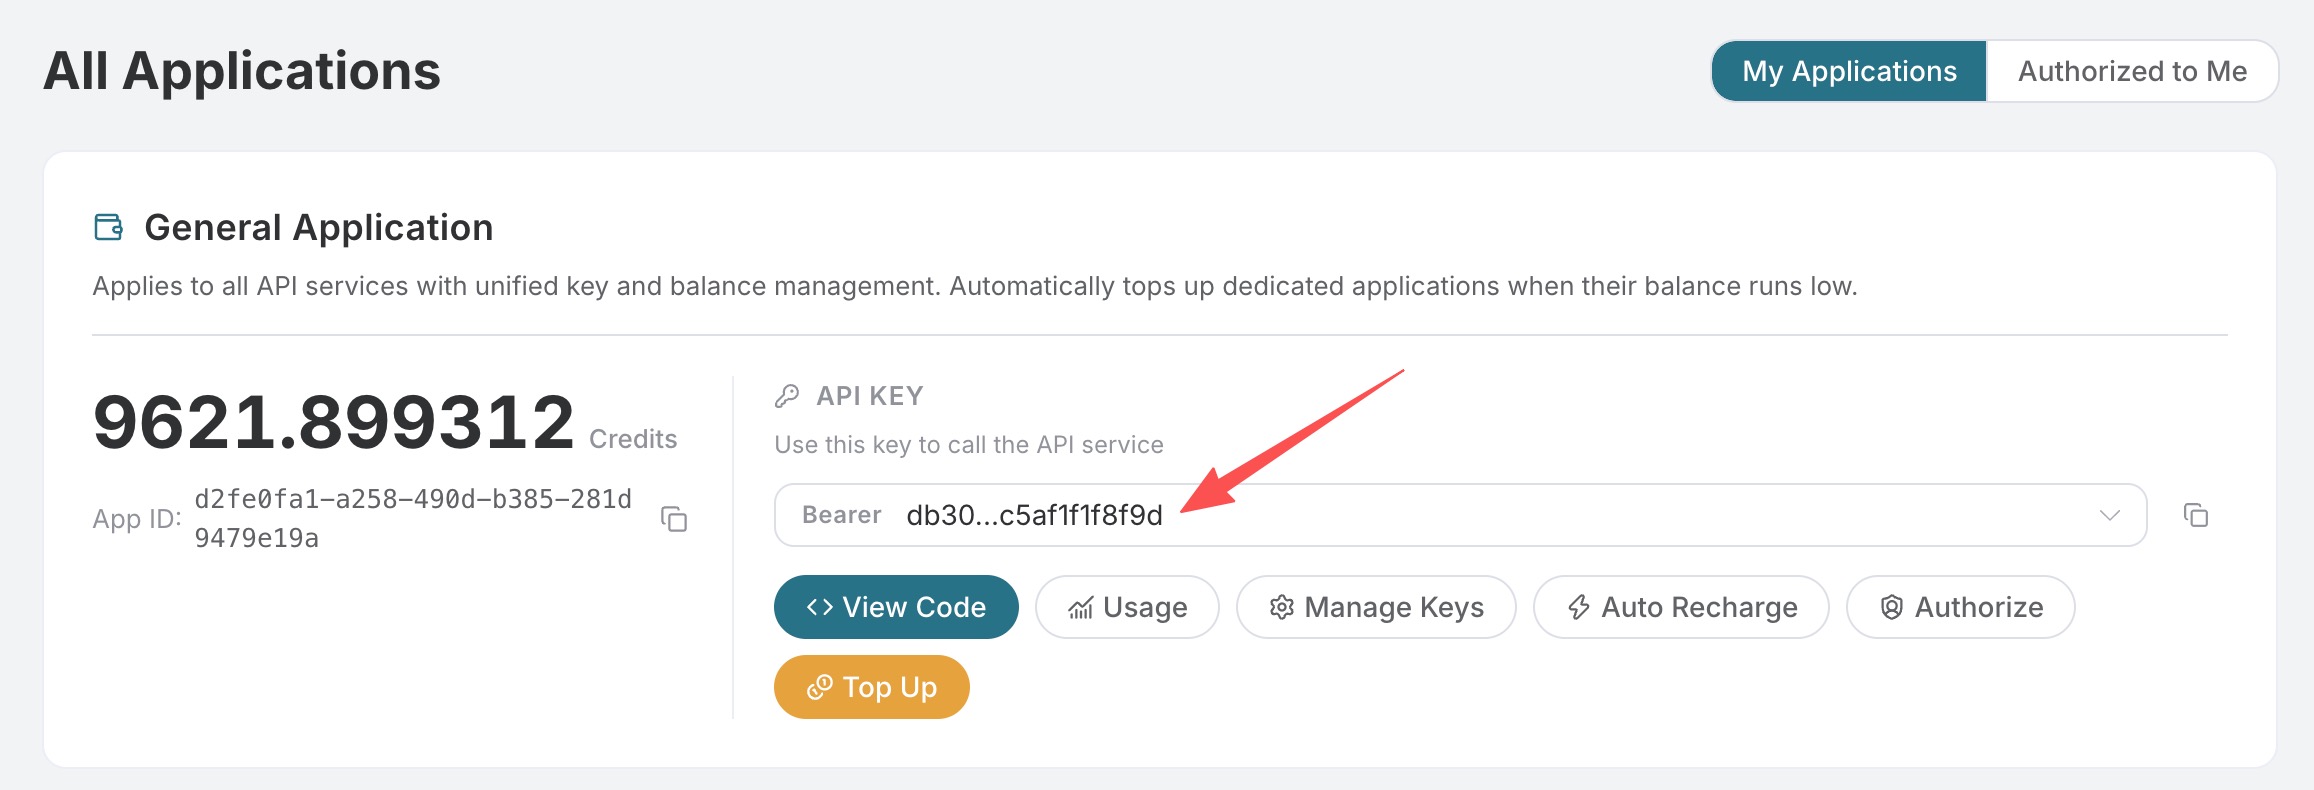
Para utilizar Gemini Chat Completion API, primero obtenga su API Token en la Consola de Ace Data Cloud y guárdelo como respaldo. Si aún no ha iniciado sesión o no se ha registrado, será redirigido automáticamente a la página de inicio de sesión para invitarle a registrarse e iniciar sesión; al completarlo, regresará automáticamente a la página actual. Un API Token puede invocar todos los servicios de la plataforma, sin necesidad de solicitar uno por separado para cada servicio. La primera solicitud incluirá crédito gratuito para una experiencia sin costo; cuando el crédito sea insuficiente, puede recargar saldo general en la consola.
📘 Documentación completa: Gemini Chat Completion API →

Uso básico

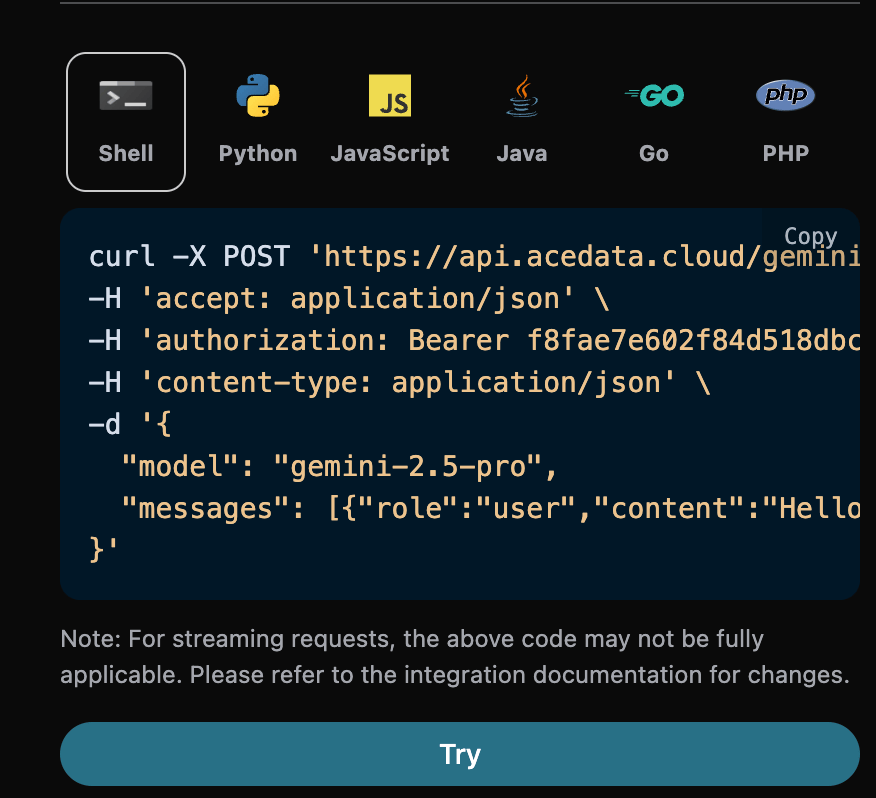
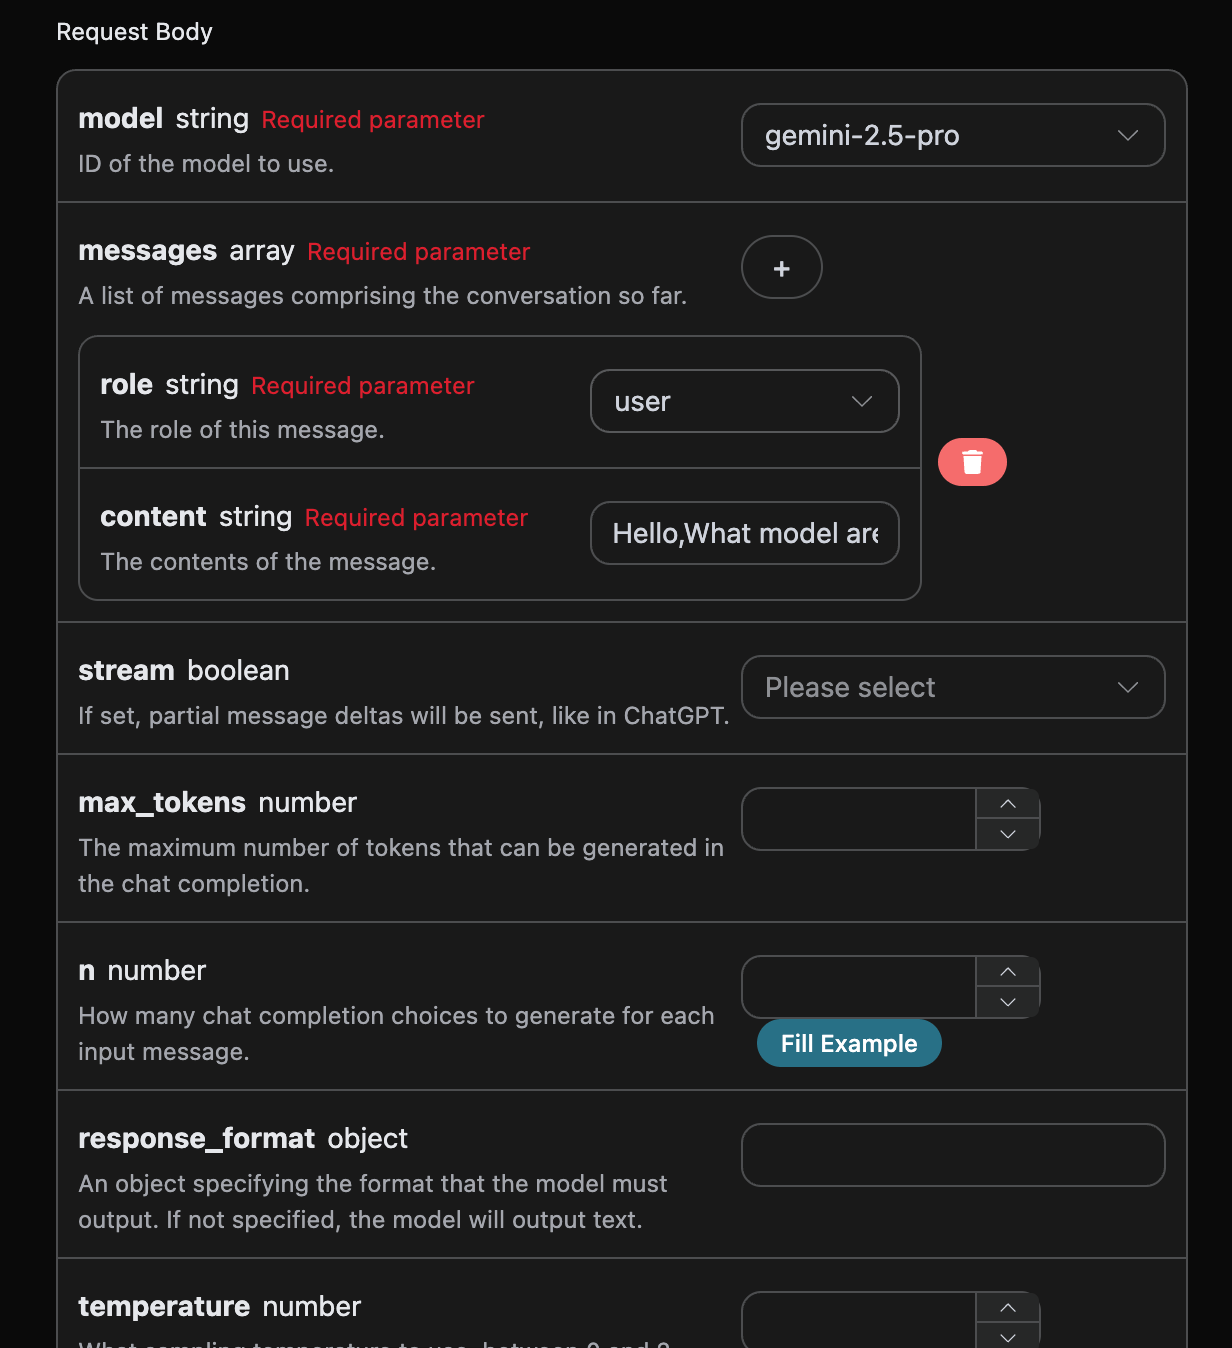
A continuación, puede completar el contenido correspondiente en la interfaz, como se muestra en la imagen:

Al utilizar esta interfaz por primera vez, necesitamos completar al menos tres contenidos: uno es authorization, que puede seleccionarse directamente en la lista desplegable. Otro parámetro es model; model es la categoría de modelo oficial de Gemini que elegimos utilizar, y los modelos disponibles se basan en la enumeración model de la documentación de la interfaz. El último parámetro es messages; messages es el arreglo de prompts que introducimos, es un arreglo que indica que se pueden cargar varios prompts al mismo tiempo, cada prompt contiene role y content, donde role representa el rol del interlocutor; proporcionamos tres identidades: user, assistant, system. El otro content es el contenido específico de nuestra pregunta. Al mismo tiempo, puede notar que a la derecha se genera el código de llamada correspondiente; puede copiar el código y ejecutarlo directamente, o también puede hacer clic directamente en el botón «Try» para realizar pruebas.

Consejo: la serie flash de gemini-3.x son modelos de razonamiento, que primero consumirán reasoning tokens; establezca max_tokens por encima de 512; de lo contrario, podría devolver solo contenido vacío. gemini-3.8-flash es el modelo Flash recomendado actualmente, admite hasta 1 millón de Token de contexto, entrada de imágenes, llamadas a herramientas y respuestas en streaming; actualmente se invoca mediante la interfaz Chat Completions.
Después de la llamada, descubrimos que el resultado devuelto es el siguiente:
El resultado devuelto tiene varios campos, que se presentan a continuación:
  • id, el ID generado para esta tarea de conversación, utilizado para identificar de forma única esta tarea de conversación.
  • model , el modelo oficial de Gemini seleccionado.
  • choices, la información de respuesta proporcionada por Gemini para el prompt.
  • usage : información estadística sobre los token de esta sesión de preguntas y respuestas.
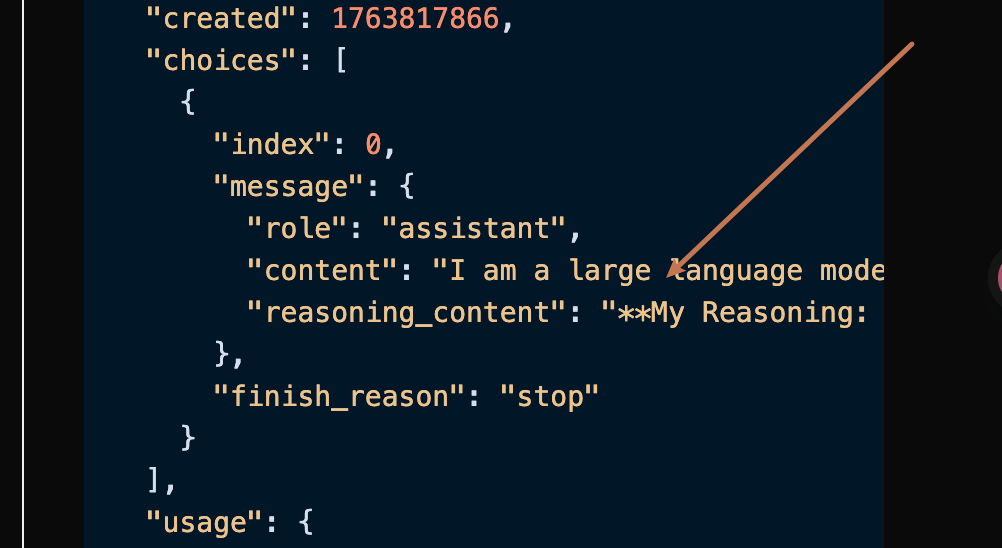
Entre ellos, choices contiene la información de respuesta de Gemini, y los choices dentro de él contienen la información específica de la respuesta de Gemini, como se puede ver en la imagen.

Se puede ver que el campo content dentro de choices contiene el contenido específico de la respuesta de Gemini.

Comprensión de imágenes (entrada multimodal)

Gemini es un modelo multimodal nativo que puede «ver imágenes» directamente. Para pasar una imagen, cambie el content de un mensaje de una cadena a un arreglo de bloques de contenido, y coloque simultáneamente bloques text y bloques image_url en el arreglo; esto es completamente consistente con OpenAI y con el formato compatible con OpenAI de Gemini oficial. image_url.url admite dos formatos:
  • URI data: base64 (recomendado, el más estable): el formato es data:<tipo de medio>;base64,<datos>, por ejemplo data:image/jpeg;base64,/9j/4AAQ.... El tipo de medio (MIME) ya está escrito en el prefijo data:, por lo que no se necesita ni existe un campo media_type independiente.
  • URL de imagen accesible públicamente: por ejemplo https://cdn.acedata.cloud/4hfydw.jpg.
Tipos de imagen compatibles: png, jpeg, webp, heic, heif. Código de llamada de ejemplo en Python (URI de datos base64):
También puede pasar directamente una URL de imagen accesible públicamente:
💡 image_url solo acepta el campo url (el valor puede ser una URL de imagen o un URI data: de base64), así como el campo opcional detail. No pase media_type: ese es el campo de imagen de Anthropic Claude y no pertenece al formato image_url de OpenAI / Gemini.

Respuesta en streaming

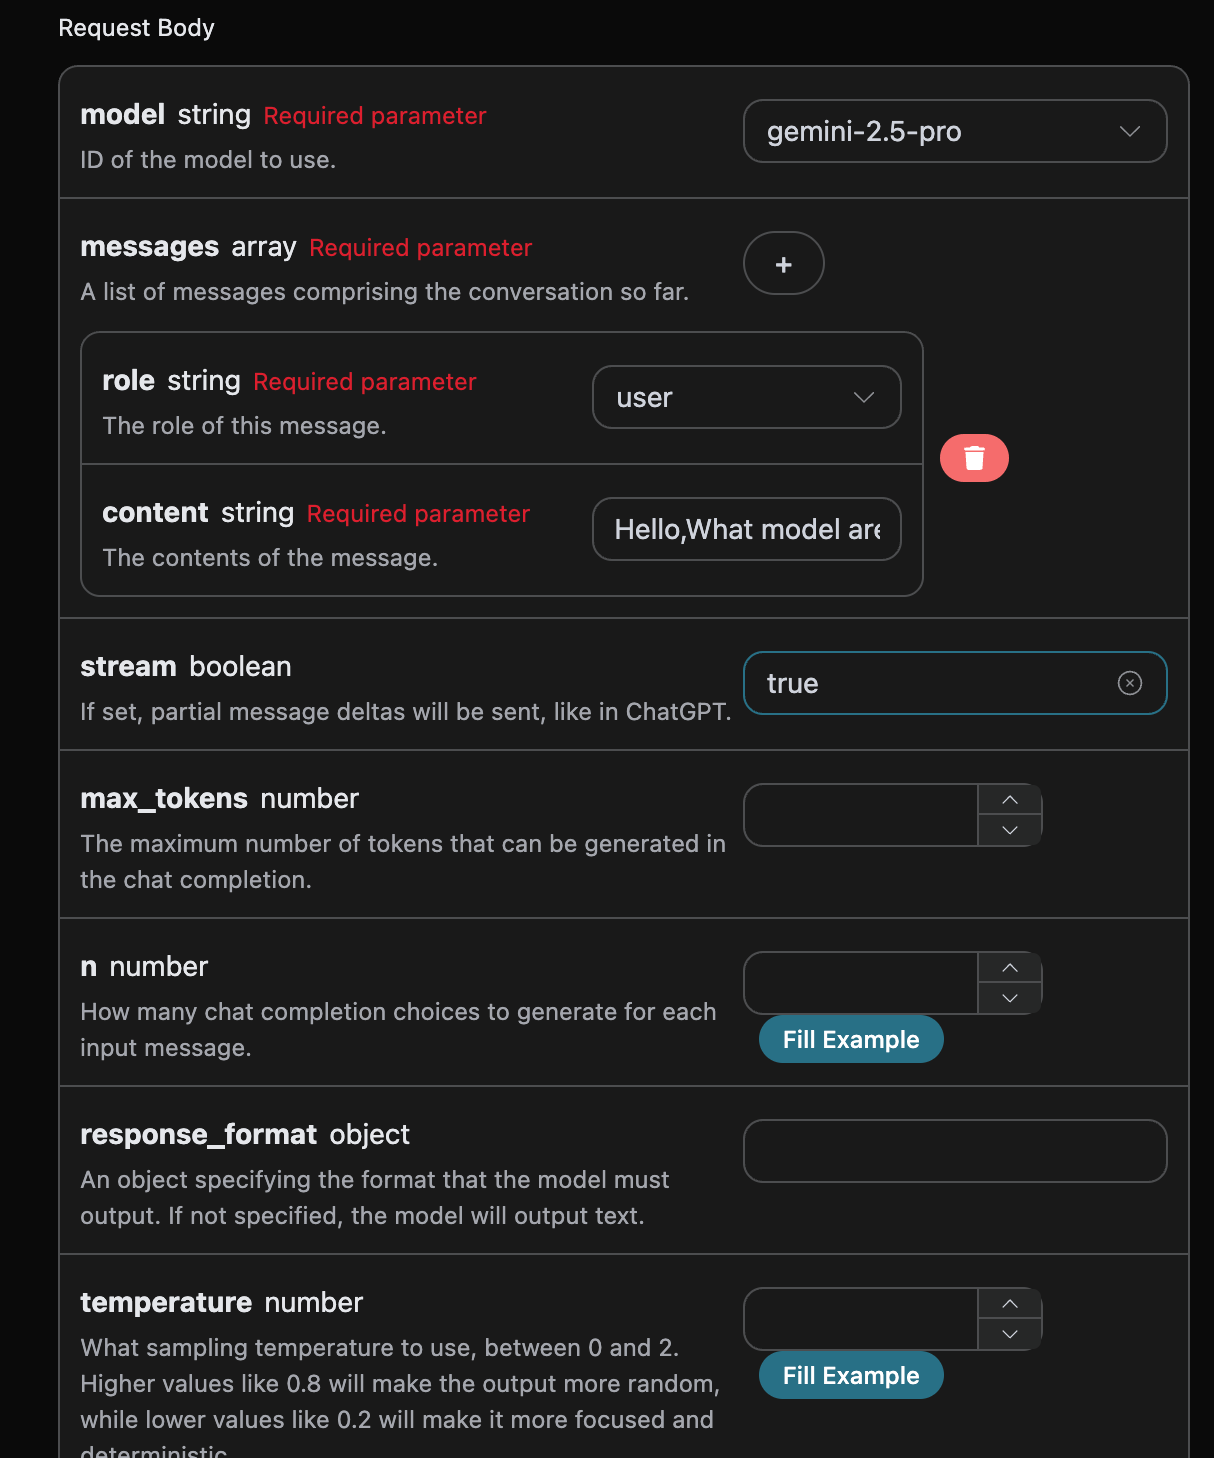
Esta interfaz también admite respuestas en streaming, lo que resulta muy útil para la integración web y permite que la página web implemente un efecto de visualización palabra por palabra. Si desea devolver la respuesta en streaming, puede cambiar el parámetro stream en los encabezados de la solicitud a true. Modifíquelo como se muestra en la imagen, pero el código de llamada debe tener los cambios correspondientes para poder admitir respuestas en streaming.

Después de modificar stream a true, la API devolverá los datos JSON correspondientes línea por línea; a nivel de código, debemos realizar las modificaciones correspondientes para obtener los resultados línea por línea. Código de llamada de ejemplo en Python:
El resultado de salida es el siguiente:
Puede ver que hay muchos data en la respuesta; los choices dentro de data son el contenido más reciente de la respuesta, coherente con el contenido presentado anteriormente. choices es el contenido de respuesta añadido; puede integrarlo en su sistema según el resultado. Al mismo tiempo, el final de la respuesta en streaming se determina según el contenido de data; si el contenido es [DONE], significa que la respuesta en streaming ha finalizado por completo. El resultado data devuelto tiene varios campos, que se presentan a continuación:
  • id, genera el ID de esta tarea de conversación, utilizado para identificar de forma única esta tarea de conversación.
  • model , el modelo oficial de Gemini seleccionado.
  • choices, la información de respuesta proporcionada por Gemini para las palabras de consulta.
JavaScript también es compatible, por ejemplo, el código de llamada en flujo de Node.js es el siguiente:
Código de ejemplo de Java:
Otros lenguajes pueden reescribirse por cuenta propia, el principio es el mismo.

Conversación de múltiples turnos

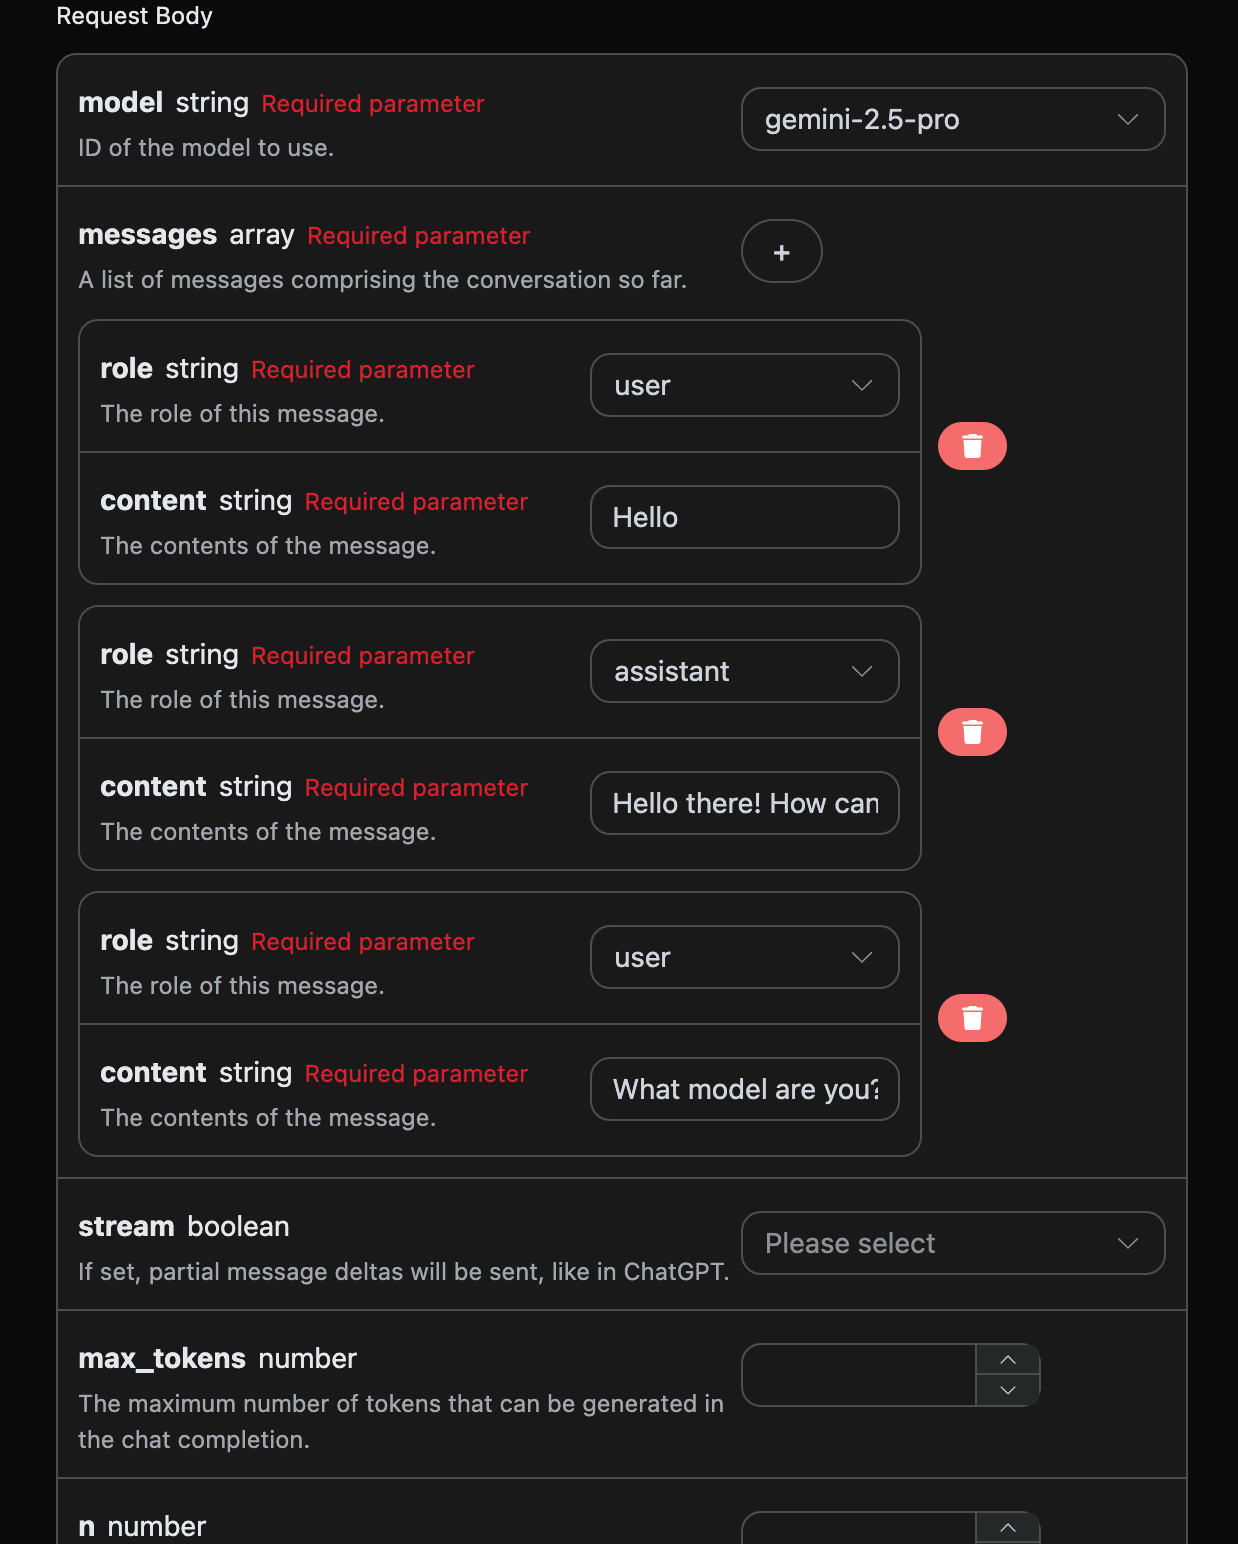
Si desea integrar la función de conversación de múltiples turnos, debe cargar múltiples palabras de consulta en el campo messages; el ejemplo específico de múltiples palabras de consulta se muestra en la siguiente imagen:

Código de llamada de ejemplo de Python:
Al cargar múltiples palabras de consulta, se puede implementar fácilmente una conversación de múltiples turnos y se puede obtener la siguiente respuesta:
Se puede ver que la información incluida en choices es coherente con el contenido del uso básico; esta incluye el contenido específico de las respuestas de Gemini para múltiples conversaciones, de modo que se pueden responder las preguntas correspondientes según el contenido de múltiples conversaciones.

Modelo multimodal Gemini-3.0

Ejemplo de solicitud:
Resultado de ejemplo:
Por supuesto, también puedes enviar enlaces de video; la entrada específica es la siguiente:
Resultado de ejemplo:
De lo anterior se puede ver que el modelo Gemini 3.0 puede admitir comprensión multimodal.

Modelo multimodal Gemini-3.1

gemini-3.1-pro-preview es el ID oficial actual del modelo Gemini 3.1 Pro, admite entradas multimodales como texto, imágenes y videos, y es adecuado para tareas complejas de razonamiento, codificación y comprensión. Ejemplo de solicitud:
Gemini 3.1 Pro también admite comprensión de video:
El formato de respuesta es coherente con Gemini 3.0 Pro; consulta la explicación en la sección del modelo multimodal Gemini-3.0 anterior para más detalles.

Manejo de errores

Al llamar a la API, si se produce un error, la API devolverá el código de error y la información correspondientes. Por ejemplo:
  • 400 token_mismatched: Solicitud incorrecta, posiblemente debido a parámetros faltantes o no válidos.
  • 400 api_not_implemented: Solicitud incorrecta, posiblemente debido a parámetros faltantes o no válidos.
  • 401 invalid_token: No autorizado, token de autorización no válido o faltante.
  • 429 too_many_requests: Demasiadas solicitudes, has excedido el límite de frecuencia.
  • 500 api_error: Error interno del servidor, algo salió mal en el servidor.

Ejemplo de respuesta de error

Conclusión

A través de este documento, ya ha aprendido cómo utilizar la API de Gemini Chat Completion para implementar fácilmente la función de conversación del Gemini oficial. Esperamos que este documento pueda ayudarle a integrar y utilizar mejor esta API. Si tiene alguna pregunta, no dude en contactar con nuestro equipo de soporte técnico.