上表のSuno は現在、lyricとstyleの制限は、カスタムモード(customがtrue)における上限である。カスタムではないインスピレーションモード(customがfalse)ではpromptのみを入力し、その長さの上限は 500 文字(各モデル共通)である。
chirp-v6、chirp-v6-wild、および chirp-v6-mini をサポートしている。chirp-v6 の使用を推奨する;旧モデル名も引き続き互換性がある。
しかし Suno 公式は API を提供しておらず、AceDataCloud は Suno の API 一式を提供し、Suno 公式との連携をシミュレートしており、必要な音楽を便利かつ迅速に生成できる。
申請と使用
Suno Audios Generation API を使用するには、まず Ace Data Cloud コンソール であなたの API Token を取得し、予備として保存する。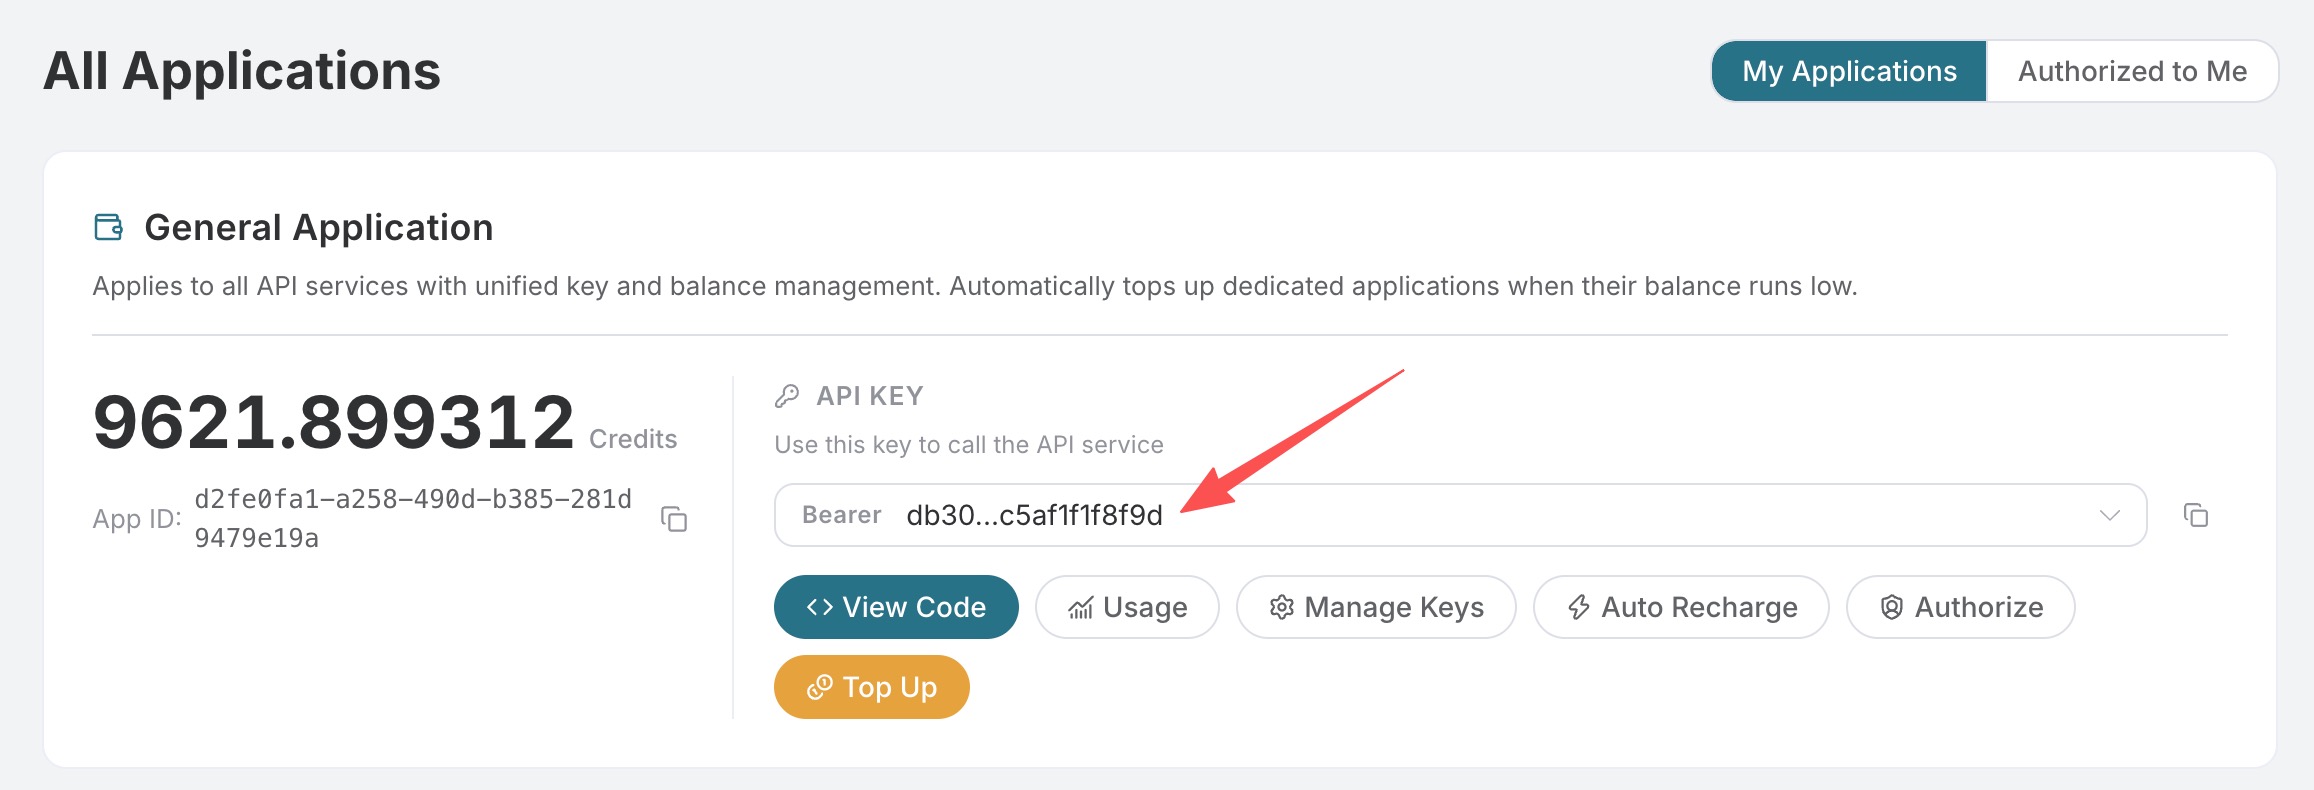 まだログインまたは登録していない場合は、ログインページへ自動的に移動して登録とログインを案内され、完了後は自動的に現在のページへ戻る。
1 つの API Token でプラットフォームのすべてのサービスを呼び出すことができ、サービスごとに個別申請する必要はない。 初回申請時には無料枠が付与され、無料で体験できる;枠が不足した場合は コンソール で共通残高をチャージできる。
📘 完全なドキュメント:Suno Audios Generation API →
基本的な使用方法
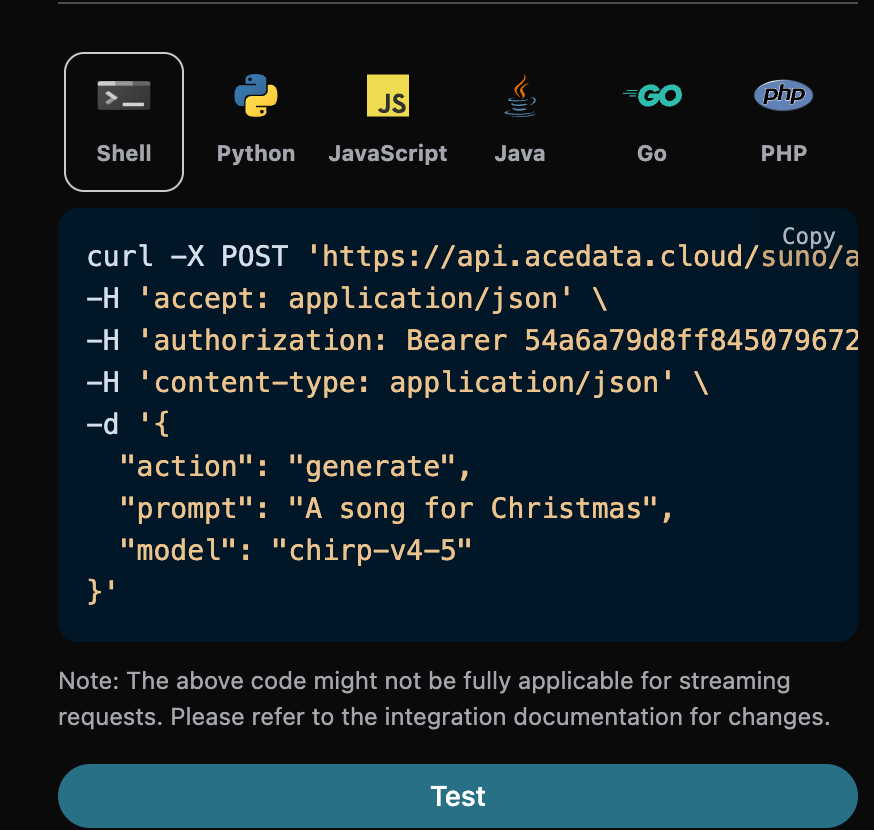
どのような楽曲を考えても、任意の文章を入力できる。たとえばクリスマスに関する楽曲を生成したい場合は、a song for Christmas と入力すればよく、図のとおりである:
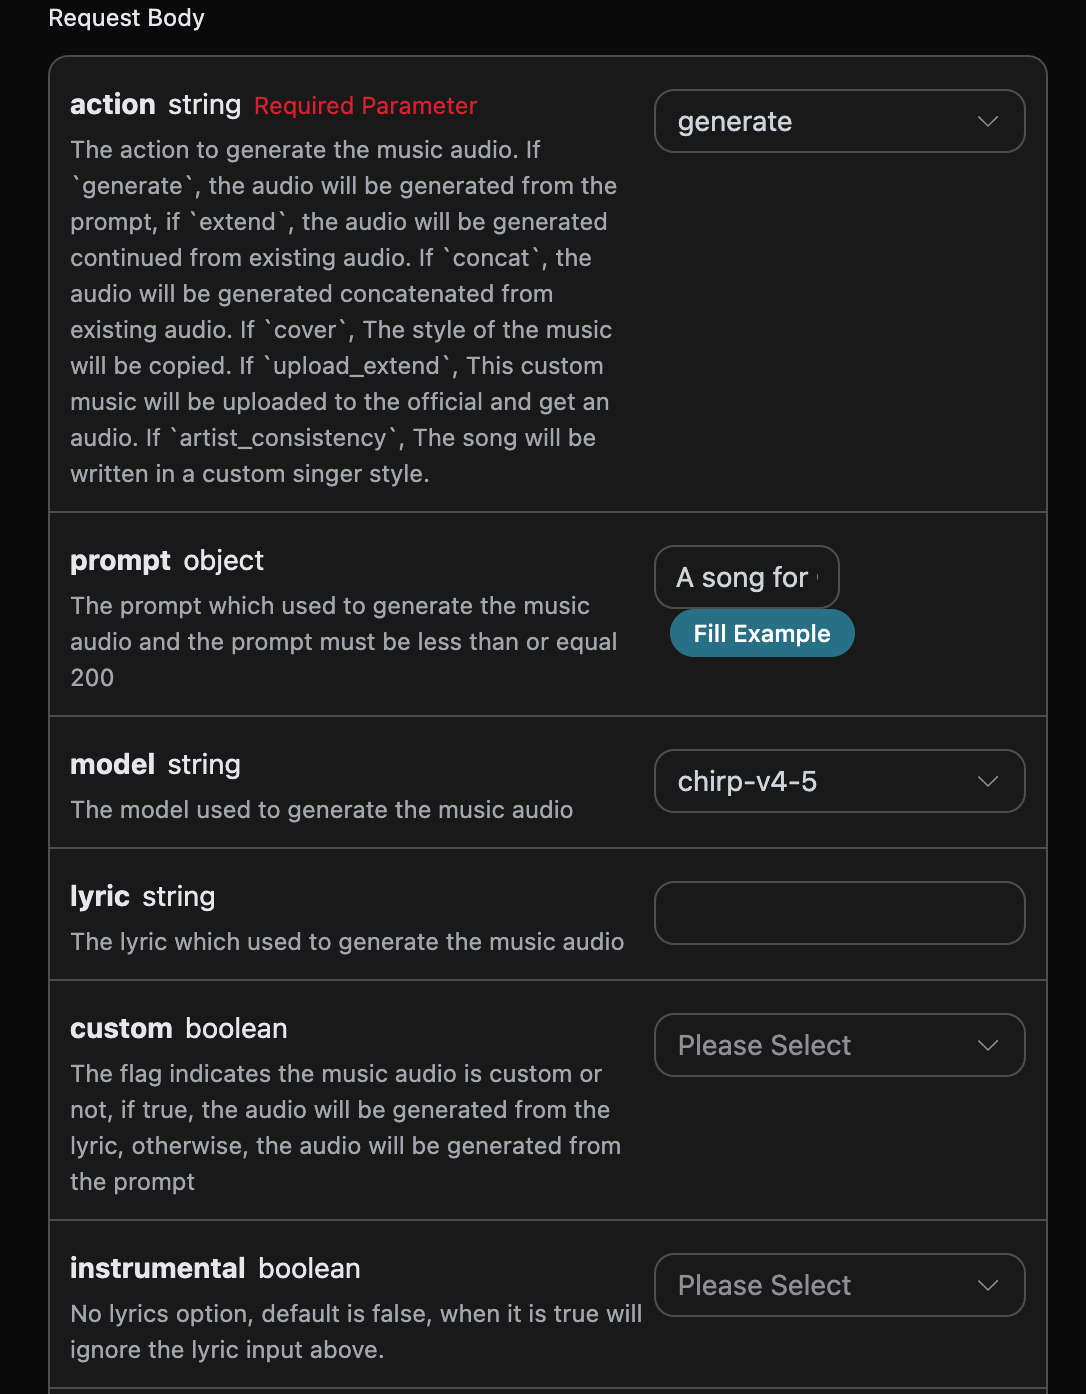
accept:どの形式のレスポンス結果を受け取りたいか。ここではapplication/json、つまり JSON 形式を入力する。authorization:API を呼び出すためのキーであり、申請後に直接プルダウンから選択できる。
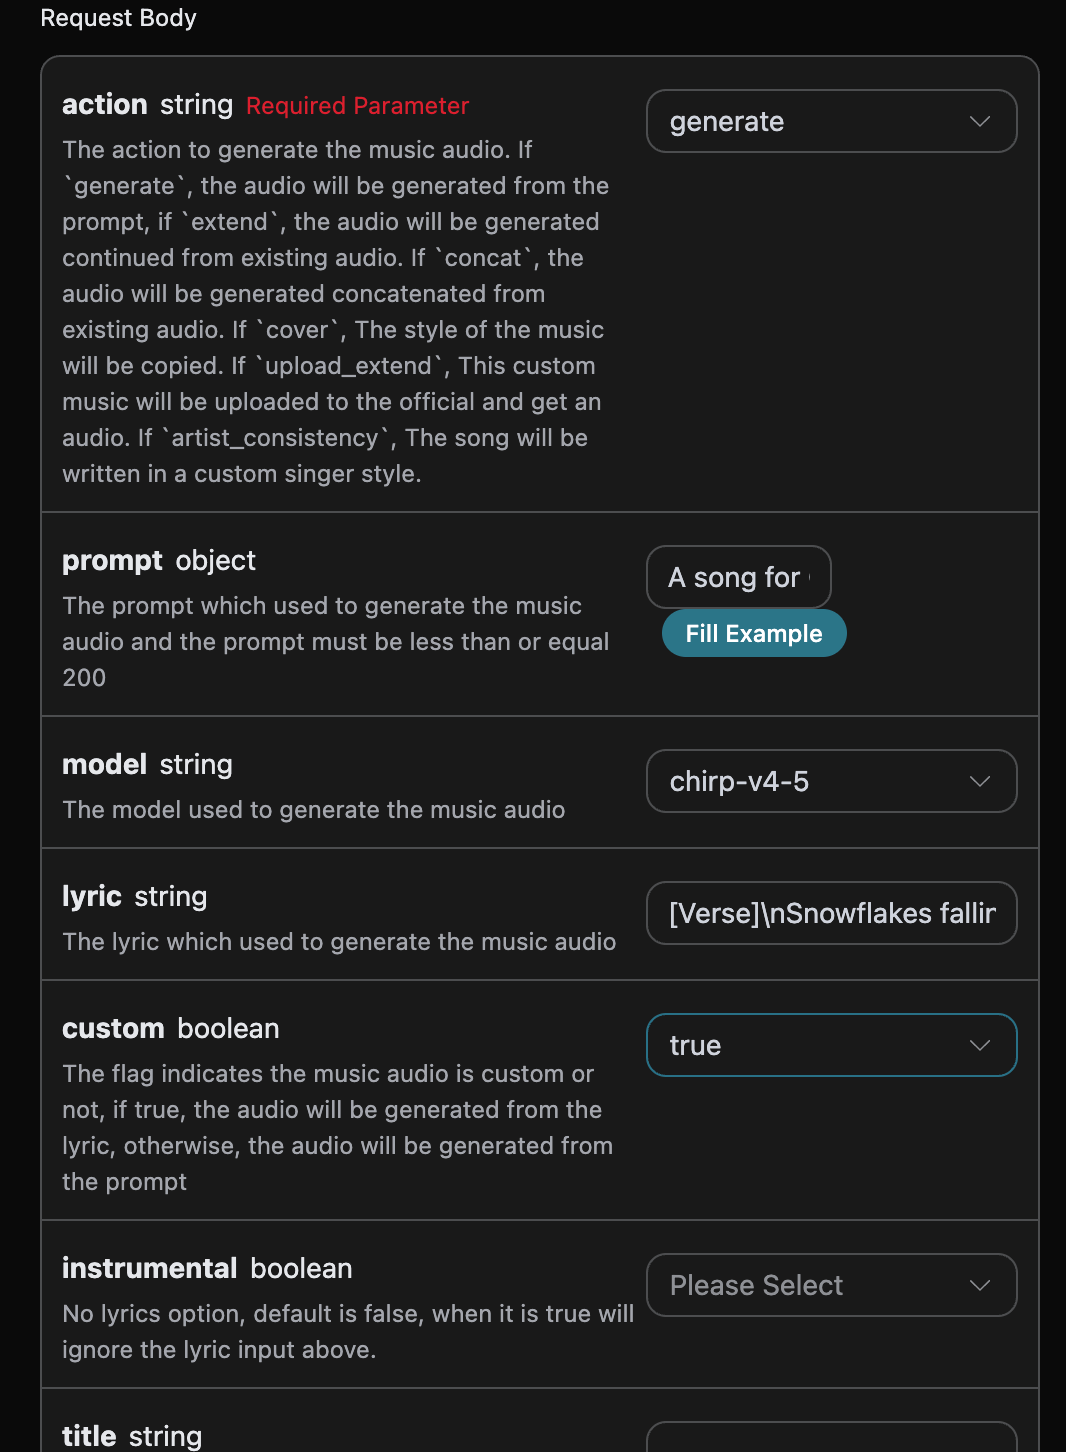
action:オーディオタスクのタイプ。デフォルトはgenerate。生成、続きの作成、カバー、結合、ステム分離、オーディオトラックの追加、指定オーディオトラックの抽出、効果音の生成、速度調整などの操作をサポートし、すべてPOST /suno/audiosを通じて呼び出します。prompt:Suno 公式のインスピレーションモードのプロンプト(customがfalseの場合に有効)。最大 500 文字。model:今回の音楽生成タスクのモデル。v6 シリーズにはchirp-v6、chirp-v6-wild、chirp-v6-miniが含まれます。旧モデル名も引き続き互換性があります。max_mode:拡張生成モード。generateはcustomとmax_modeがともにtrueの場合にのみ有効で、料金は 1.12 Credits です。add_stemは直接有効化でき、料金は 1.344 Credits です。無効または省略時は、それぞれ 0.56 および 0.672 Credits です。variety:生成結果の多様性の強度。off、normal、high、extra、maxから選択可能。generateとadd_stemにのみ使用され、その他の action で渡すと 400 が返されます。lyric:Suno 公式のカスタムモードの歌詞内容。chirp-v3-5とchirp-v4は最大 3000 文字、chirp-v4-5以降(chirp-v5、chirp-v5-5を含む)は最大 5000 文字。custom:カスタムモードを使用するかどうか。デフォルトは:false。instrumental:Suno 公式のインスピレーションモードのインストゥルメンタルオプション。title:Suno 公式のカスタムモードの楽曲タイトル。chirp-v3-5、chirp-v4は最大 80 文字、chirp-v4-5以降は最大 100 文字。style:Suno 公式のカスタムモードの音楽スタイル。chirp-v3-5とchirp-v4は最大 200 文字、chirp-v4-5以降(chirp-v5、chirp-v5-5を含む)は最大 1000 文字。negative_tags:カスタムモード(customがtrue)で、生成結果から除外したい音楽スタイルまたはジャンル。audio_weight:オーディオまたは音声特徴の影響の重み。範囲は 0-1 で、0も有効な値です。生成、続きの作成、カバー、オーディオトラックの追加、音声一貫性などの操作に使用できます。参照オーディオまたは音声特徴がない場合、モデルはこの値を弱めたり無視したりする可能性があります。audio_id:参照音楽の ID。overpainting_start/overpainting_end:既存のインストゥルメンタル音楽にボーカルを追加する開始・終了時刻。単位は秒。underpainting_start/underpainting_end:アカペラに伴奏を追加する開始・終了時刻。単位は秒。persona_id:アーティストの楽曲 ID。continue_at:続きの作成境界。単位は秒。たとえば、213.5 は 3 分 33.5 秒の位置から後続のセグメントを生成することを示します。lyricとstyleは境界以降の新しい内容のみをガイドし、元のオーディオ内で境界より前の歌詞や歌唱を置き換えることはありません。style_influence:カスタムモードでのスタイル影響力。範囲は 0-1 で、大きいほど通常は選択したスタイルにより沿います。0も有効な値として渡されます。replace_section_end:置換するセグメントの最終時刻。replace_section_start:置換するセグメントの開始時刻。vocal_gender:女性・男性ボーカルの好みを制御します。女性ボーカルはf、男性ボーカルはmで、4.5 以降のモデルで有効です。これは好みの項目であり、厳密な遵守は保証されません。weirdness:カスタムモードでの奇抜さ。範囲は 0-1 で、大きいほど通常はより創造的・実験的になります。0も有効な値として渡されます。duration:期待する楽曲の長さ。単位は秒で、整数である必要があり、値の範囲は 10 から 360 です。このパラメータは、カスタムモード(customがtrue)の楽曲生成に使用されます。これは厳格な制約ではなく傾向を示すプロンプトです。モデルはこれを参照しますが、達成を保証するものではありません。実際の完成品の長さはレスポンス内のdurationフィールドに従い、通常は期待値より短くなります。
高度なパラメータの適用範囲
プラットフォームはパラメータの型と数値範囲を検証しますが、action が異なることのみを理由にこれらの任意の調整項目を拒否することはありません。具体的な効果は操作、モード、モデルによって決まります。
lyric_prompt:歌詞を生成するための prompt。customがtrueであり、かつlyricが渡されていない場合に限り有効です。callback_url:結果をコールバックする必要がある URL。async:任意。trueに設定すると、インターフェースは直ちにtask_idを返します。callback_urlを提供する必要はなく、その後、対応するタスク照会インターフェースを通じてポーリングして結果を取得します。
- success:生成が成功したかどうか。成功した場合は
true、それ以外はfalse - data:生成された楽曲の詳細情報を含むリストです。
- state: 楽曲の生成状態。主に4種類あり、詳細は以下のとおりです:
- succeeded:生成成功
- pending:キュー待ち
- running:実行中
- error:失敗
- id:楽曲 ID
- title:楽曲のタイトル
- image_url:楽曲のカバー画像
- lyric:楽曲の歌詞
- audio_url:楽曲の最終音声アドレス。プラットフォームは Ace Data Cloud CDN のアドレスを優先して返します。永続化に失敗した場合は元のメディアアドレスが返される可能性があるため、速やかにダウンロードしてください。
- video_url:楽曲の動画ファイル。開くと mp4 動画です。
- created_at:作成時間
- model:使用したモデル。通常は最新の v3 モデルです
- style:スタイル
- state: 楽曲の生成状態。主に4種類あり、詳細は以下のとおりです:
カスタム生成
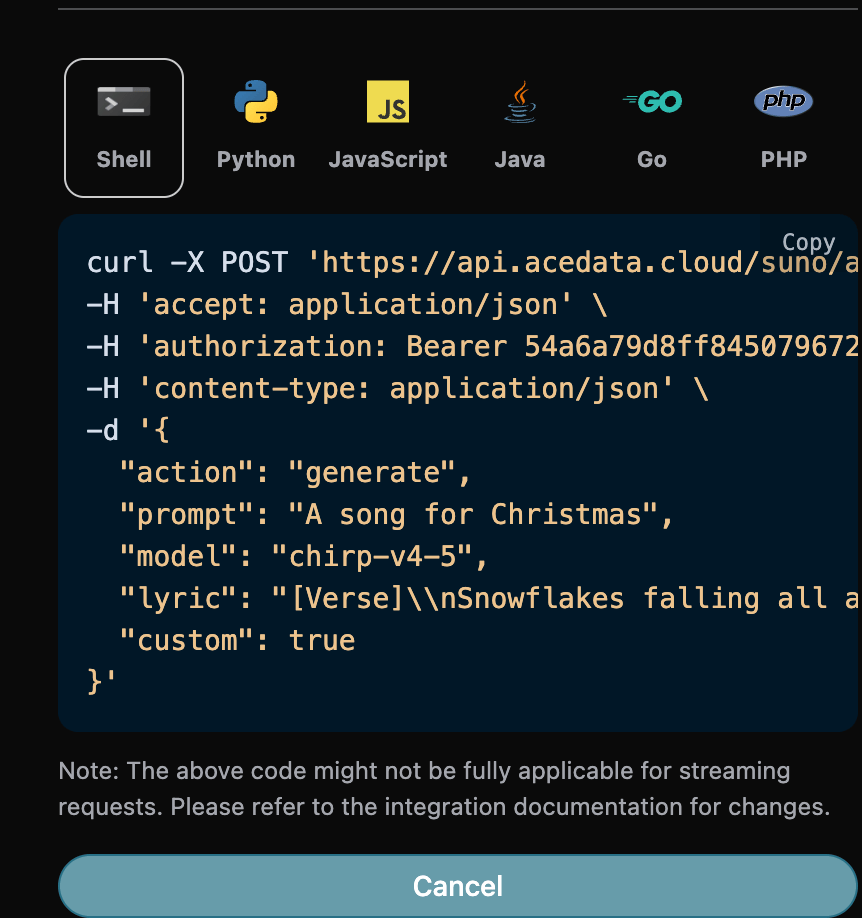
歌詞をカスタム生成したい場合は、歌詞を入力できます: この時、lyric フィールドには以下のような内容を渡すことができます:
注意:ここでの歌詞内の \n は改行文字です。歌詞を生成する方法がわからない場合は、AceDataCloud が提供する歌詞生成 API を使用して、prompt から歌詞を生成できます。API は Suno Lyrics Generation API です。
続いて、歌詞、タイトル、スタイルに基づいて楽曲をカスタム生成するには、以下の内容を指定できます:
- lyric:歌詞テキスト
- custom:
trueを入力するとカスタム生成を表します。このパラメータのデフォルトは false で、promptを使用した生成を表します。 - title:楽曲のタイトル。
- style:楽曲のスタイル。任意です。
カスタム歌手スタイル生成機能
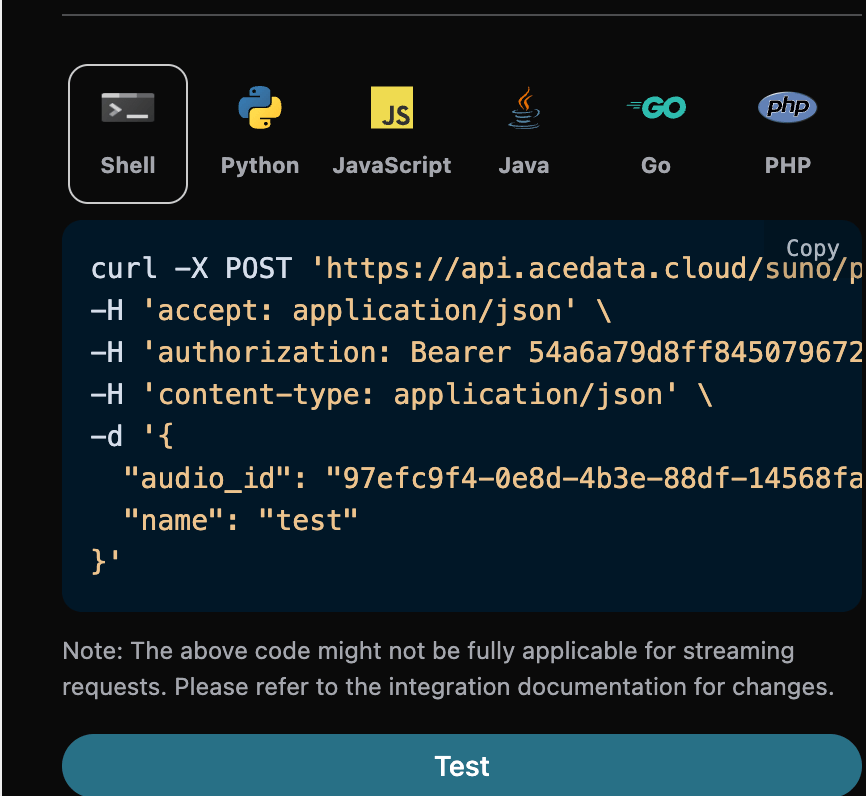
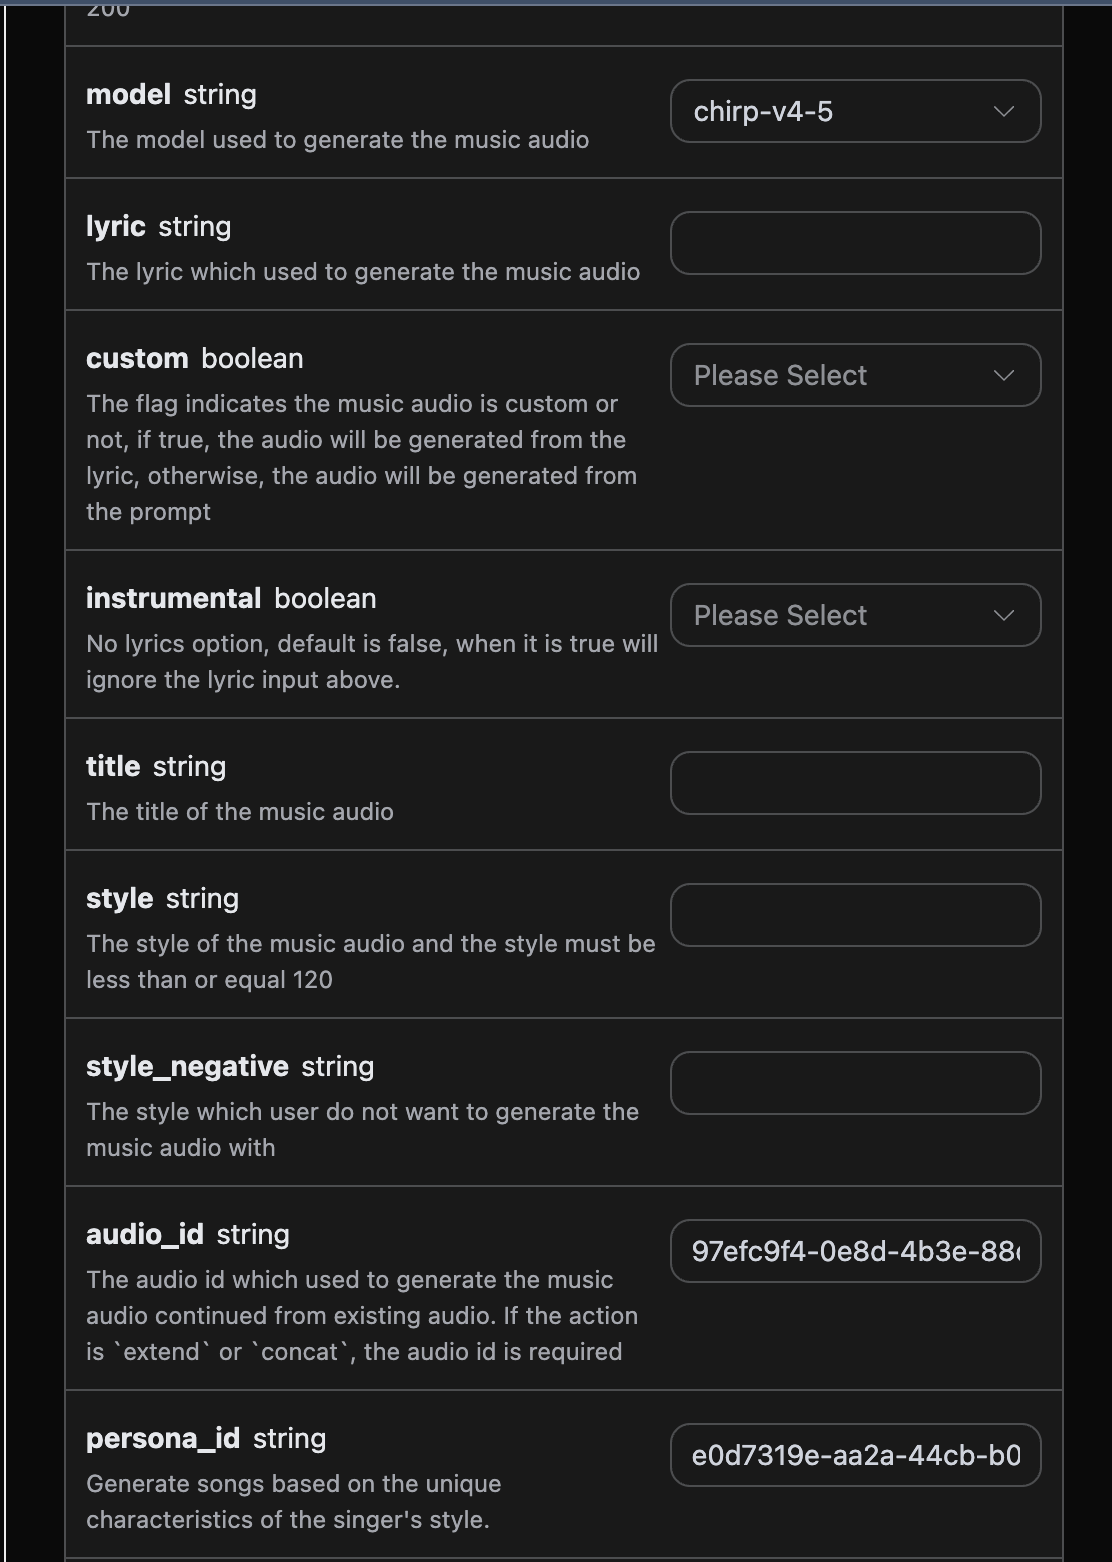
歌手スタイルを使用して楽曲を生成したい場合、まず上記の基本的な使用方法で楽曲を生成し、 最後にこの楽曲を歌手スタイルに設定する必要があります。その後、Suno Persona API にアクセスし、公式で生成された音楽 IDaudio_id に基づいて歌手スタイルの id パラメータ persona_id を生成する必要があります。具体的なパラメータは以下の図のとおりです:
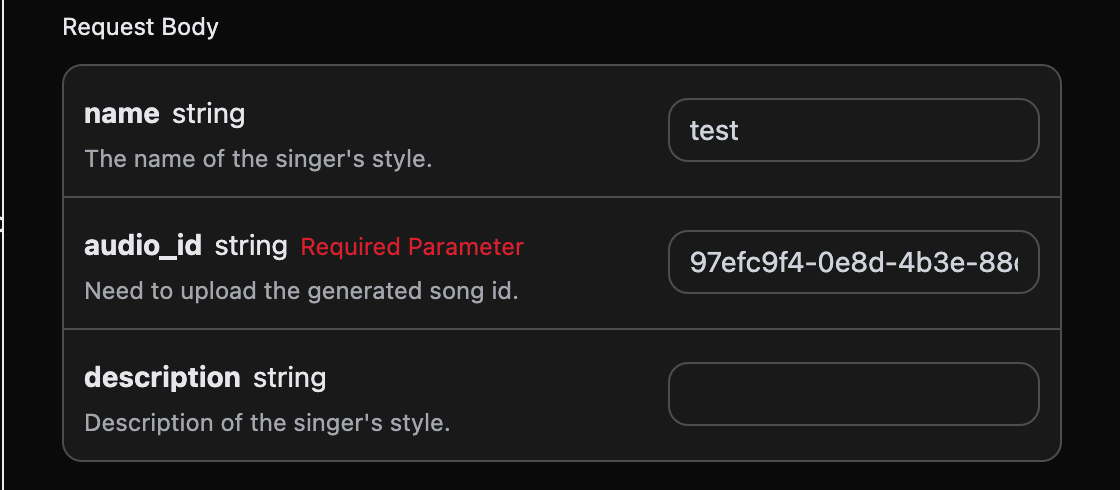
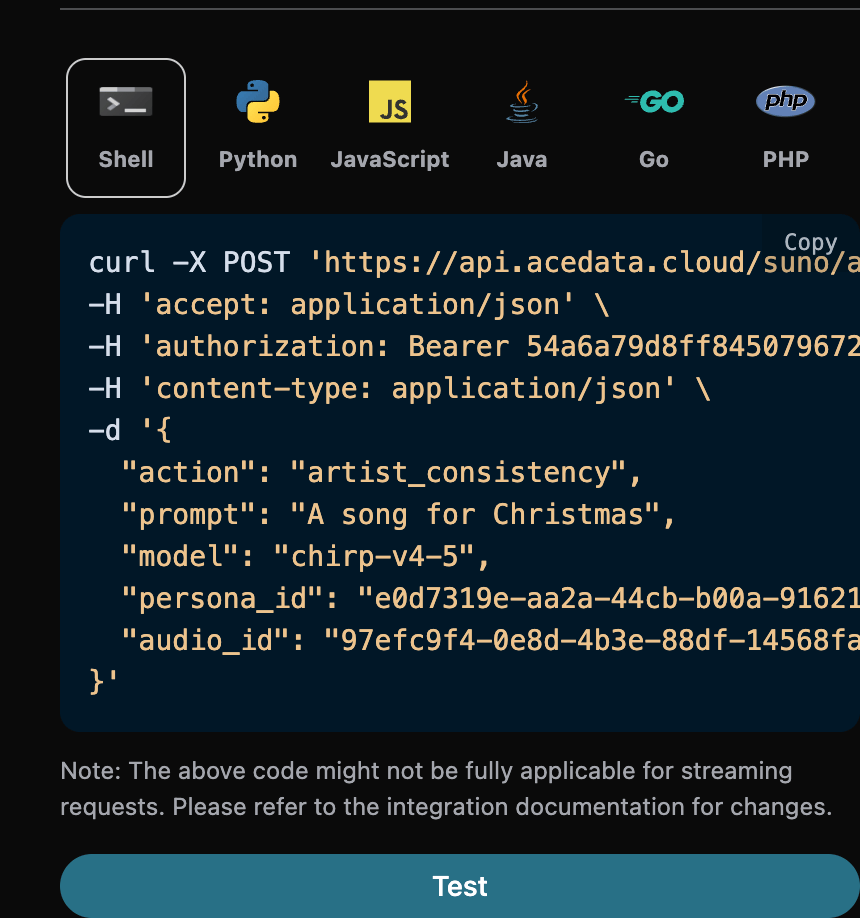
audio_id と persona_id を、それぞれ 97efc9f4-0e8d-4b3e-88df-14568fa1b11f、e0d7319e-aa2a-44cb-b00a-916218d7cb0b として、今回のサンプルデータにします。次に、パラメータ action を artist_consistency に設定し(新バージョンの歌手スタイル Persona-v2-vox の場合、action は必ず artist_consistency_vox に設定する必要があります)、続けて楽曲を生成する必要がある ID、歌手スタイル ID を入力します。入力例は以下のとおりです:
続きを生成する機能
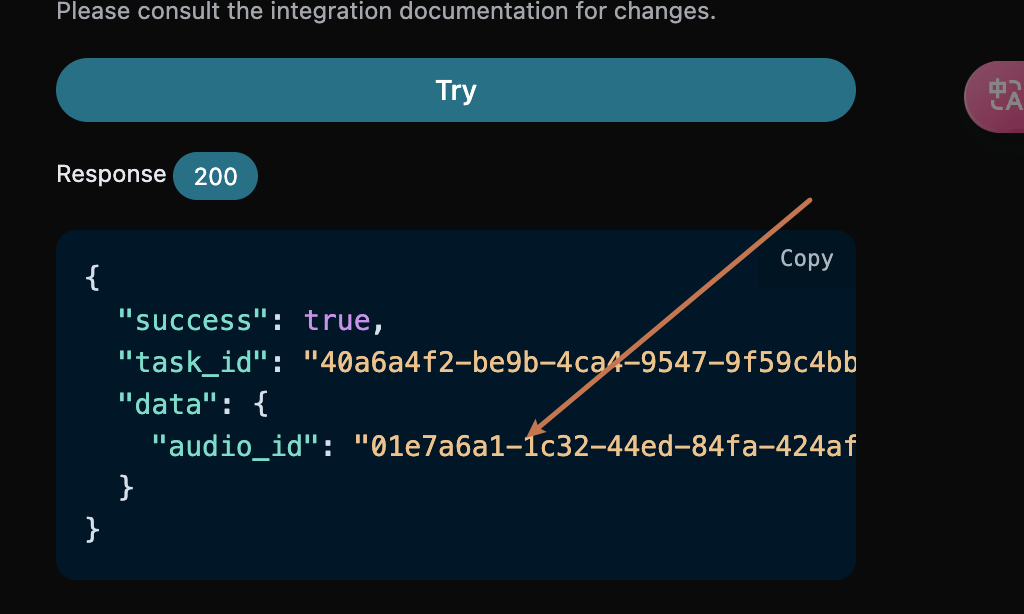
すでに生成された Suno 楽曲に対して続きを生成したい場合は、パラメータaction を extend に設定し、続けて生成する必要がある楽曲の ID を入力できます。楽曲 ID は基本的な使用方法に基づいて取得します。上記から、この時点で楽曲の ID は以下であることがわかります:
注意:ここで歌詞中の id は生成後の楽曲の ID です。楽曲の生成方法がわからない場合は、上記の基本的な使用方法を参考にして楽曲を生成できます。
自分でアップロードした楽曲に対して続きを生成したい場合は、パラメータ action を upload_extend に設定し、続けて生成する必要があるカスタムアップロード済み楽曲の ID を入力できます。楽曲 ID は Suno Upload Generation API を使用して取得します。以下の図のとおりです:
- lyric:
continue_at以降に新しく生成されるセグメントの歌詞を誘導するためだけに使用され、元の音声におけるこの時点以前の歌詞は置き換えられません。 - custom:
trueを入力するとカスタム生成を表します。このパラメータのデフォルトは false であり、promptを使用して生成することを表します。 - style:続きのセグメントの楽曲スタイル、任意入力です。
- continue_at:続きの生成境界で、単位は秒です。例えば、213.5 は 3 分 33.5 秒の位置から後続セグメントを生成することを表します。
入力例は以下のとおりです:extendは既存の楽曲の続きを後方に作成するためのものであり、楽曲全体の歌詞を変更するものではありません。楽曲全体を最初から新しい歌詞で作成したい場合は、generateを使用して再生成してください。既存の楽曲を参考にして再演奏したい場合は、coverを使用できます。楽曲全体の新しい歌詞を渡した場合でも、continue_atより前の元の歌詞は置き換えられません。
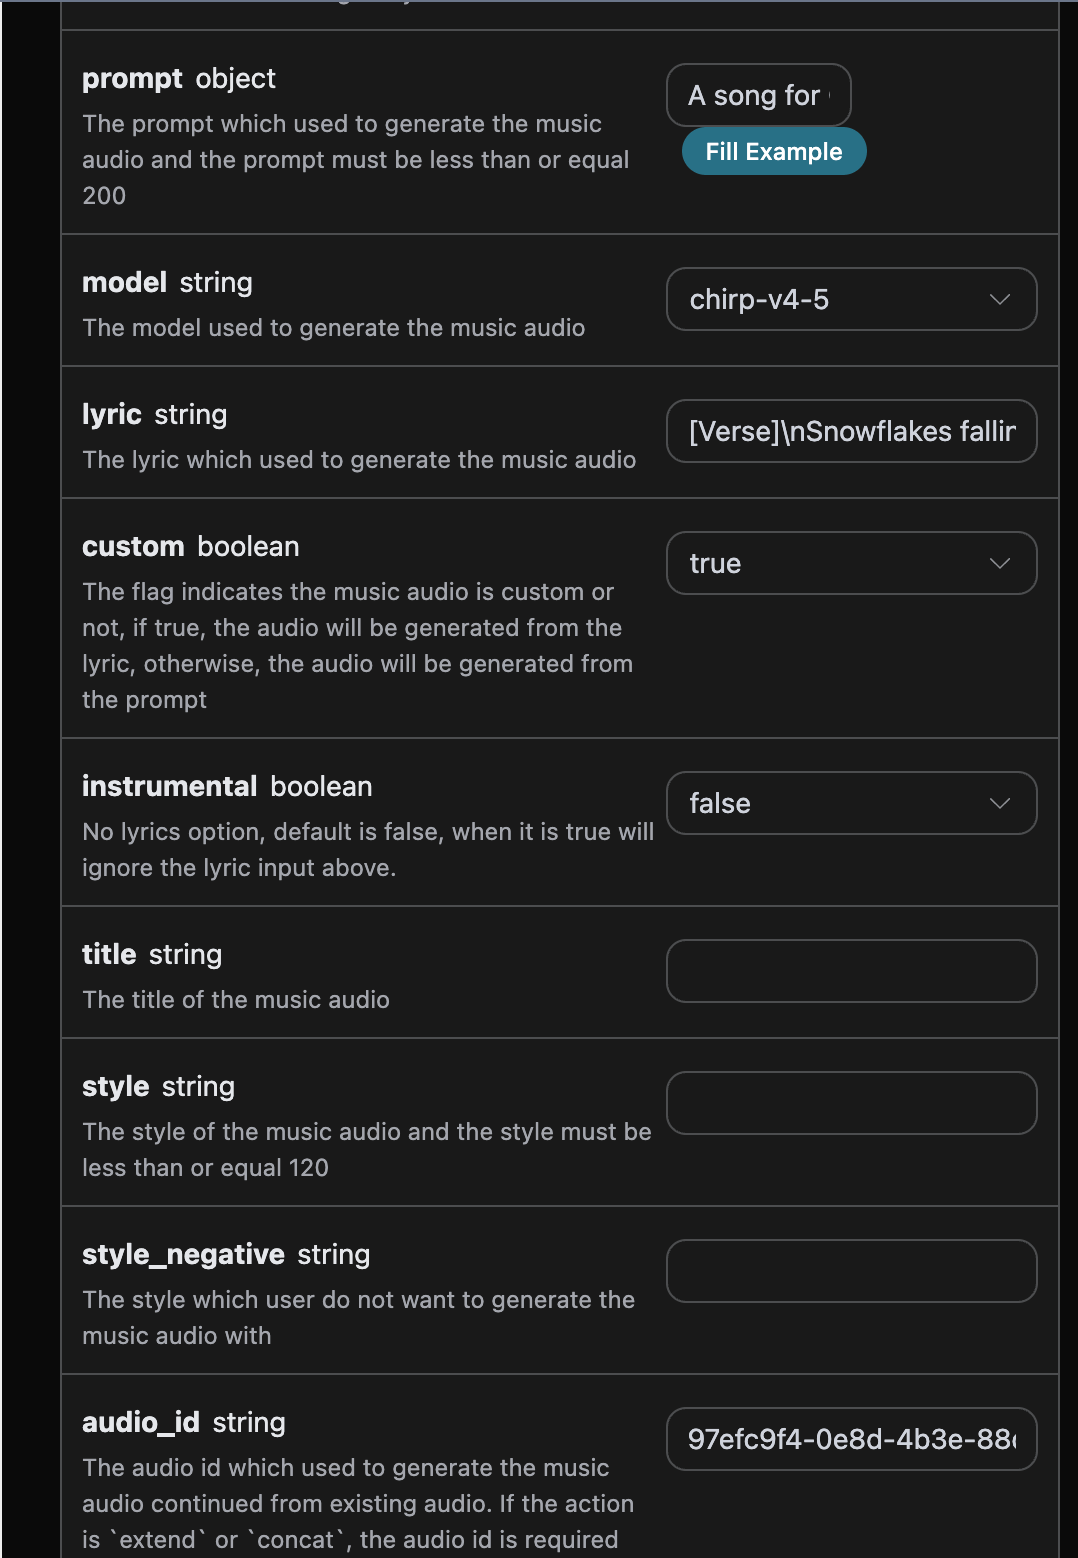
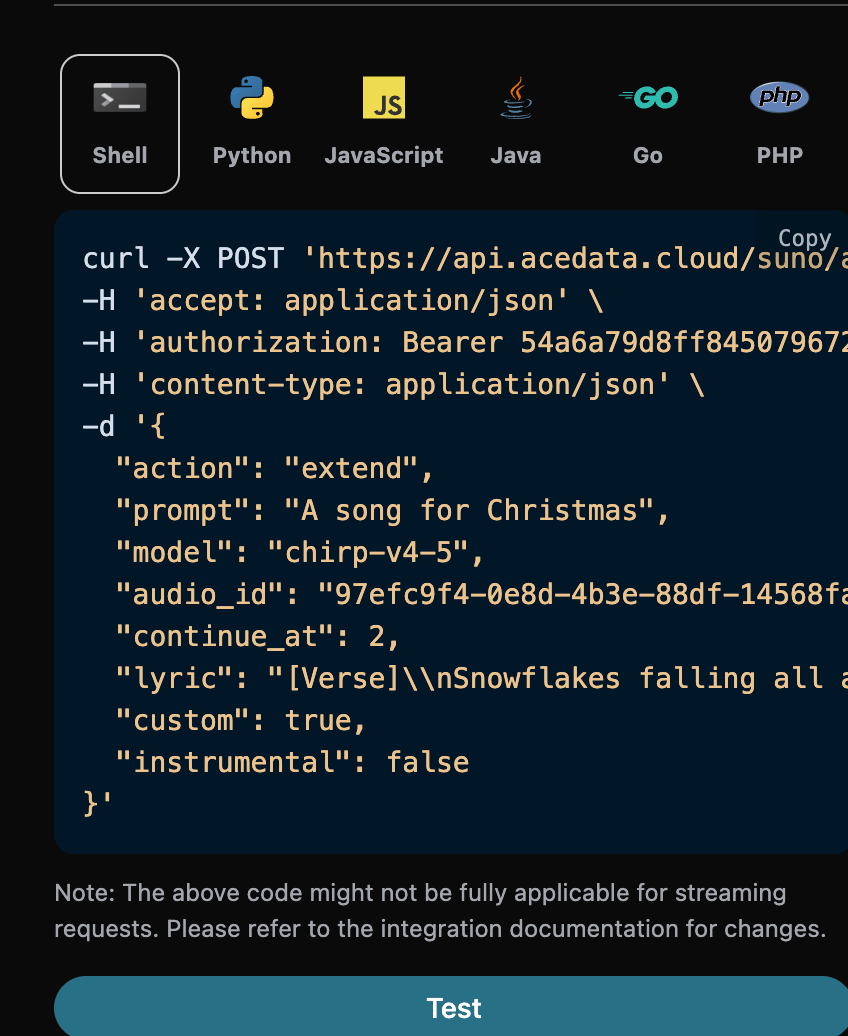
continue_at は 2 秒のため、最初の 2 秒だけが続き書き境界より前の元の内容に該当します。実際に曲の終わり近くから続き書きする場合は、この値を続き書きを開始したい秒数に設定し、lyric には境界後に歌う新しいセクションのみを指定してください。
対応する Python コード:
lyric には今回の続き書きタスクで使用された歌詞テキストが返されることがわかります。このフィールドは完成した音声全体の逐語的な文字起こしではありません。extend の場合、continue_at より前の元音声には引き続き元の歌詞が使用され、新しい歌詞は続き書きセグメントを誘導するためにのみ使用されます。
完全な楽曲を取得する
現在のモデルのextend 結果には通常、continue_at より前の元音声と境界後の新しい内容がすでに含まれています。まず、返された音声の実際の長さと内容に基づいて、すでに完全な楽曲であるかを判断してください。返されたものが独立した続き書きセグメントである場合、または複数回の続き書き履歴を明示的に1曲へ統合する必要がある場合は、連結機能を使用してください:
- action:値は
concat。 - audio_id:最後の続き書きセグメントの ID。
音楽カバー
元の楽曲に基づいて楽曲を継続生成した後、返される楽曲のスタイルがあまり適切でない可能性があります。以前に生成した楽曲(カスタムアップロードした音楽の場合もサポート)をカバーする必要がある場合は、音楽カバーの方法を使用し、以下の内容を指定できます:- action:内容は
coverです。カスタムアップロードした音楽に対してカバー操作を行う場合は、内容を必ずupload_coverに指定する必要があります。 - audio_id:以前に生成した楽曲の ID。
セクションの置換
楽曲の生成後、楽曲セクションの置換を個別に行う二次創作が必要な場合は、楽曲のあるセクションに対して置換操作を行えます。⚠️ 注意:パラメータの説明は以下のとおりです:replace_section_result_modeのデフォルトはfull_songです:システムは新たに生成された 2 つの候補をそれぞれ結合し、2 曲の完全な楽曲を返します。まだ結合されていない置換セクション候補のみが必要な場合は、明示的にcandidatesに設定し、その後候補を選択して音楽結合を呼び出してください。
- action:内容は
replace_sectionです。 - audio_id:元の楽曲(置換されるソース楽曲)の ID。
- model: 楽曲生成モデル。
- lyric: 置換後の完全な歌詞(置換されるセクションおよびそのコンテキストを含み、
prompt内の内容と一致させます)。 - prompt:置換するセクションの新しい歌詞。
- style:楽曲のスタイル、任意。
- replace_section_start:置換されるセクションの元の楽曲内での開始時間(秒)。
- replace_section_end:置換されるセクションの元の楽曲内での終了時間(秒)。
- replace_section_result_mode:返却モード、デフォルトは
full_songです。full_songは 2 つの候補をそれぞれ結合して 2 曲の完全な楽曲を返します;candidatesはまだ結合されていない 2 つの候補セクションを返します。
ステップ 1:セクション置換タスクを開始する
例えば、以前に生成した楽曲 ID が:18db7ed0-2b8a-41db-91c1-b0781dcca0d4(長さ 94.12 秒)であり、30 秒目から 60 秒目までのサビを新しい歌詞に置き換えたい場合、以下のようにパラメータを設定できます:replace_section_result_mode を candidates に設定した場合は、まだ結合されていない2つの置換セグメントが返され、その構造は以下の例と同じです。
candidates モードでは、返される2つの音声の長さ(45.16秒、33.8秒)は元の楽曲(94.12秒)よりはるかに短く、少量のコンテキストを含む置換セグメントであり、完全な楽曲ではありません。満足のいく候補を選んで、引き続き手動で結合できます。デフォルトの full_song モードでは、2回の結合が完了し、2曲の完全な楽曲が直接返されます。
完全な楽曲を直接返す
完全な楽曲を直接取得したい場合は、ステップ1でreplace_section_result_mode を full_song に設定できます。インターフェースはそれぞれ2つの候補を結合し、2曲の完全な楽曲を返します。この場合、concat を再度呼び出す必要はありません。
ステップ2:置換セグメントを元の楽曲に結合する
上で選択したセグメント(例:364f9d8b-ca25-463b-9a5e-d0b7139e2d6a)に対して、音楽の結合 セクションの方法に従い、concat タスクを開始します。
duration は完全な曲の長さ(105.28 秒、元の曲の長さとほぼ同じ)に戻っており、audio_url が指しているのは置換完了後の曲全体です。これにより、「生成 → セグメント置換 → 曲全体の結合」という二次創作プロセスが完了します。
ボーカルと伴奏の分離
曲を生成した後、伴奏とボーカルを個別に操作する二次創作を行う必要がある場合、純粋な音楽伴奏とアカペラのボーカルを分離できます。以下の内容を指定できます:- action:内容は
stems。 - audio_id:以前に生成した曲の ID。
全トラックのボーカルと伴奏の分離
曲を生成した後、全トラックのボーカルと伴奏の分離操作を行う必要がある場合、以下の内容を指定できます:- action:内容は
all_stems。 - audio_id:以前に生成した曲の ID。
音源を追加する
add_stem は指定したオーディオに対してターゲットの楽器または音声トラックを生成し、POST /suno/audios を通じて呼び出します。
- 必須:
action、audio_id、stem_type。 - 任意:
model、prompt、title、style、negative_tags、weirdness、style_influence、audio_weight、max_mode、variety。 - 料金:通常モードは 0.672 Credits;
max_modeがtrueの場合は 1.344 Credits。
音源を抽出する
extract_stem は指定したオーディオからターゲット音源を抽出すると同時に、その音源を除去した補完バージョンを返し、POST /suno/audios を通じて呼び出します。
- 必須:
action、audio_id、stem_type。 - 任意:
audio_format。現在の公共デュアルチャネル契約ではmp3のみサポートされています。 - 料金:1.12 Credits。
data はフラットなオーディオリストを保持し、stem_sets はターゲット音源と補完音源の対応関係を示します:
効果音を生成する
sounds はテキストによる説明に基づいてワンショットまたはループ可能な効果音を生成し、POST /suno/audios を通じて呼び出します。
- 必須:
action、sound、sound_type。 - 任意:
model、bpm、key、audio_format;audio_formatは現在mp3のみサポートされています。 sound_type:one-shotまたはloop。- 料金:0.112 Credits。
オーディオ速度の調整
adjust_speed は指定されたオーディオの再生速度を調整し、POST /suno/audios を通じて呼び出します。
- 必須:
action、audio_id、speed_multiplier、title。 - 任意:
keep_pitch。 speed_multiplier:範囲は 0.25~4。- 料金:0.28 Credits。
カスタム生成の高度なパラメータ
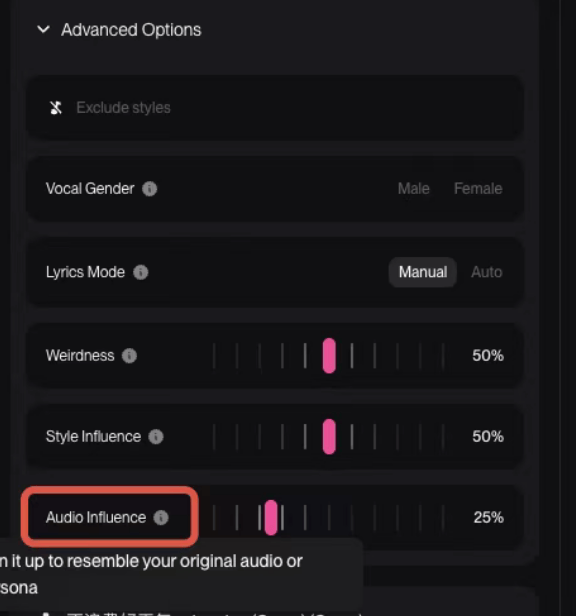
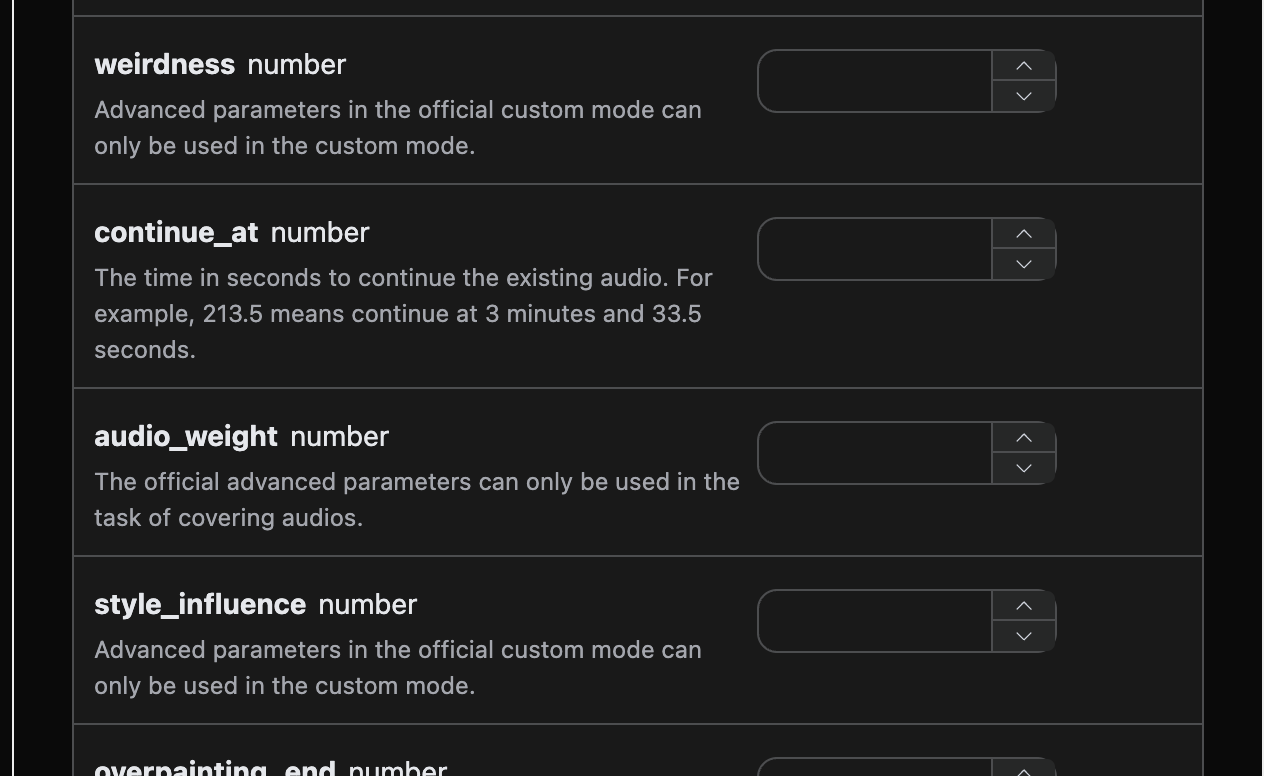
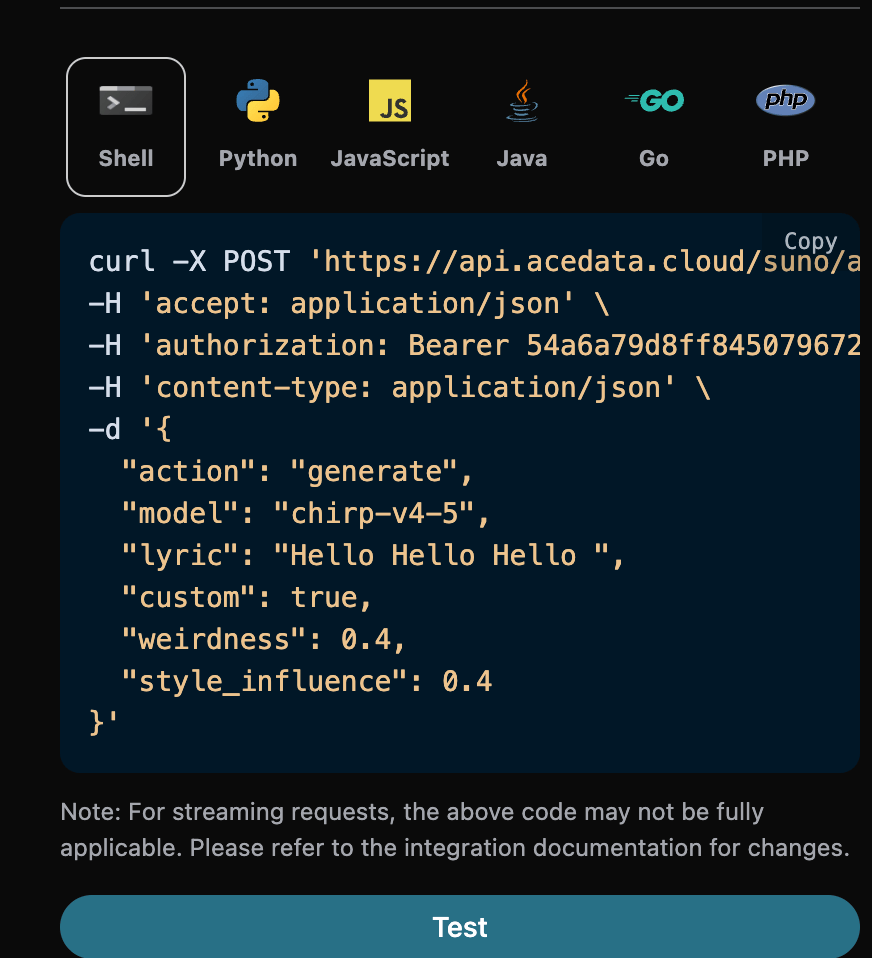
公式では、カスタムモードで高度なパラメータweirdness==>Weirdness、style_influence==>Style Influence、audio_weight==>Audio Influence を使用して生成することが許可されており、対応する公式の例は以下のとおりです:
楽曲の長さの制御
デフォルトでは、生成される楽曲の長さはモデルが自動的に決定し、通常は 30 秒から 4 分の間です。より長いまたは短い完成品が必要な場合は、duration パラメータで希望する長さを指定できます。単位は秒で、値は 10 から 360 までの整数です。
このパラメータは、カスタムモード(custom が true)での楽曲生成に使用されます。特に説明が必要なのは、duration は傾向を示すヒントであり、厳密な制約ではないということです:モデルは作曲時にこの値を参照しますが、達成されることは保証されず、実測では実際の長さは通常、希望値より明らかに短くなります。同一のリクエストで返される 2 曲の長さにも数倍の差が生じる可能性があります。完全に同じリクエストであっても、複数回送信した場合に得られる長さには大きな差が生じる可能性があります。したがって、これを正確な長さの制御として使用しないでください。業務上、固定の長さが必要な場合は、完成品を取得した後に自分でトリミングするか、再試行してください。
対応する Python コード:
duration は希望する長さであり、レスポンスの data にある各楽曲の duration フィールドはその楽曲の実際の長さです。両者は同じ名前ですが意味は異なり、実際の長さが希望値と等しいことは保証されません。歌詞の長さは完成品の長さに影響する主な要因の一つであり、より長い完成品が必要な場合は、より完全な歌詞も同時に提供することを推奨します。
インターフェースは duration が 10 から 360 までの整数であることを検証します。これはあくまで生成目標であり、完成品の長さを保証するものではありません。
Add Insterumental 機能
2025 年 8 月に suno は Add Insterumental 機能を新たに公開しました。まず、ボーカルのみで伴奏のない楽曲をアップロードし、suno に伴奏を付けてもらう必要があります。最初に Suno Upload API へボーカルのみで伴奏のない楽曲をアップロードできます。対応する操作は以下の図のとおりです。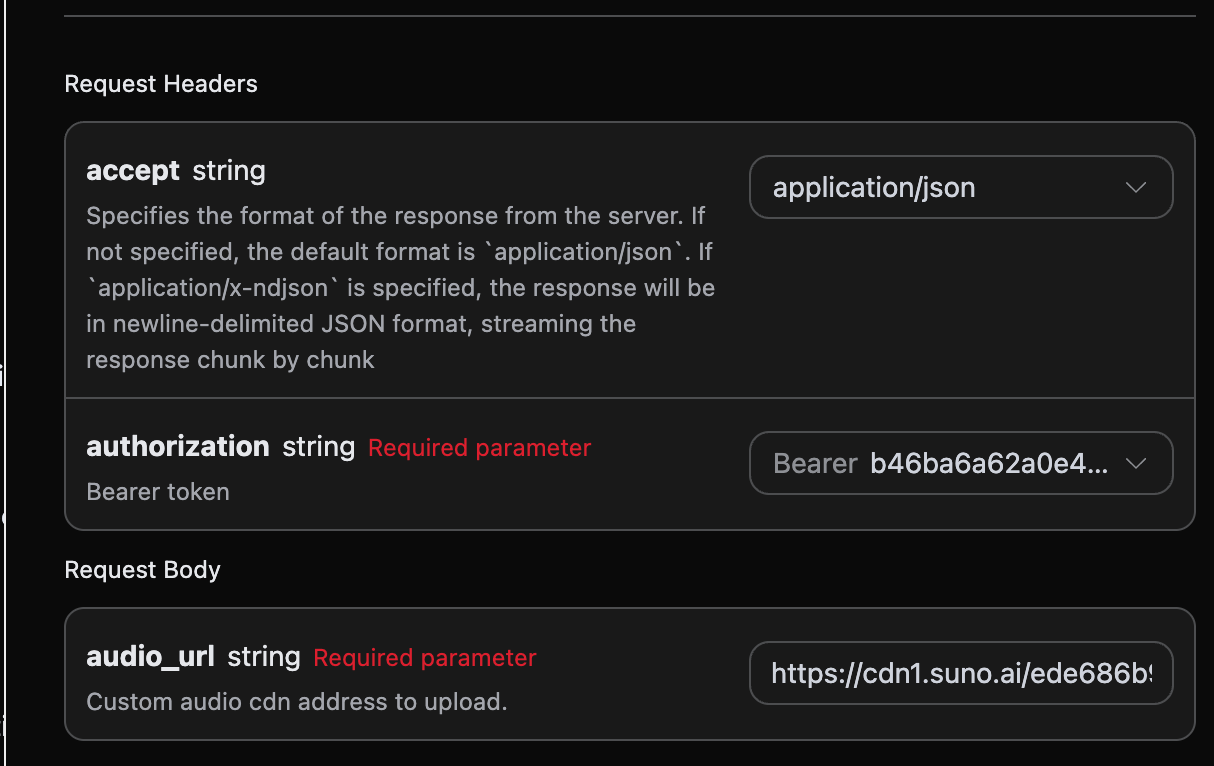
audio_id を記録する必要があります。具体的な結果は以下の図のとおりです。
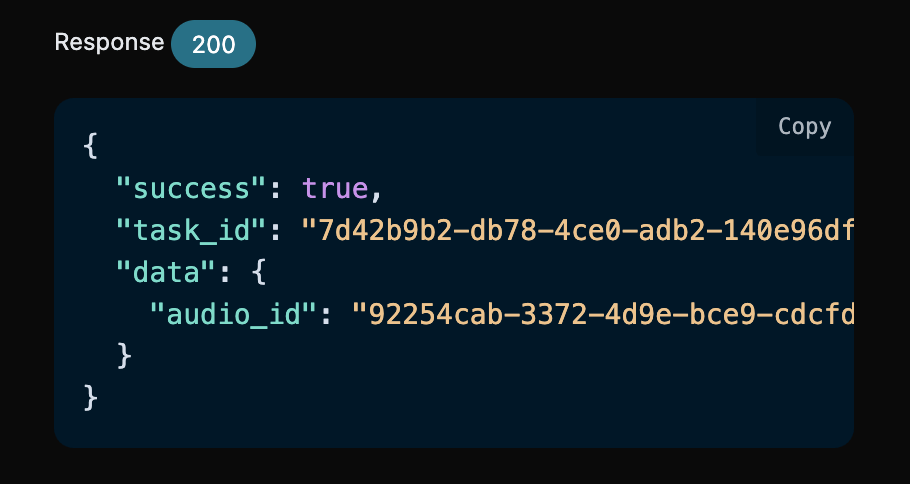
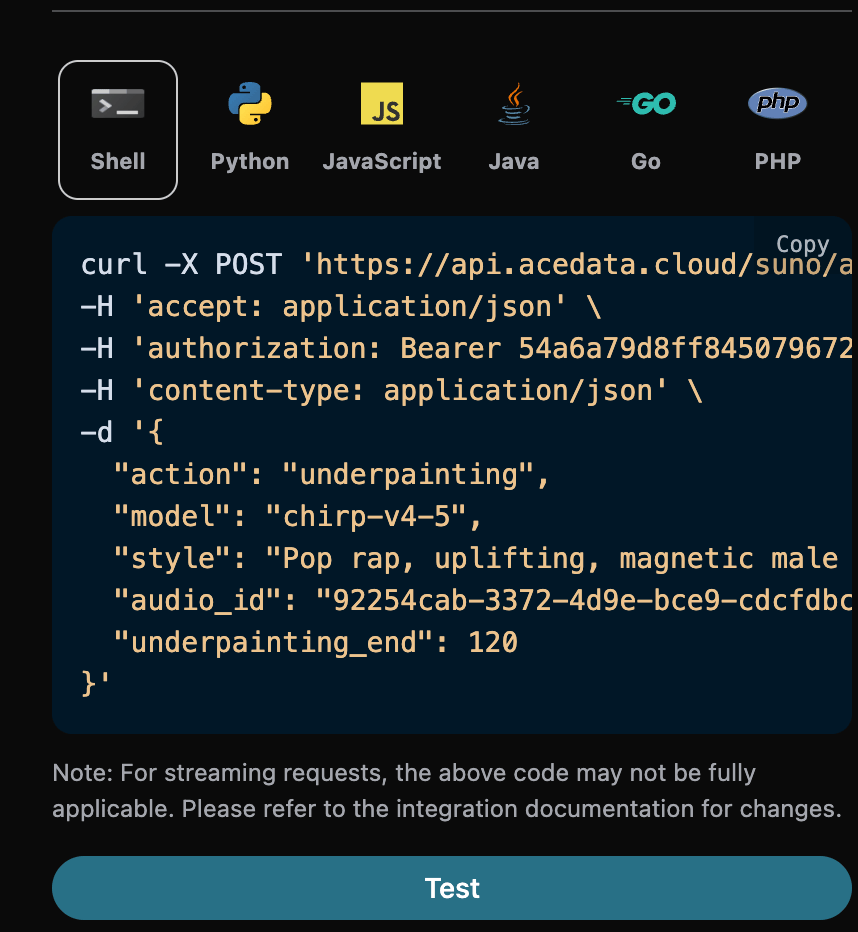
audio_id:92254cab-3372-4d9e-bce9-cdcfdbc39070 を取得しました。続いて、以下のパラメーターを入力する必要があります。
- action:値は
underpaintingです。 - underpainting_start:アップロードした楽曲に伴奏を追加する開始時刻です。デフォルト値は 0 です。
- underpainting_end:アップロードした楽曲に伴奏を追加する終了時刻です。楽曲の総再生時間より小さくなければなりません。
- audio_id:アップロードしたボーカルのみで伴奏のない楽曲の ID です。
- style:伴奏のスタイルです。伴奏なので、歌詞は使用しないほうがよいでしょう。
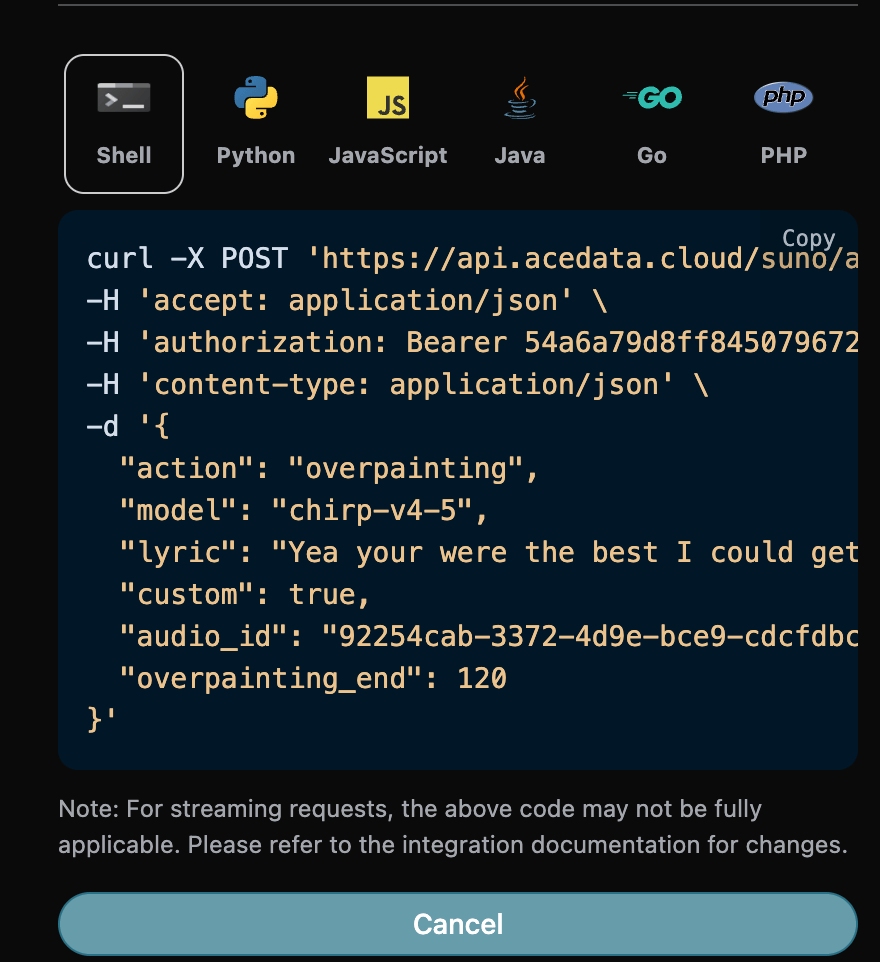
Add Vocals 機能
2025 年 8 月に suno は Add Vocals 機能を新たに公開しました。まず純音楽をアップロードし、suno に作詞とボーカル歌唱を行わせる必要があります。最初に Suno Upload API へボーカルのみで伴奏のない楽曲をアップロードできます。対応する操作は以下の図のとおりです。
audio_id を記録する必要があります。具体的な結果は以下の図のとおりです。
audio_id:92254cab-3372-4d9e-bce9-cdcfdbc39070 を取得しました。続いて、以下のパラメーターを入力する必要があります。
- action:値は
overpaintingです。 - overpainting_start:アップロードした楽曲にボーカルを追加する開始時刻です。デフォルト値は 0 です。
- overpainting_end:アップロードした楽曲にボーカルを追加する終了時刻です。楽曲の総再生時間より小さくなければなりません。
- audio_id:アップロードしたボーカルのみで伴奏のない楽曲の ID です。
- custom:このモードでは、カスタムモードを使用して歌詞を入力する必要があります。
- lyric:カスタムモードで入力する歌詞です。
- style:伴奏のスタイルです。
Remaster 機能
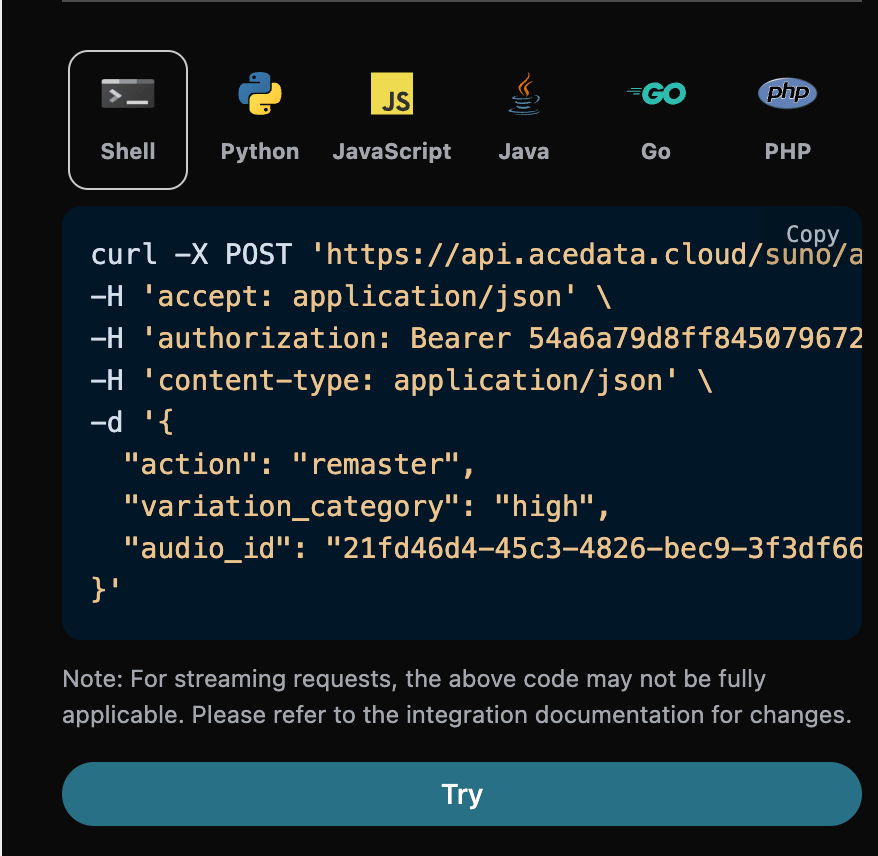
2025 年 12 月に suno は新たに Remaster 機能をリリースしました。この機能では楽曲を再生成できますが、アカウントをまたぐことはできません。続いて、以下のパラメータを入力する必要があります:- action:内容は
remaster。 - audio_id:再生成する楽曲の ID。
- model:v4.5+、v5 のみ対応。
- variation_category:v5 以降のバージョンでのみ対応しており、値は high、normal、subtle の 3 つのみです。
Mashup ミックス曲生成機能
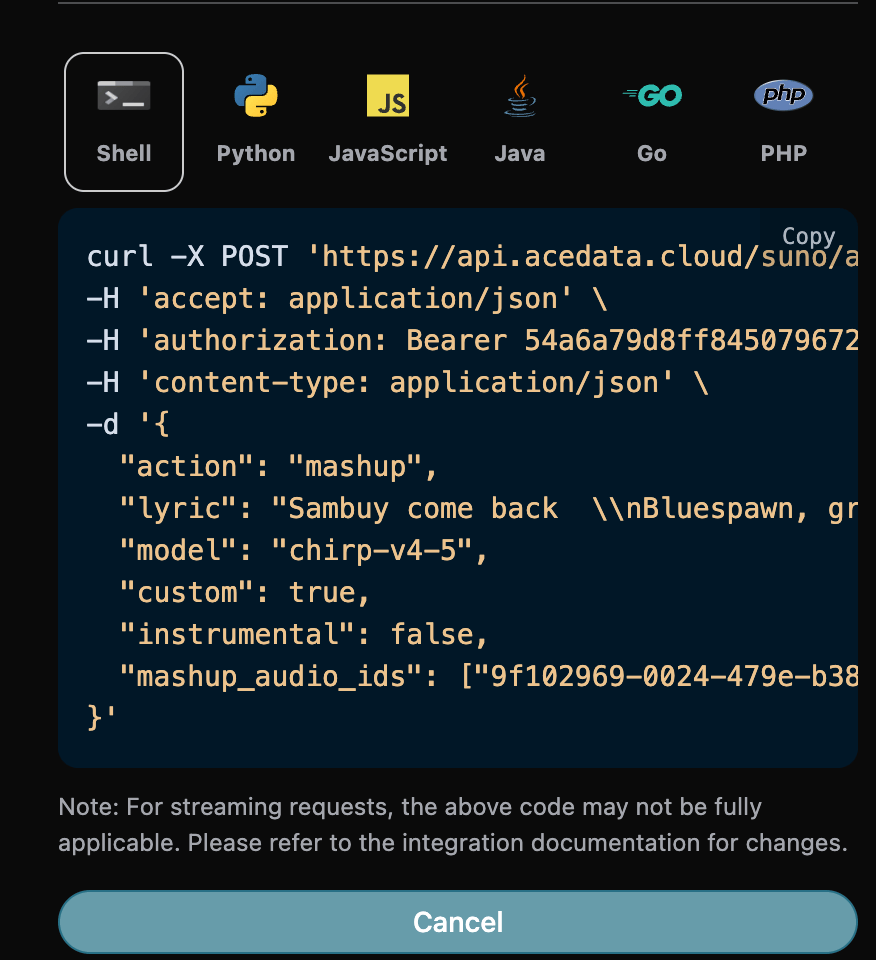
2025 年 12 月に suno は新たに Mashup 機能をリリースしました。この機能では 2 曲の参照楽曲に基づいて楽曲を生成できます。続いて、以下のパラメータを入力する必要があります:- action:内容は
mashup。 - mashup_audio_ids:2 曲の参照楽曲の ID。 入力完了後に自動生成されるコードは以下のとおりです:
Samples サンプリングによる楽曲生成
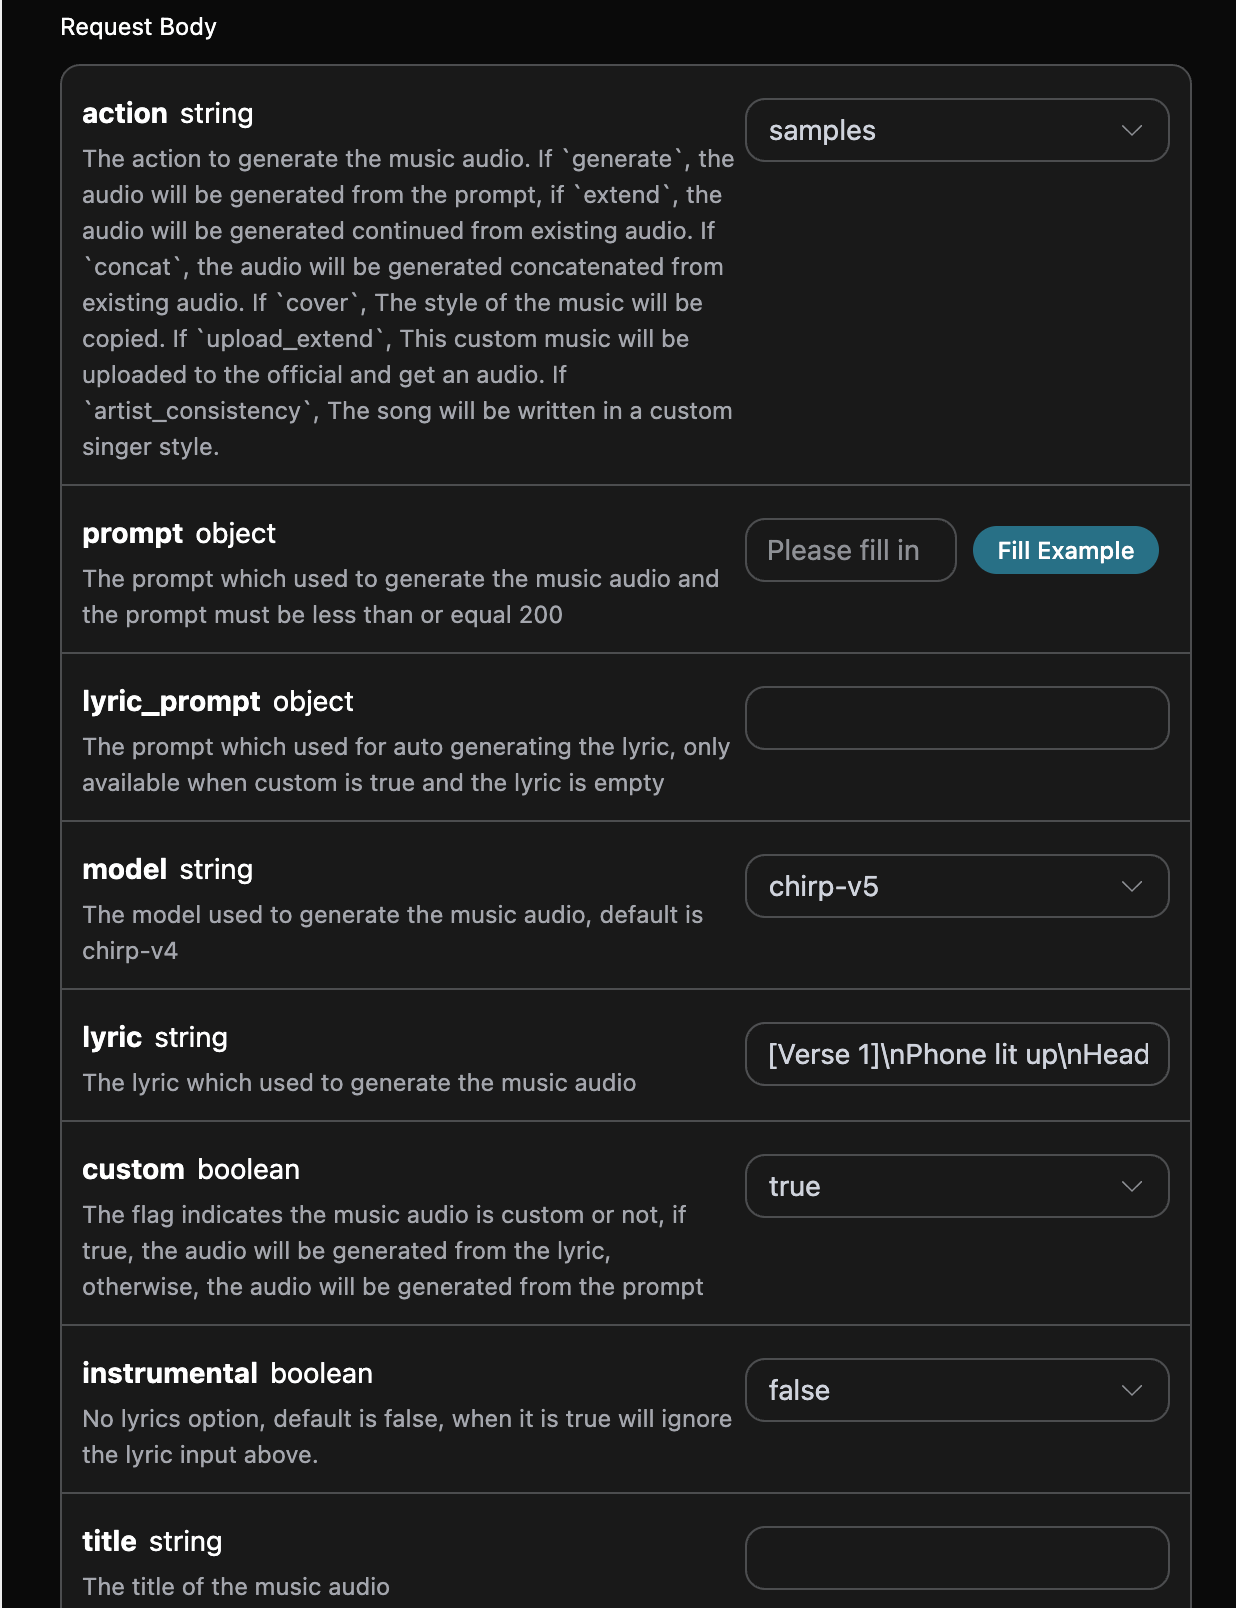
ここでのsamples は、単一の音声区間のサンプリングです。既存の音声から開始時間と終了時間を選択し、その断片をサンプル素材として創作を行います。これは、下記で1~4本の完全な参考音声を使用する Inspo インスピレーション創作機能とは異なります。以下のパラメータを入力する必要があります:
- action:内容は
samples。 - samples_start:サンプリング開始時間。
- samples_end:サンプリング終了時間。
- audio_id:サンプリングする参考楽曲の ID。
Inspo インスピレーション作曲機能
Inspo インスピレーション作曲機能では、1〜4本の完全な参照オーディオに基づいて新しい音楽を生成できます。オーディオをドラッグ&ドロップするかアップロードして、インスピレーション源として使用できます。API は既存のinspo action を使用します。クライアントは公開アクセス可能なオーディオ URL を提供し、サービスが参照オーディオの準備と作曲を自動的に完了するため、クライアント側で歌詞、スタイル、長さを個別に読み取ってリクエストを組み立てる必要はありません。これは上記の区間サンプリングとも、原曲のスタイルを再現する Cover とも異なります。使用時には、以下のパラメータを入力する必要があります。
- action:内容は
inspo。 - audio_urls:参照オーディオの URL リスト。公開アクセス可能なオーディオアドレスを1〜4件指定する必要があります。
- model:使用するモデル。
chirp-v6を推奨します。 - prompt:歌詞または作曲用プロンプト(任意)。
注意:参照オーディオは公開アクセス可能なオーディオファイルである必要があります。参照オーディオがプラットフォームの楽曲ライブラリ内の既知の録音と完全に一致する場合、Suno は著作権チェックにより生成を拒否することがあります。インスピレーション源として、自身が所有するオーディオまたは Suno が生成したオーディオを使用することを推奨します。対応する Python コード:
chirp-v5 を使用していますが、現在のリクエスト例では chirp-v6 を推奨しています。返却構造は同一です:
非同期コールバック
Suno による音楽生成には比較的長い時間がかかり、約 1~2 分を要します。API が長時間応答しない場合、HTTP リクエストは接続を維持し続けるため、追加のシステムリソースが消費されます。そのため、本 API では非同期コールバックもサポートしています。 全体のフローは次のとおりです。クライアントがリクエストを開始する際に、追加でcallback_url フィールドを指定します。クライアントが API リクエストを開始した後、API は直ちに結果を返し、その中には現在のタスク ID を表す task_id フィールド情報が含まれます。タスク完了後、生成された音楽の結果は POST JSON の形式でクライアントが指定した callback_url に送信され、その中にも task_id フィールドが含まれるため、タスク結果を ID によって関連付けることができます。
以下では、具体的な操作方法を例を通して見ていきます。
まず、Webhook コールバックは HTTP リクエストを受信できるサービスです。開発者は自身で構築した HTTP サーバーの URL に置き換える必要があります。ここではデモを容易にするため、公開 Webhook サンプルサイト https://webhook.site/ を使用します。このサイトを開くと、図のように Webhook URL を取得できます。
 この URL をコピーすれば、Webhook として使用できます。ここでのサンプルは https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2 です。
次に、フィールド
callback_url を上記の Webhook URL に設定し、同時に prompt を入力します。図のようになります。
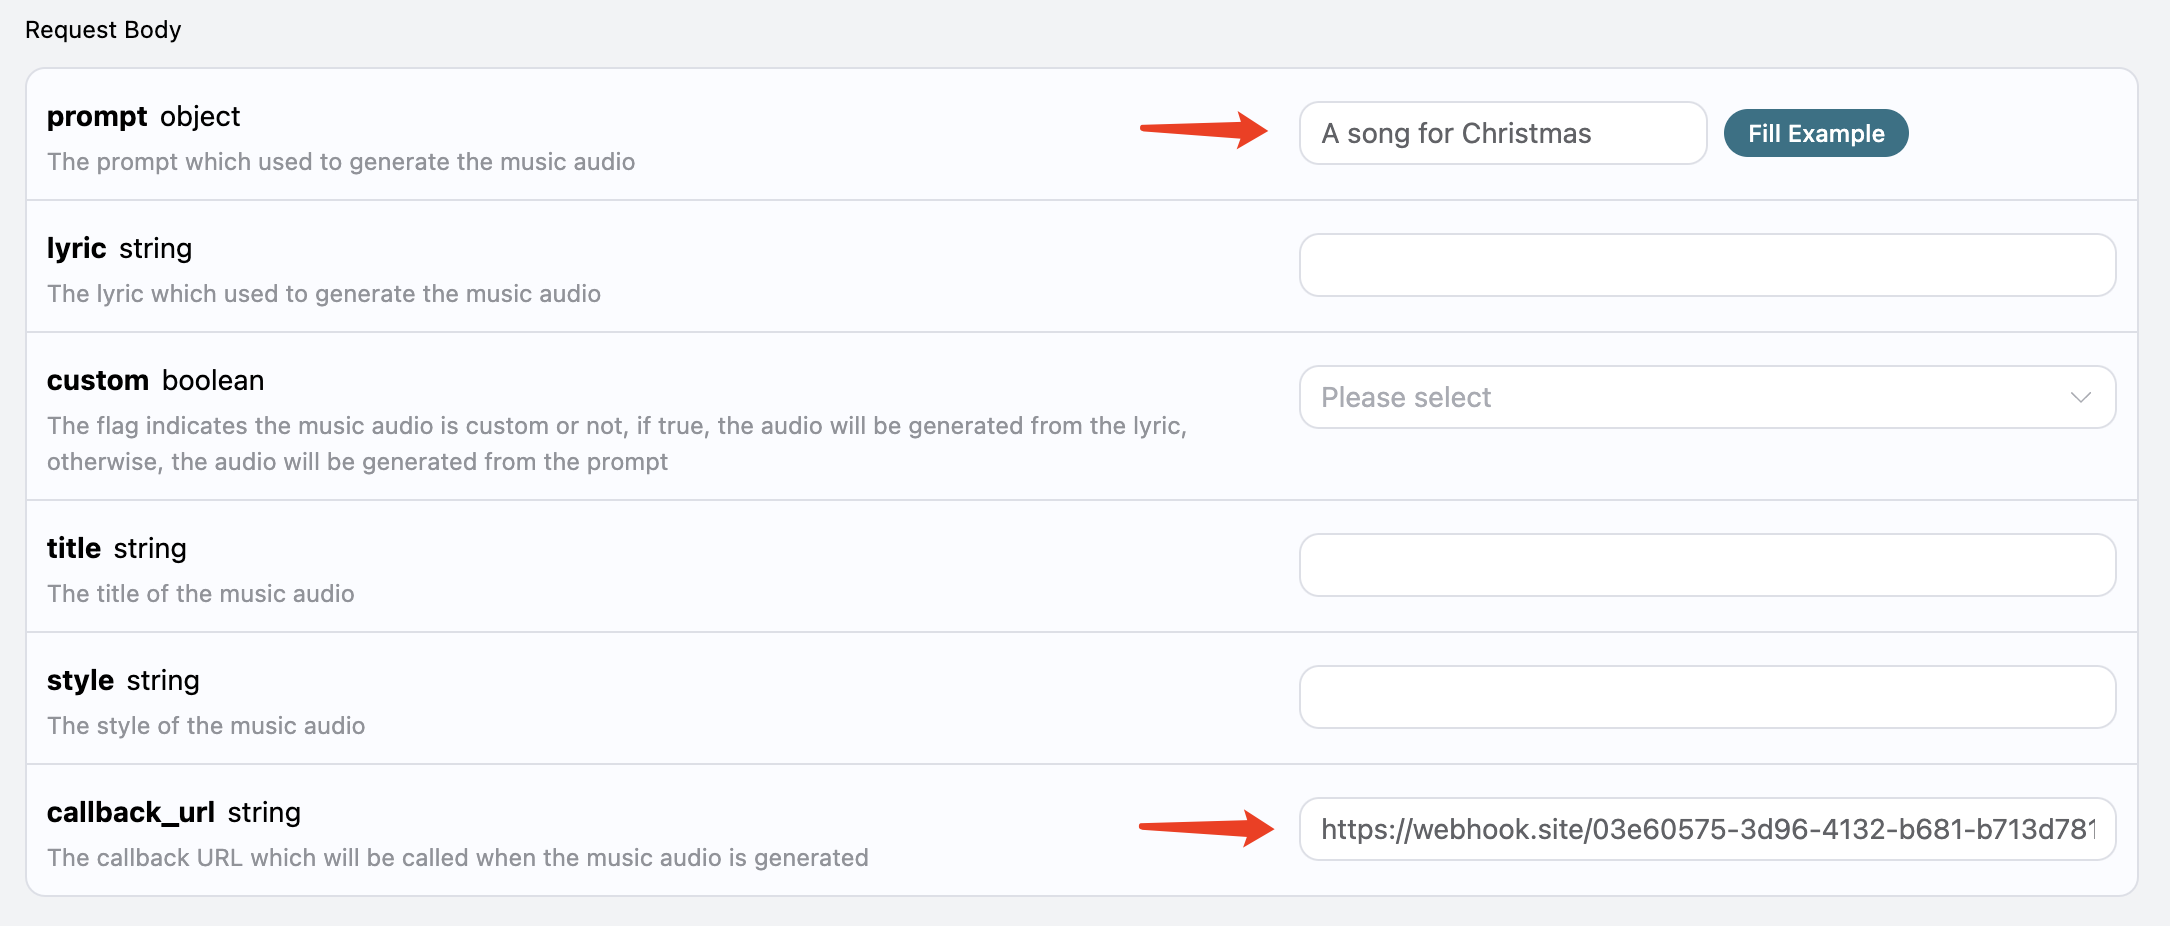 実行をクリックすると、以下のように直ちに結果が得られることがわかります。
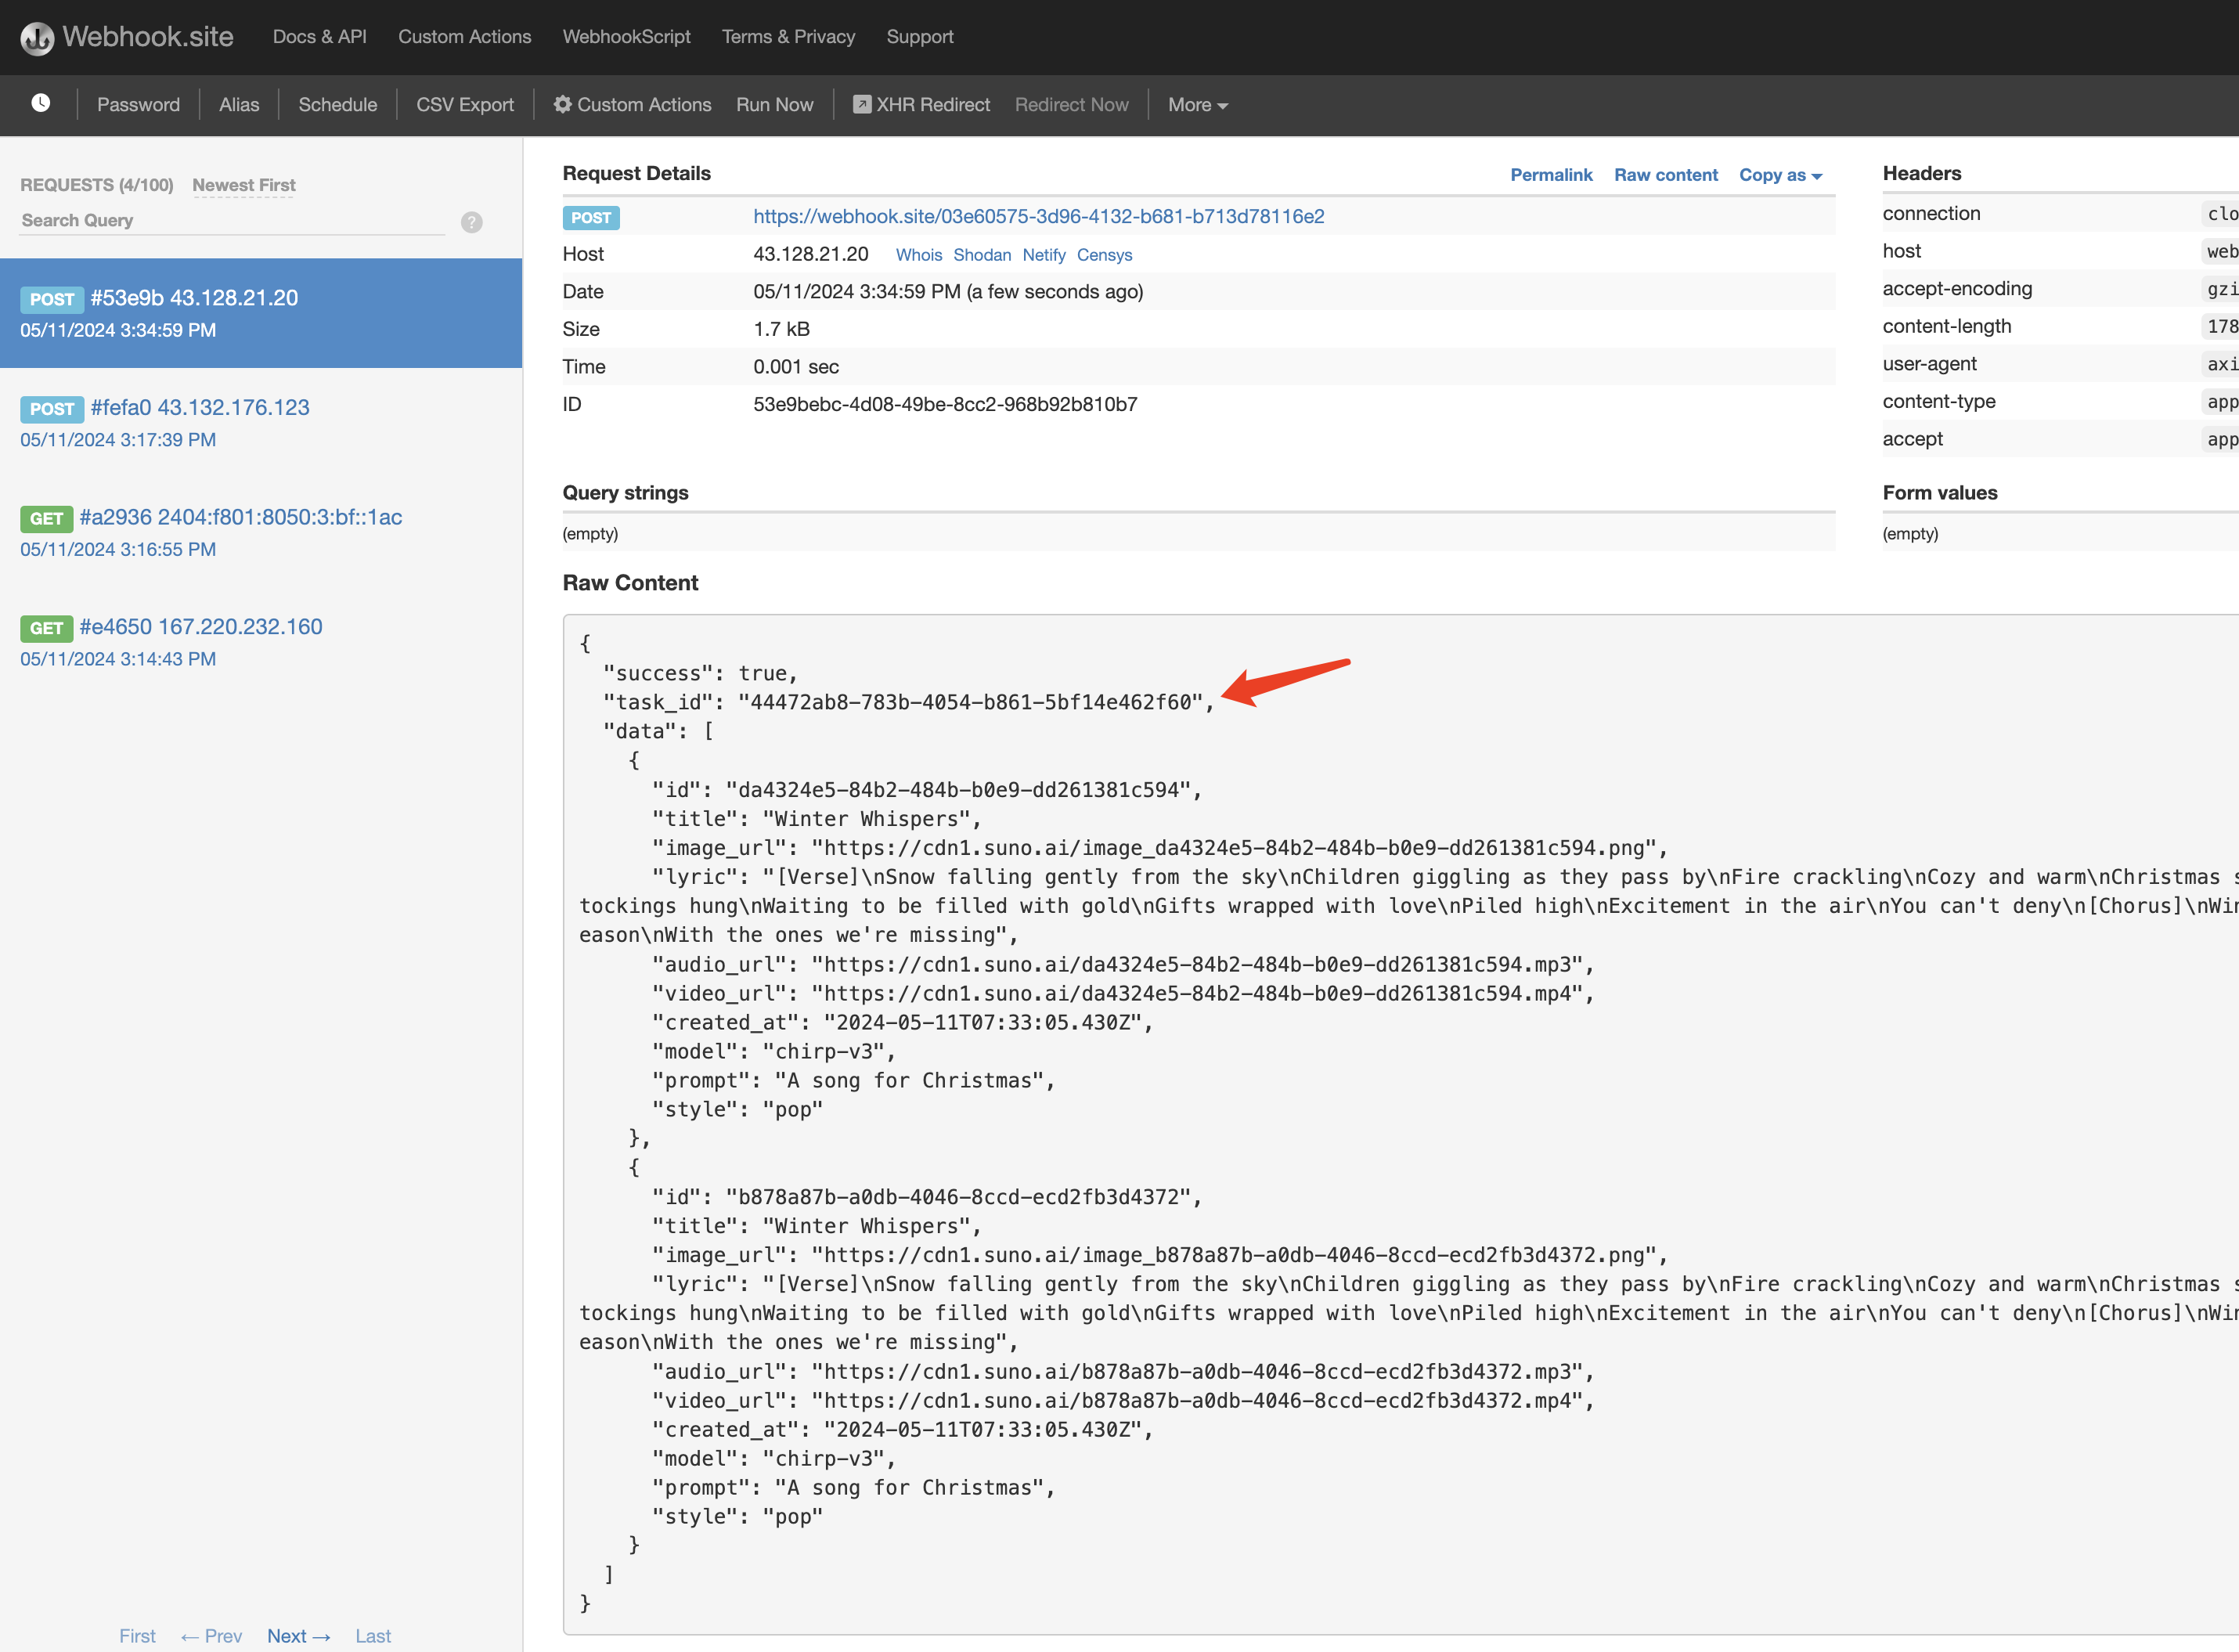 内容は以下のとおりです。
task_id フィールドがあることが確認でき、その他のフィールドはすべて上記と類似しています。このフィールドにより、タスクの関連付けを実現できます。
もちろん、ストリーミング呼び出しによって結果を取得することもできます。リクエストヘッダー内の accept の値を application/x-ndjson に設定するだけです。以下では、サンプル入力を例として示します。
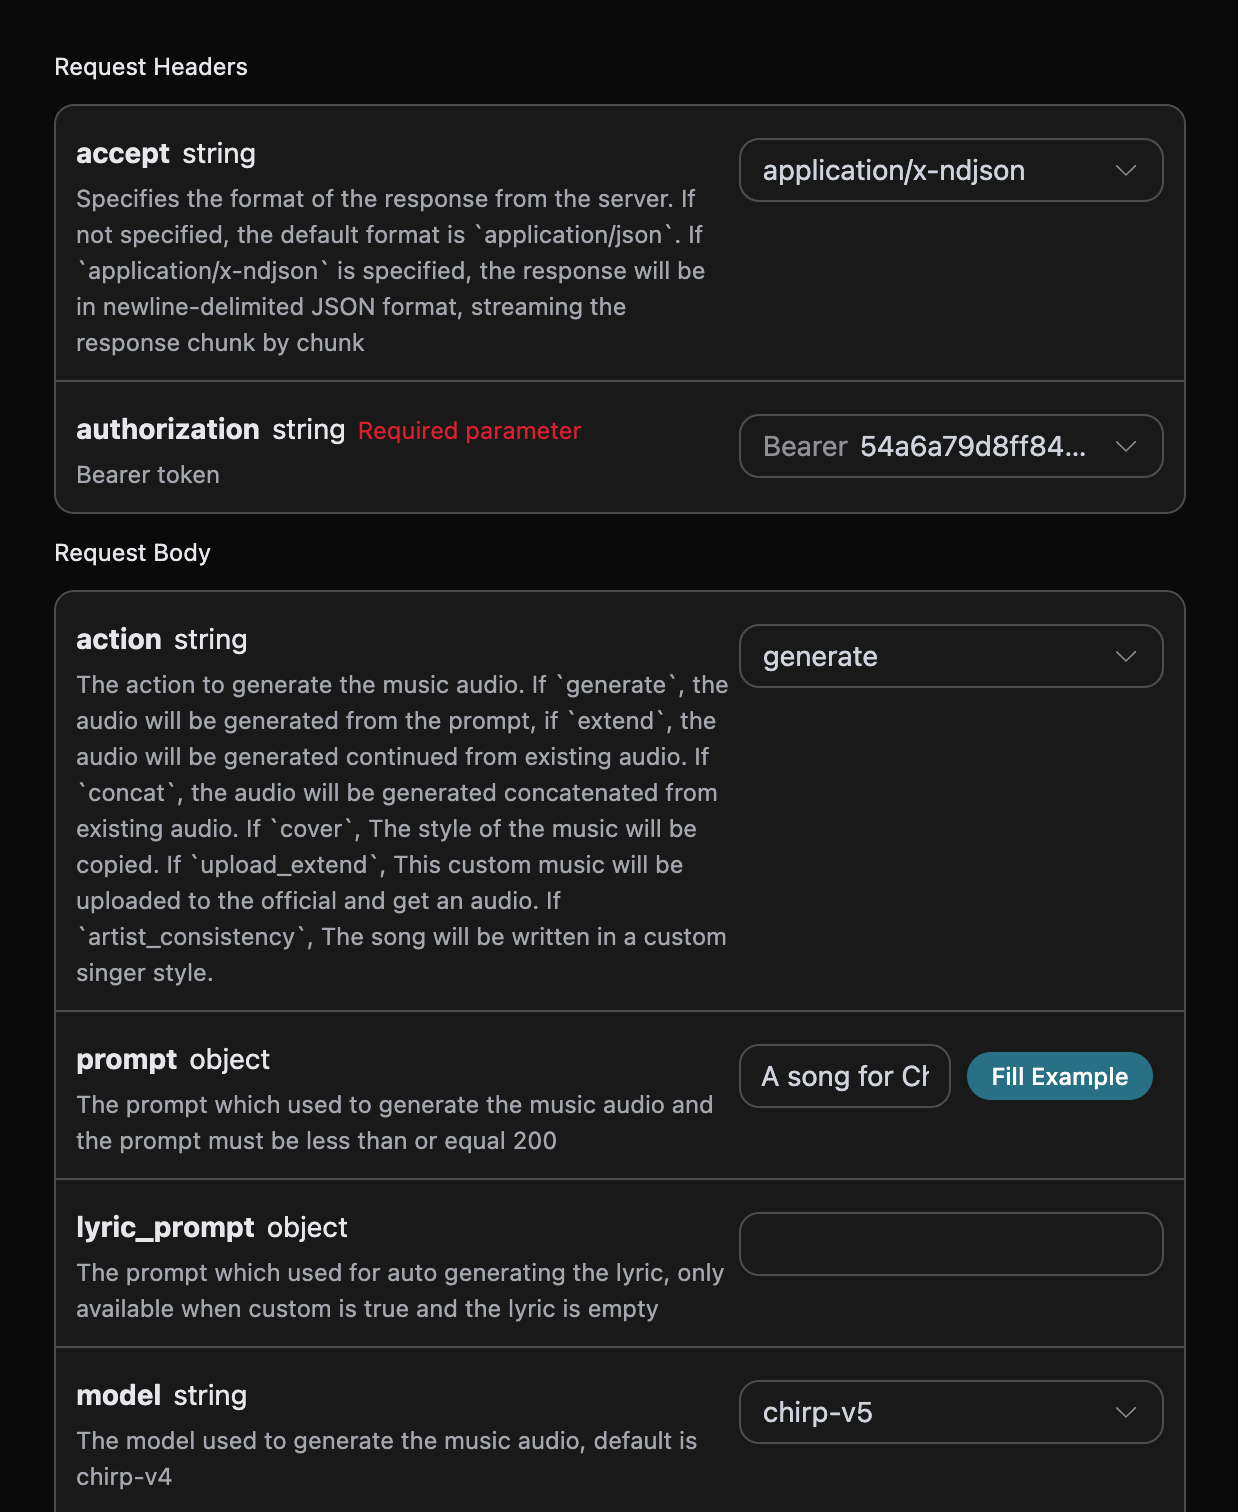
task_id に対して処理中のステータスと最終結果が順次プッシュされます。上記では、最初と最終状態の2つの実際のレスポンスのみを保持し、繰り返される中間更新は省略しています。
エラー処理
エラーが発生した場合、以下のようなエラー情報が返されます。error.code、error.message の一覧です。
注:上流アカウントによって、制限値やエラーメッセージが異なる場合があります。通常、chirp-v3-5/chirp-v4のstyle制限は低め(200)であり、chirp-v4-5以降では通常1000まで対応しています。旧上流に該当した場合、Tags too long.またはstyle must be less than or equal 120などの互換メッセージが表示されることがあります。 | ステータスコード |error.code|error.message| | ----------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|曲IDが存在しないか、オフラインになっています。| | 400 |bad_request|プロンプトが長すぎます。| | 400 |bad_request|タグが長すぎます。| | 400 |bad_request|アップロードされた音声が既存の作品と一致します。| | 400 |bad_request|instrumentalはブール値である必要があります| | 400 |bad_request|タイトルが長すぎます。| | 400 |bad_request|トピックが長すぎます。| | 400 |bad_request|styleは120以下である必要があります| | 400 |bad_request|customはブール値である必要があります| | 400 |bad_request|音声を延長する場合はaudio_idが必要です| | 400 |bad_request|音声を延長する場合はcontinue_atが必要です| | 400 |bad_request|continue_atは0より大きい数値である必要があります| | 400 |bad_request|音声を延長しinstrumentalがfalseの場合はlyricが必要です| | 400 |bad_request|音声を生成する場合はpromptが必要です| | 400 |bad_request|カスタム音声を生成する場合はlyricが必要です| | 403 |forbidden|プロンプトの形式が不正である可能性があります| | 403 |forbidden|プロンプトは著作権で保護されている可能性があります| | 403 |forbidden|プロンプトに不適切な内容が含まれていました| | 403 |forbidden|曲の説明がモデレーションの対象としてフラグ付けされました| | 403 |forbidden|曲の説明にアーティスト名が含まれていました| | 403 |forbidden|タグにアーティスト名が含まれていました| | 403 |forbidden|歌詞に著作権で保護された素材が含まれていました| | 403 |forbidden|曲の説明にプロデューサータグが含まれていました| | 403 |forbidden|一般的なopenAIエラー| | 403 |forbidden|プロンプトがモデレーションの対象としてフラグ付けされました| | 500 |api_error|曲の説明から歌詞を生成できません| | 500 |api_error|不明なエラーによりジョブが失敗しました| | 500 |api_error|システム内に利用可能なワーカーがありません| | 500 |api_error|サービスはメンテナンス中のため、生成は一時停止されています| | 504 |timeout|音声生成の待機中にタイムアウトしました|