

上表的Suno 现已支持lyric与style限制为自定义模式(custom为true)下的上限。非自定义的灵感模式(custom为false)只填prompt,其长度上限为 500 字符(各模型一致)。
chirp-v6、chirp-v6-wild 和 chirp-v6-mini。推荐使用 chirp-v6;旧模型名称继续兼容。
然而 Suno 官方是并没有提供 API 的,AceDataCloud 提供了一套 Suno 的 API,模拟对接了 Suno 官方,可以方便快捷地生成想要的音乐。
申请和使用
要使用 Suno Audios Generation API,首先到 Ace Data Cloud 控制台 获取您的 API Token,留作备用。 如果你尚未登录或注册,会自动跳转到登录页面邀请你注册和登录,完成后会自动返回当前页面。
一个 API Token 即可调用平台所有服务,无需为每个服务单独申请。 首次申请会赠送免费额度,可免费体验;额度不足时可在 控制台 充值通用余额。
📘 完整文档:Suno Audios Generation API →
基本使用
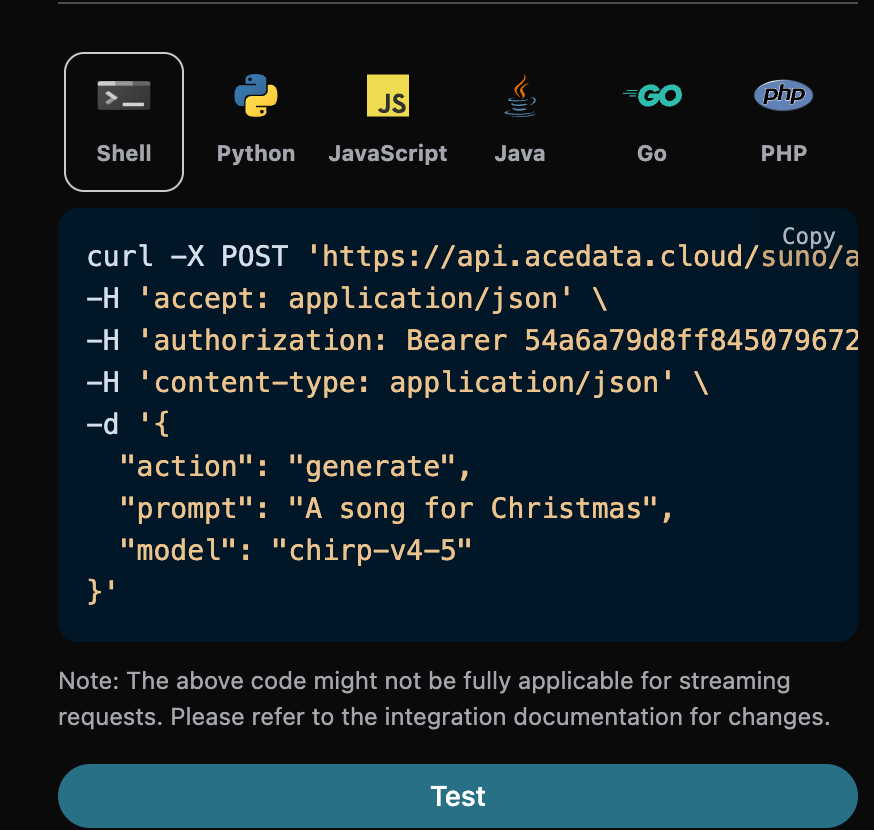
想些什么歌曲,可以任意输入一段文字,比如我想生成一个关于圣诞的歌曲,就可以输入a song for Christmas,如图所示:
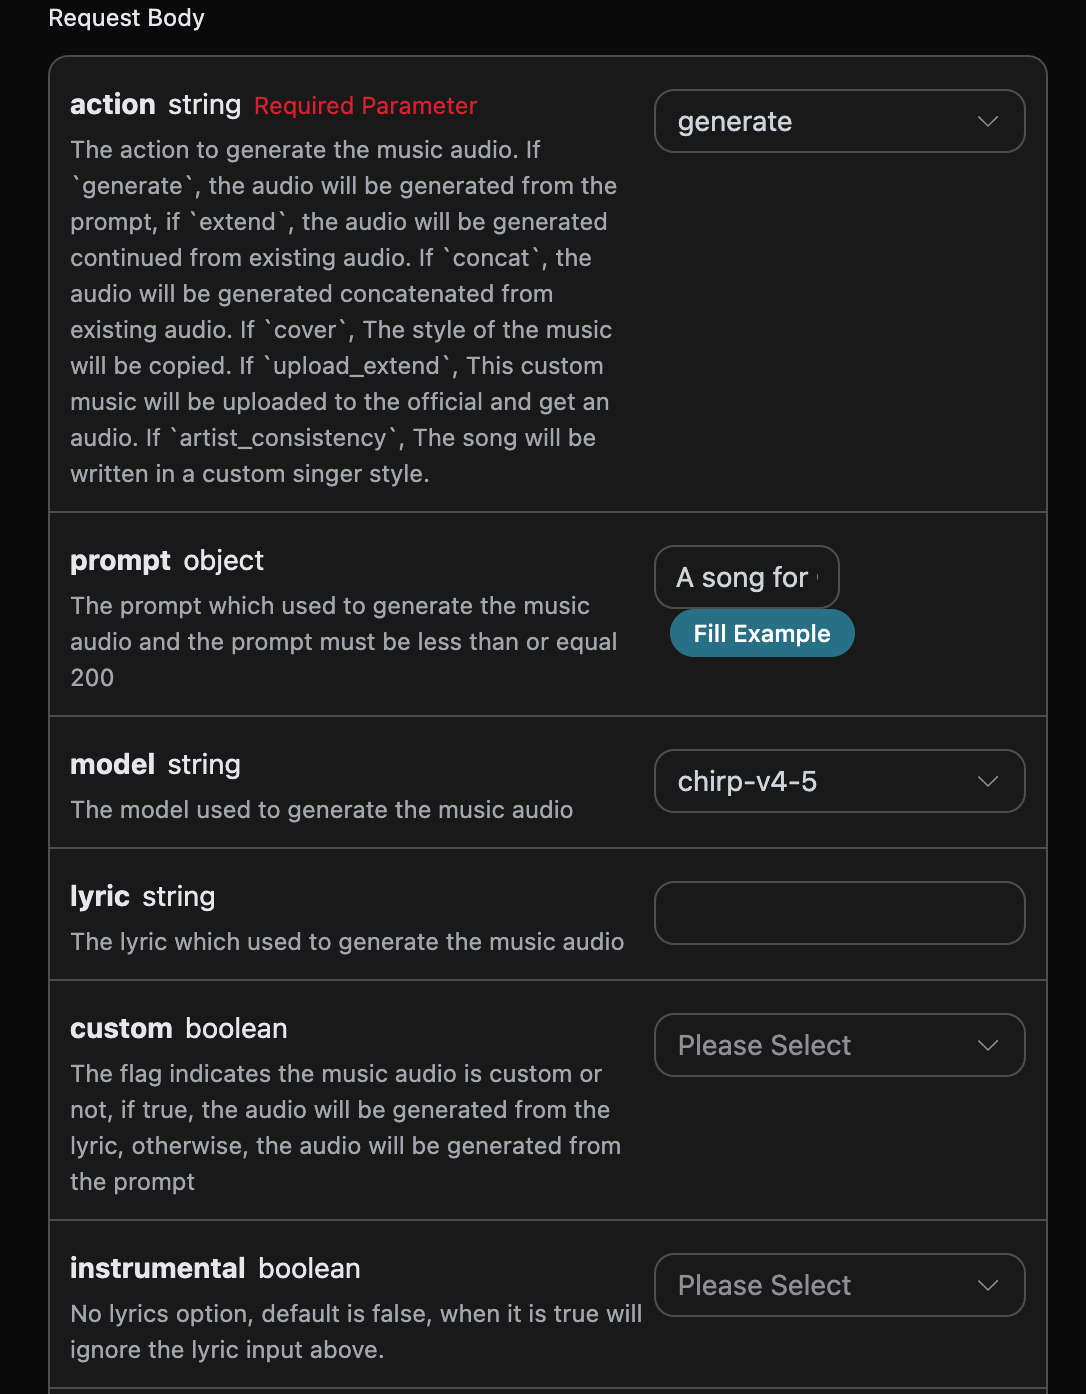
accept:想要接收怎样格式的响应结果,这里填写为application/json,即 JSON 格式。authorization:调用 API 的密钥,申请之后可以直接下拉选择。
action:音频任务类型,默认是generate。支持生成、续写、翻唱、拼接、分轨、添加音轨、提取指定音轨、生成音效和调整速度等操作,统一通过POST /suno/audios调用。prompt:Suno 官方的灵感模式提示词(custom为false时生效),最大 500 字符。model:此次音乐生成任务的模型。v6 系列包含chirp-v6、chirp-v6-wild和chirp-v6-mini;旧模型名称继续兼容。max_mode:增强生成模式。generate仅在custom与max_mode均为true时启用,费用为 1.12 Credits;add_stem可直接启用,费用为 1.344 Credits。关闭或省略时分别为 0.56 和 0.672 Credits。variety:生成结果的多样性强度,可选off、normal、high、extra、max。仅用于generate和add_stem,其他 action 传入会返回 400。lyric:Suno 官方的自定义模式的歌词内容。chirp-v3-5与chirp-v4最大 3000 字符;chirp-v4-5及以上(含chirp-v5、chirp-v5-5)最大 5000 字符。custom:是否采用自定义模式,默认是:false。instrumental:Suno 官方的灵感模式的纯音乐选项。title:Suno 官方的自定义模式的音乐标题。chirp-v3-5、chirp-v4最大 80 字符;chirp-v4-5及以上最大 100 字符。style:Suno 官方的自定义模式音乐风格。chirp-v3-5与chirp-v4最大 200 字符;chirp-v4-5及以上(含chirp-v5、chirp-v5-5)最大 1000 字符。negative_tags:自定义生成时希望排除的音乐风格或流派,也可用于replace_section。本接口目前未对该字段设置固定字符数上限;过长内容仍可能无法处理,建议保持描述精简。audio_weight:音频或声音特征的影响权重,范围 0-1,0也是有效值。可用于生成、续写、翻唱、添加音轨和声音一致性等操作;没有参考音频或声音特征时,模型可能弱化或忽略该值。audio_id:参考音乐的 ID,用于翻唱、续写、分轨等后续操作。音频文件仍可下载,不代表该 ID 的后续处理始终可用;若返回suno_processing_unavailable,请保留task_id和trace_id联系支持。overpainting_start/overpainting_end:为已有纯音乐补充人声的起止时间,单位秒。underpainting_start/underpainting_end:为清唱加伴奏的起止时间,单位秒。persona_id:通过 Persona 或声音创建接口获得的声音 ID,不是歌曲的audio_id。continue_at:续写边界,单位为秒。例如,213.5 表示从第 3 分 33.5 秒处开始生成后续片段。lyric和style只引导边界之后的新内容,不会替换源音频中边界之前的歌词或演唱。style_influence:自定义模式下的风格影响力,范围 0-1,越大通常越贴合所选风格;0会作为有效值传递。replace_section_end:替换片段的最终时间。replace_section_start:替换片段的起始时间。vocal_gender:控制男女声偏好,女声f,男声m,4.5 及以上模型有效;为偏好项,不保证严格遵循。weirdness:自定义模式下的怪异度,范围 0-1,越大通常越具创意和实验性;0会作为有效值传递。duration:期望的歌曲时长,单位秒,需为整数,取值范围 10 到 360。当前仅generate使用该参数,具体效果取决于模式和模型。它是一个倾向性提示而非硬性约束:模型会参考它,但不保证达到,实际成品时长以响应中的duration字段为准,通常短于期望值。
声音 ID 的适用范围
generate、cover、upload_cover、artist_consistency、artist_consistency_vox 可以使用 persona_id。后两个 action 必须提供 persona_id;也可以同时提供创建该 Persona 时所用歌曲的 audio_id。
extend、upload_extend 不使用额外的 persona_id。mashup、inspo 是否支持声音 ID 取决于所选服务通道;其他 action 不保证应用该字段,请按各操作说明使用。vocal_gender 是可选的性别偏好,不能代替声音 ID。
后续创作操作需要有效的源 audio_id;mashup 需要至少两个 mashup_audio_ids。缺少必要来源或时间参数时会返回 HTTP 400。
高级参数适用范围
平台会校验参数类型和数值范围,但不会仅因 action 不同拒绝这些可选调节项;具体效果由操作、模式和模型决定。
lyric_prompt:生成歌词的 prompt,当且仅当custom为true并且lyric没有传的时候生效。callback_url:需要回调结果的 URL。async:可选,设为true时接口立即返回task_id,无需提供callback_url,随后通过对应的任务查询接口轮询获取结果。
- success:生成是否成功,如果成功则为
true,否则为false - data:是一个列表,包含了生成的歌曲的详细信息。
- state: 歌曲生成状态,主要包含四种,具体的如下:
- succeeded:生成成功
- pending:队列中
- running:执行中
- error:失败
- id:歌曲 ID
- title:歌曲的标题
- image_url:歌曲的封面图片
- lyric:歌曲的歌词
- audio_url:歌曲的终态音频地址。平台会优先返回 Ace Data Cloud CDN 地址;若持久化失败,可能返回原始媒体地址,请及时下载。
- video_url:歌曲的视频文件,打开就是一个 mp4 视频。
- created_at:创建的时间
- model:使用的模型,一般是最新的 v3 模型
- style:风格
- state: 歌曲生成状态,主要包含四种,具体的如下:
自定义生成
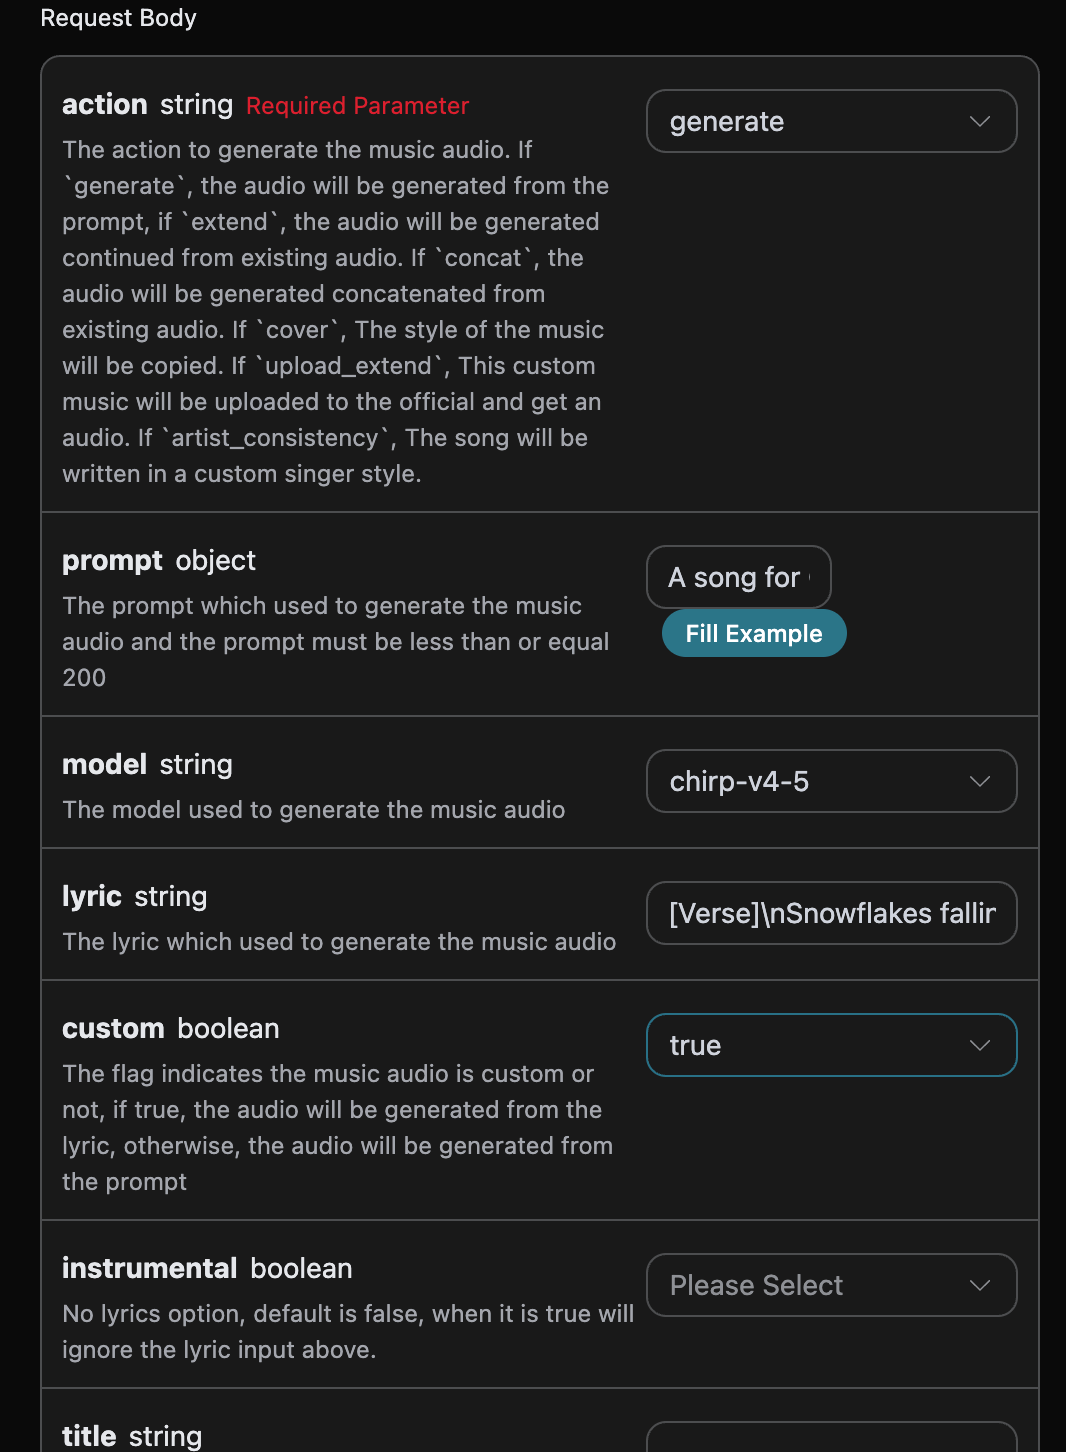
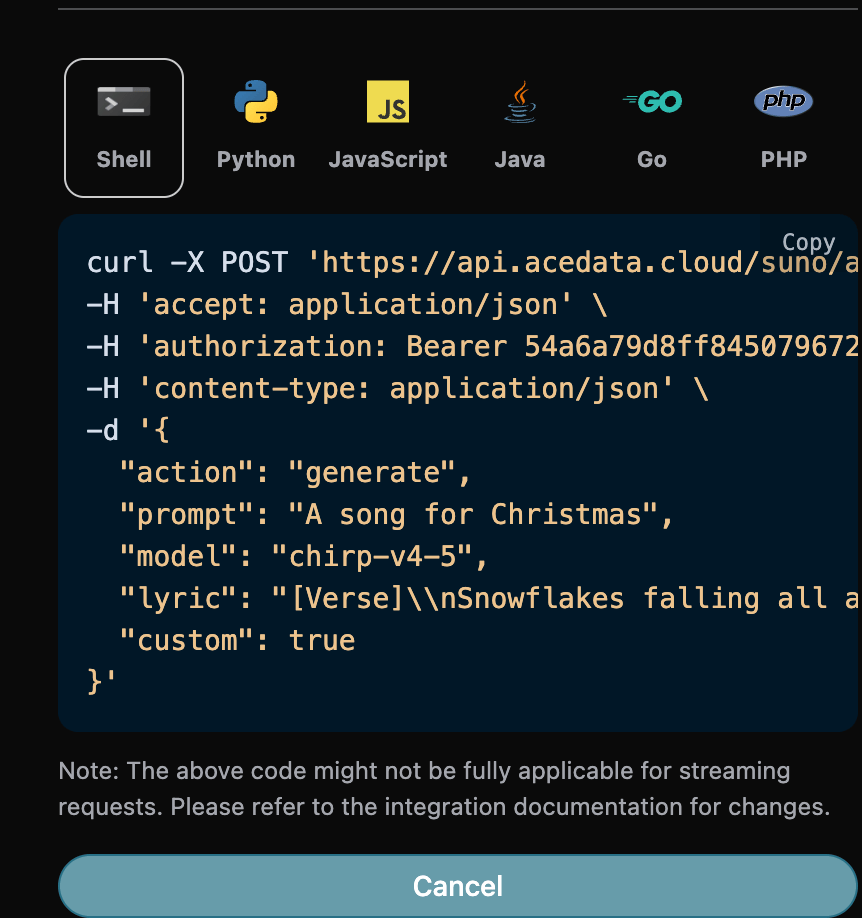
如果想自定义生成歌词,可以输入歌词: 这时候lyric 字段可以传入类似如下内容:
注意,这里的歌词中 \n 是换行符,如果你不知道如何生成歌词,可以使用 AceDataCloud 提供的歌词生成 API 来通过 prompt 生成歌词,API 是 Suno Lyrics Generation API。
接下来我们要根据歌词、标题、风格自定义生成歌曲,就可以指定如下内容:
- lyric:歌词文本
- custom:填写为
true,代表自定义生成,该参数默认为 false,代表使用prompt生成。 - title:歌曲的标题。
- style:歌曲的风格,选填。
自定义歌手风格生成功能
如果想使用歌手风格来生成歌曲的话,首先通过上文的基本使用生成一首歌曲, 最后得到了需要设置这个歌曲为歌手风格,然后需要进入Suno Persona API根据官方生成的音乐 IDaudio_id 来生成一个歌手风格的 id 参数 persona_id,具体的参数如下图所示:
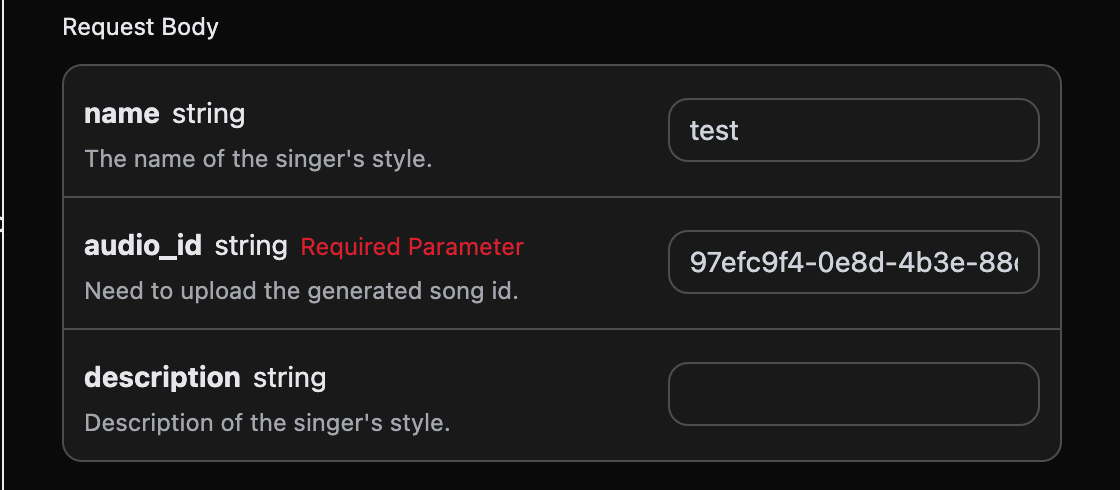
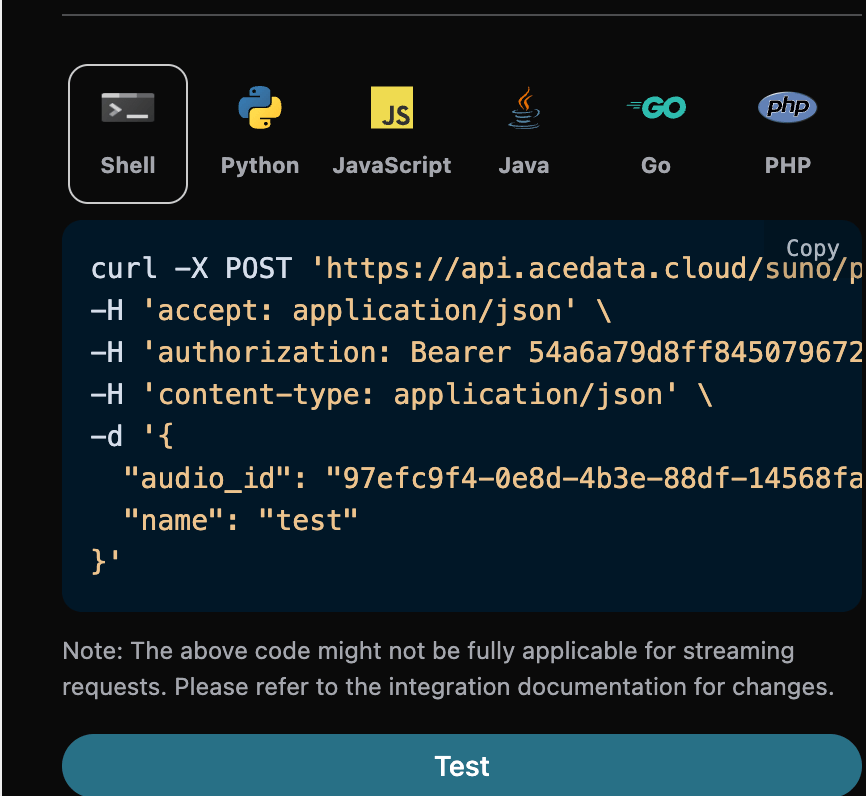
audio_id 和 persona_id 分别为 97efc9f4-0e8d-4b3e-88df-14568fa1b11f、e0d7319e-aa2a-44cb-b00a-916218d7cb0b 为此次的示例数据。 然后可以将参数 action 设置为 artist_consistency (如果是新版的歌手风格Persona-v2-vox,action 必须设置为 artist_consistency_vox),并且输入需要继续生成歌曲的 ID 、 歌手风格 ID,填写样例如下:
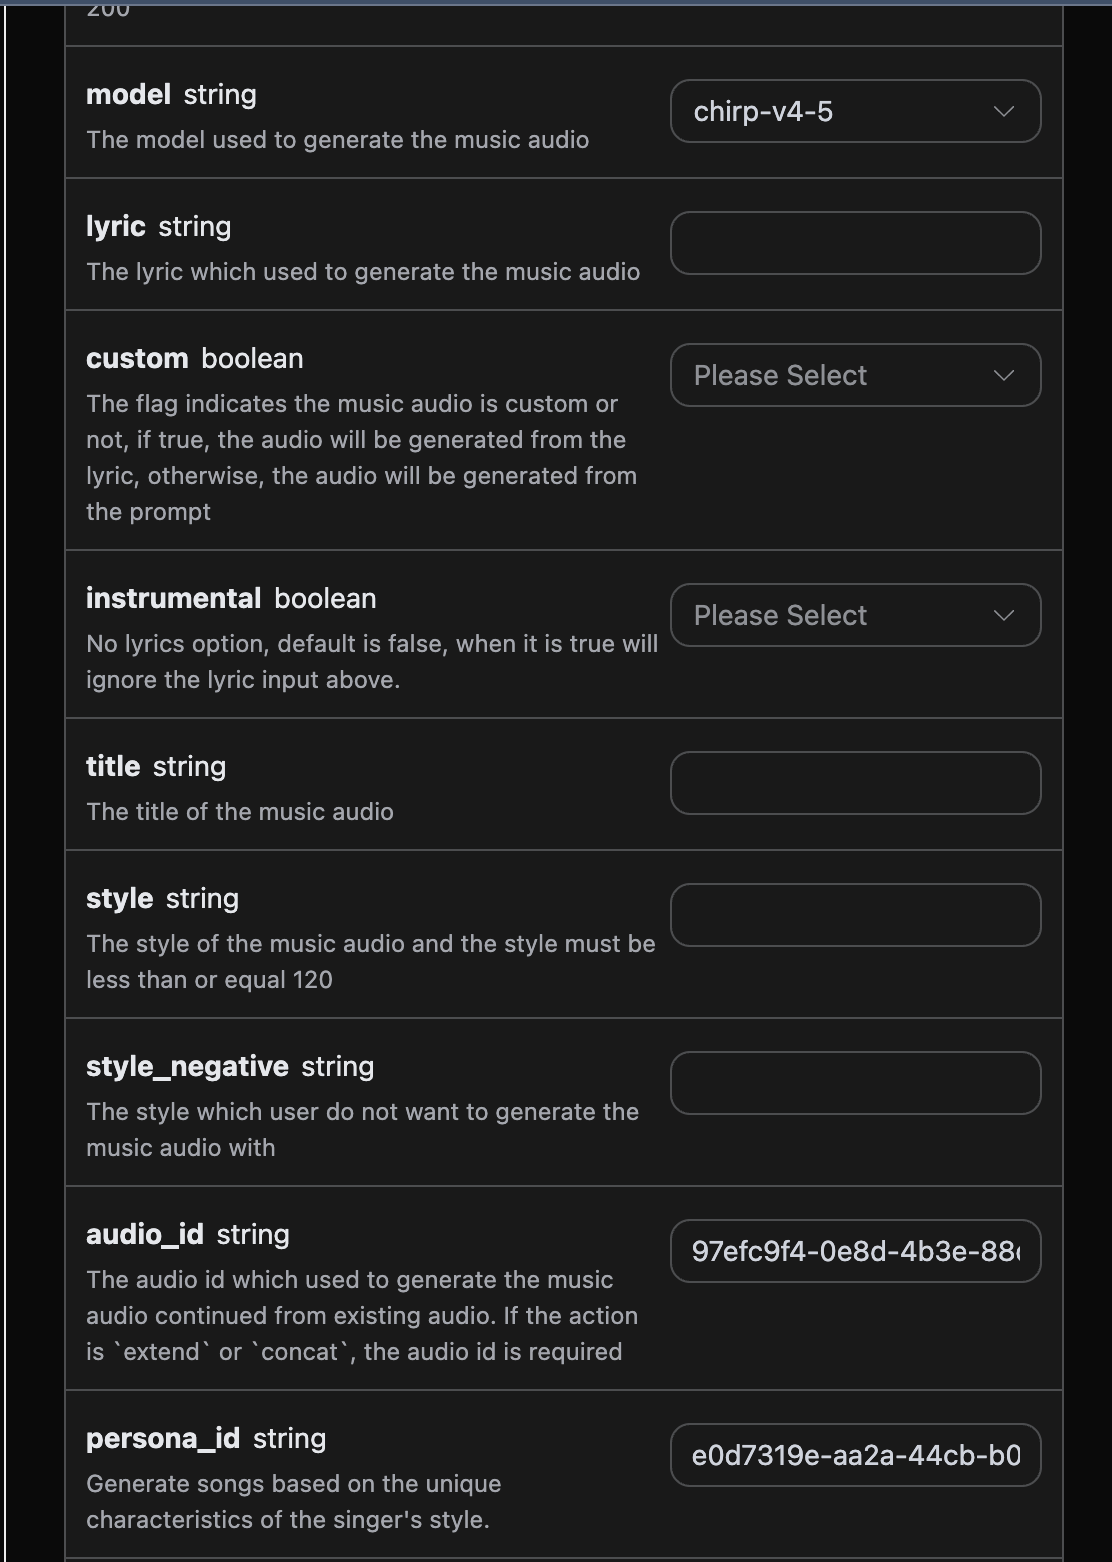
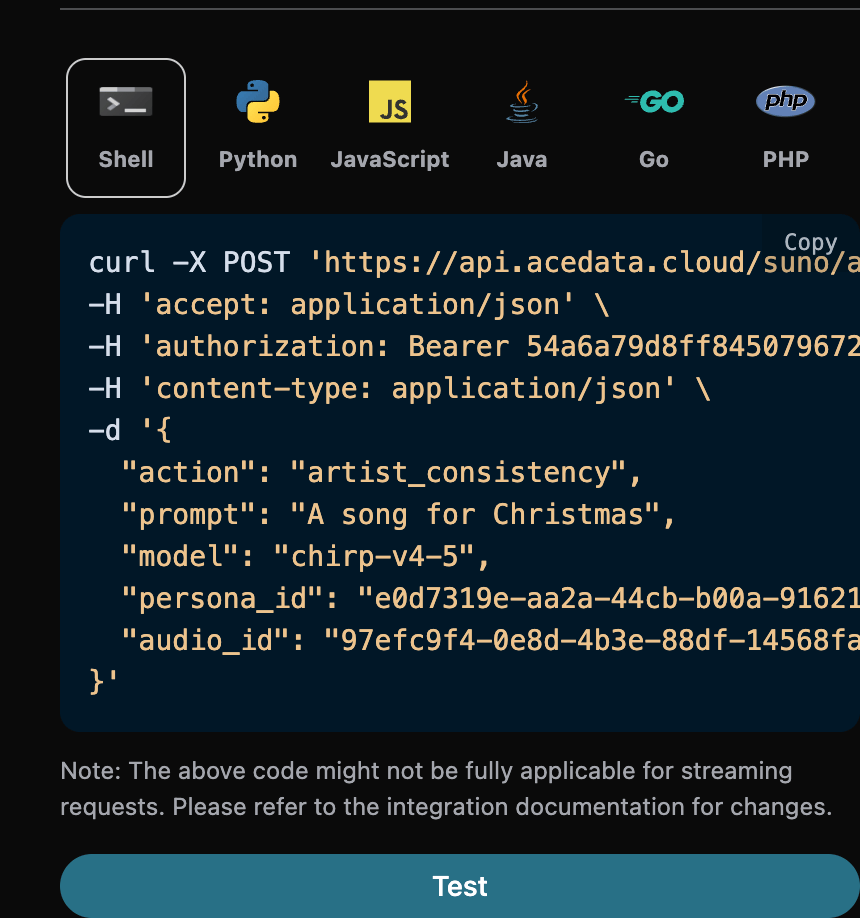
继续生成功能
如果想对已经生成的 Suno 歌曲进行继续生成的话,可以将参数action 设置为 extend ,并且输入需要继续生成歌曲的 ID,歌曲 ID 的获取是根据基本使用来获取,通过上文可知,这时候可以看到歌曲的 ID 为:
注意,这里的歌词中 id 是生成后歌曲的 ID,如果你不知道如何生成歌曲,可以参考上文的基本使用来生成歌曲。
如果想对自己上传的歌曲进行继续生成的话,可以将参数 action 设置为 upload_extend ,并且输入需要继续生成自定义上传的歌曲 ID,歌曲 ID 的获取是使用 Suno Upload Generation API来获取,如下图所示:
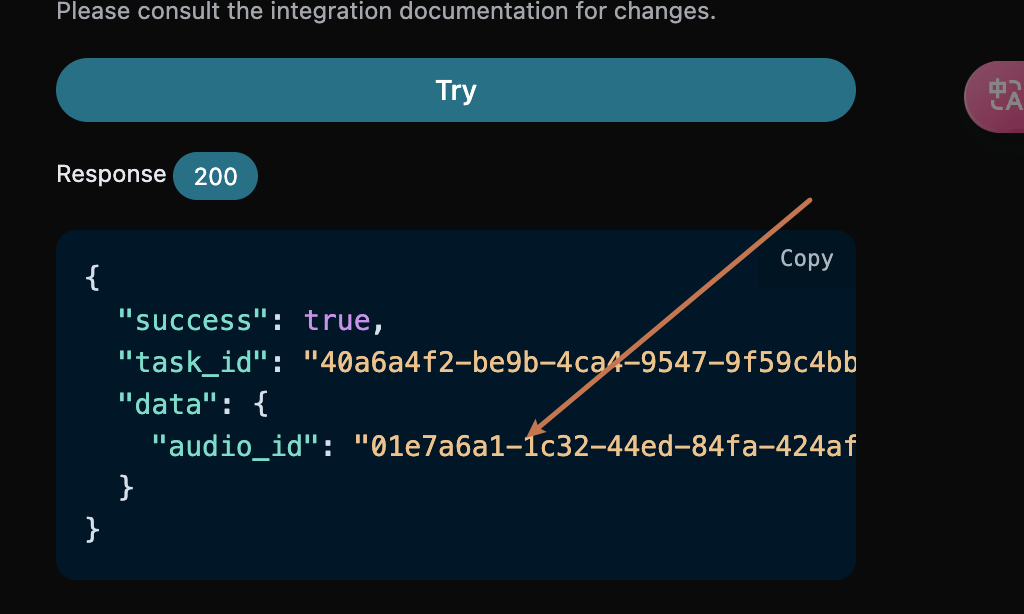
- lyric:只用于引导
continue_at之后新生成片段的歌词,不会替换源音频中该时间点之前的歌词。 - custom:填写为
true,代表自定义生成,该参数默认为 false,代表使用prompt生成。 - style:续写片段的歌曲风格,选填。
- continue_at:续写边界,单位为秒。例如,213.5 表示从第 3 分 33.5 秒处开始生成后续片段。
extend 和 upload_extend 的 continue_at 必须大于 0,支持小数秒,例如 30.792;提交时不会取整。
填写样例如下:extend用于接着已有歌曲往后创作,不是给整首歌曲换词。若希望整首歌曲从头使用新歌词,请使用generate重新生成;若希望参考已有歌曲重新演绎,可使用cover。传入一整首新歌词时,continue_at之前的原歌词仍不会被替换。
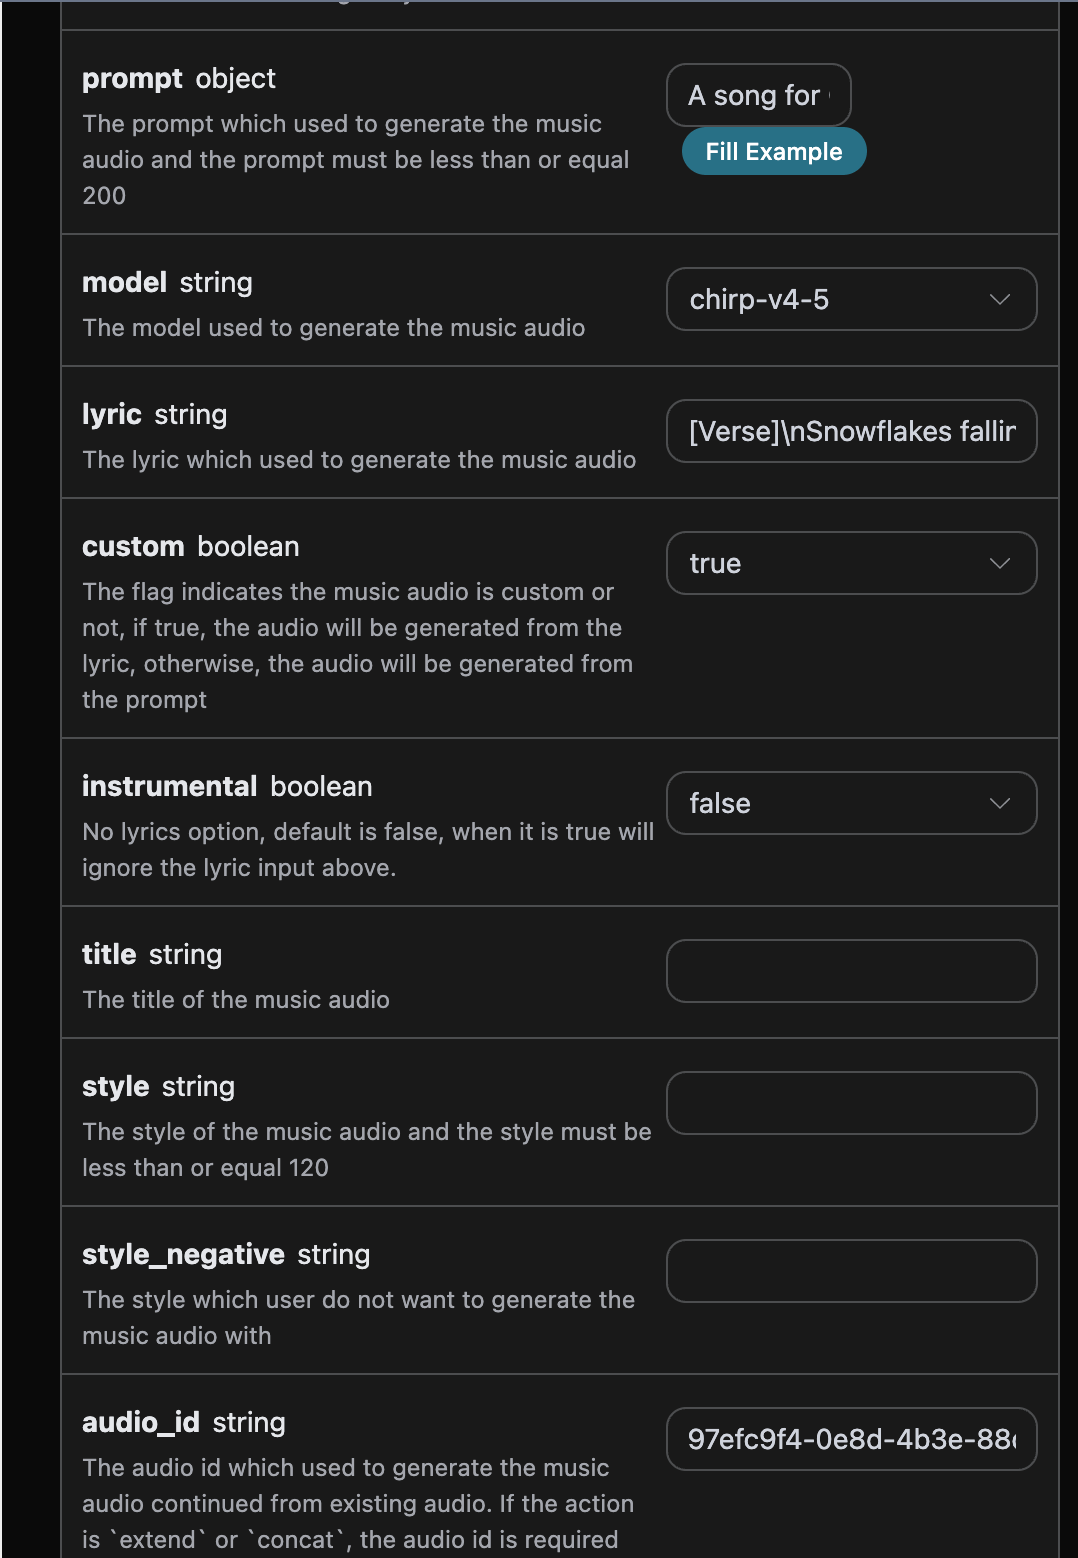
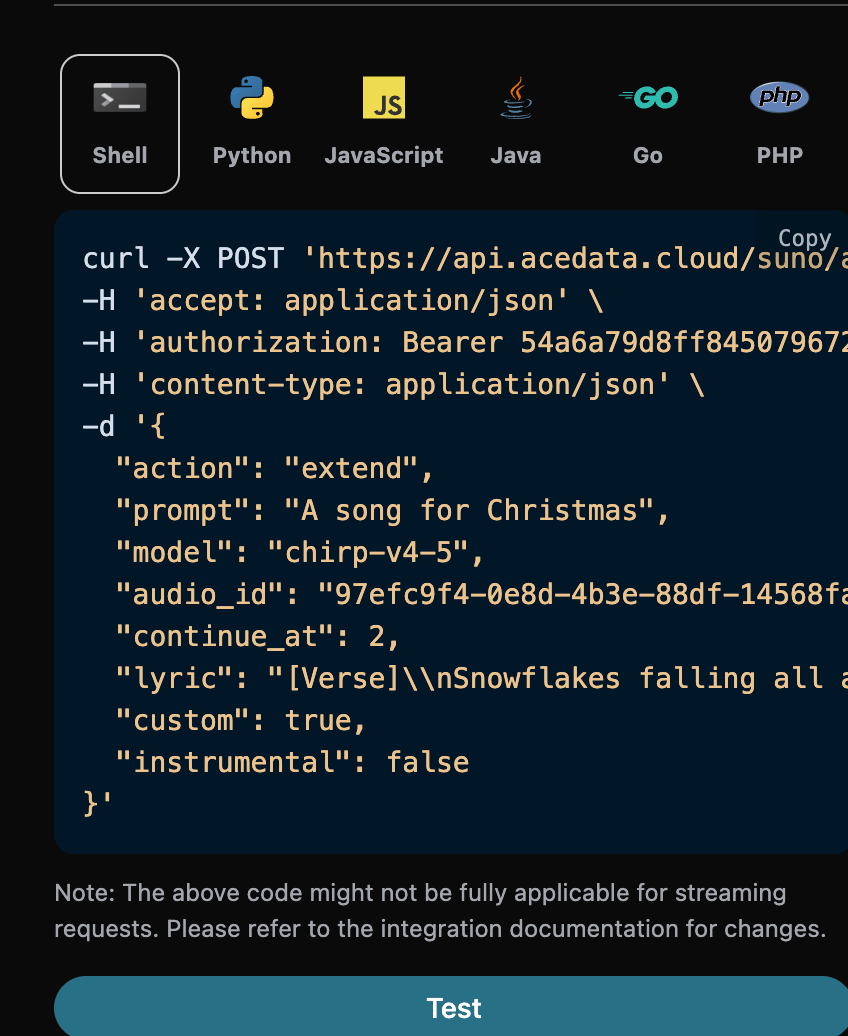
continue_at 为 2 秒,因此只有前 2 秒属于续写边界之前的原内容。实际接近歌曲结尾续写时,应将该值设为期望开始续写的秒数,并仅在 lyric 中提供边界之后要唱的新段落。
对应的 Python 代码:
lyric 会返回此次续写任务使用的歌词文本。该字段不是完整成品音频的逐字转写;对于 extend,continue_at 之前的源音频仍使用原歌词,新歌词只用于引导续写片段。
获取完整歌曲
当前模型的extend 结果通常已包含 continue_at 之前的源音频和边界之后的新内容,请先根据返回音频的实际时长与内容判断是否已经是完整歌曲。若返回的是独立续写片段,或者需要将多次续写历史显式合并为一首歌,再使用拼接功能:
- action:内容为
concat。 - audio_id:最后一个续写片段的 ID。
音乐翻版
当基于原有的歌曲继续生成歌曲之后,返回的歌曲的风格可能不太合适。如果要对原先生成的歌曲(若是自定义上传的音乐也支持)进行翻版,需要使用音乐翻版方法,就可以指定如下内容:- action:内容为
cover,当是对自定义上传的音乐进行翻版操作的时候必须指定内容为:upload_cover。 - audio_id:之前生成歌曲的 ID。
persona_id。通过 /suno/voices 创建的私有声音需要先在 /suno/upload 中携带相同的 persona_id 上传原曲,再使用返回的 audio_id 进行 upload_cover。各步骤须使用相同的服务通道。无需额外指定 vocal_gender,性别偏好不能代替声音 ID。
比如原先生成后的歌曲 ID 是:0a1e1b10-c36a-41c9-9bfb-b26d9d25db98,那么可以设置参数如下:
替换片段
当生成歌曲之后需要进行替换歌曲片段单独操作的二次创作时,可以对歌曲的某个片段进行替换操作。⚠️ 注意:参数说明如下:replace_section_result_mode默认为full_song:系统会分别拼接 2 个新生成的候选,并返回 2 首完整歌曲。若只需要尚未拼接的替换片段候选,请显式设置为candidates,然后选取候选调用 音乐拼接。
- action:内容为
replace_section。 - audio_id:原始歌曲(被替换的源歌曲)的 ID。
- model: 歌曲生成模型。
- lyric: 替换后的完整歌词(包含被替换段及其上下文,与
prompt中的内容保持一致)。 - prompt:需要替换的那一段新歌词。
- style:歌曲的风格,选填。
- negative_tags:希望排除的风格或流派,选填。
- replace_section_start:被替换片段在原曲中的起始时间(秒),必填且不得小于 0。
- replace_section_end:被替换片段在原曲中的终止时间(秒),必填且必须大于起始时间。
- replace_section_result_mode:返回模式,默认为
full_song。full_song分别拼接 2 个候选并返回 2 首完整歌曲;candidates返回 2 个尚未拼接的候选片段。
步骤一:发起替换片段任务
比如原先生成后的歌曲 ID 是:18db7ed0-2b8a-41db-91c1-b0781dcca0d4(时长 94.12 秒),希望把第 30 秒到第 60 秒处的副歌替换为新的歌词,那么可以设置参数如下:replace_section_result_mode 设为 candidates,则返回 2 个尚未拼接的替换片段,结构与下方示例一致:
candidates 模式下,返回的两条音频时长(45.16 秒、33.8 秒)远短于原曲(94.12 秒),它们是包含少量上下文的替换片段,并不是整首歌曲。可以挑选满意的候选继续手动拼接。默认 full_song 模式则会完成两次拼接,直接返回 2 首完整歌曲。
直接返回完整歌曲
如果希望直接获得完整歌曲,可以在步骤一把replace_section_result_mode 设为 full_song。接口会分别拼接两个候选并返回 2 首完整歌曲;此时无需再调用 concat。
步骤二:将替换片段拼接回原曲
针对上面挑选的片段(例如364f9d8b-ca25-463b-9a5e-d0b7139e2d6a),按 音乐拼接 一节的方法发起 concat 任务:
duration 已恢复成完整歌曲长度(105.28 秒,约等于原曲长度),audio_url 指向的就是替换完成后的整首歌。这就完成了”生成 → 替换片段 → 拼接整曲”的二次创作流程。
声曲分离
当生成歌曲之后需要进行伴奏和人声单独操作的二次创作时,可以分离纯音乐伴奏和清唱人声。就可以指定如下内容:- action:内容为
stems。 - audio_id:之前生成歌曲的 ID。
全轨道声曲分离
任务会等待全部音轨生成完成后才返回成功终态。处理中出现可播放地址不代表整组音轨已经完成。 当生成歌曲之后需要进行全轨道声曲分离操作时,就可以指定如下内容:- action:内容为
all_stems。 - audio_id:之前生成歌曲的 ID。
添加音轨
add_stem 为指定音频生成目标乐器或声音轨,通过 POST /suno/audios 调用。
- 必填:
action、audio_id、stem_type。 - 可选:
model、prompt、title、style、negative_tags、weirdness、style_influence、audio_weight、max_mode、variety。 - 计费:普通模式 0.672 Credits;
max_mode为true时 1.344 Credits。
提取音轨
extract_stem 从指定音频中提取目标音轨,同时返回移除该音轨后的互补版本,通过 POST /suno/audios 调用。
- 必填:
action、audio_id、stem_type。 - 可选:
audio_format,当前公共双通道契约仅支持mp3。 - 计费:1.12 Credits。
data 保留扁平音频列表,stem_sets 表示目标音轨与互补音轨的对应关系:
生成音效
sounds 根据文字描述生成一次性或可循环音效,通过 POST /suno/audios 调用。
- 必填:
action、sound、sound_type。 - 可选:
model、bpm、key、audio_format;audio_format当前仅支持mp3。 sound_type:one-shot或loop。- 计费:0.112 Credits。
调整音频速度
adjust_speed 调整指定音频的播放速度,通过 POST /suno/audios 调用。
- 必填:
action、audio_id、speed_multiplier、title。 - 可选:
keep_pitch。 speed_multiplier:范围 0.25–4。- 计费:0.28 Credits。
自定义生成的高级参数
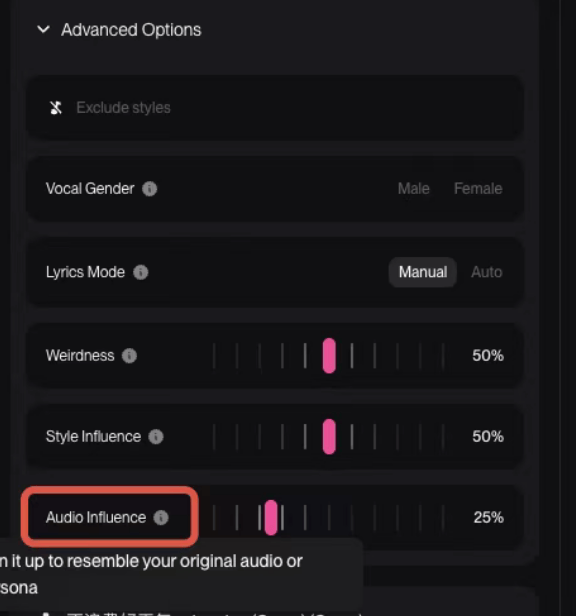
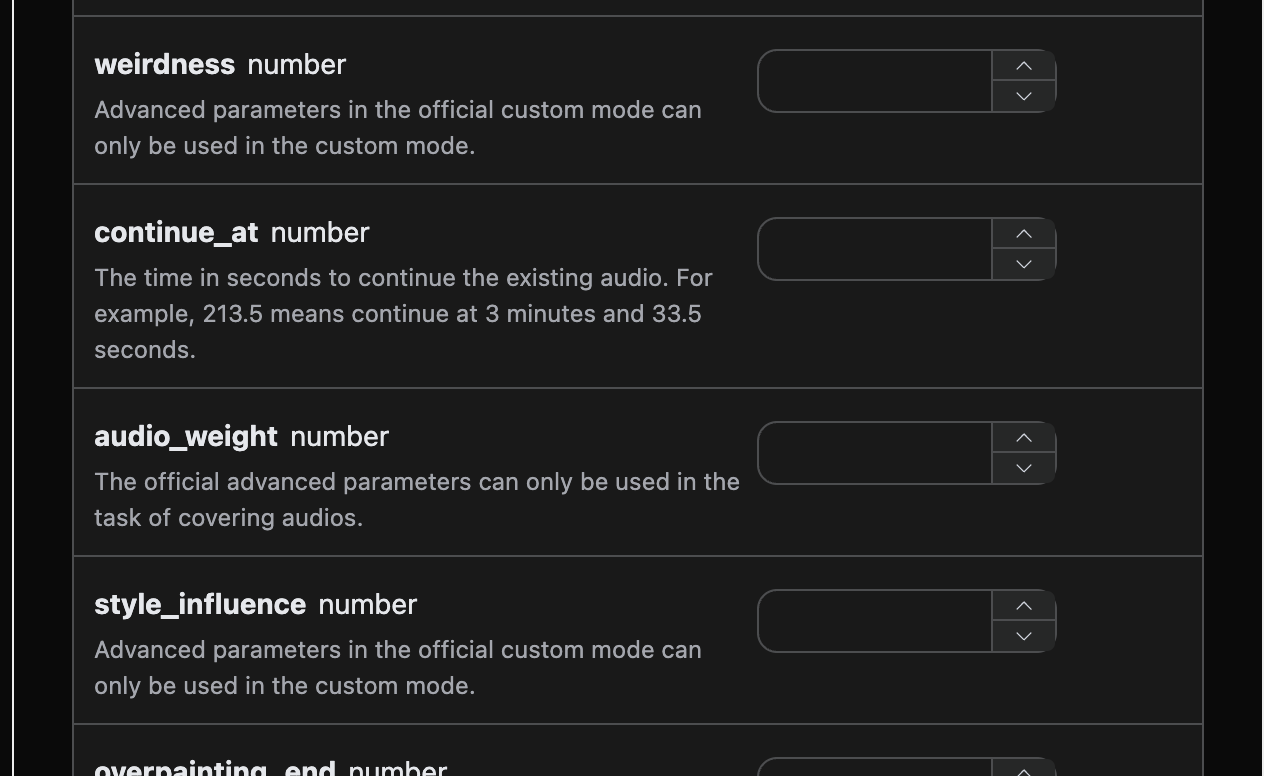
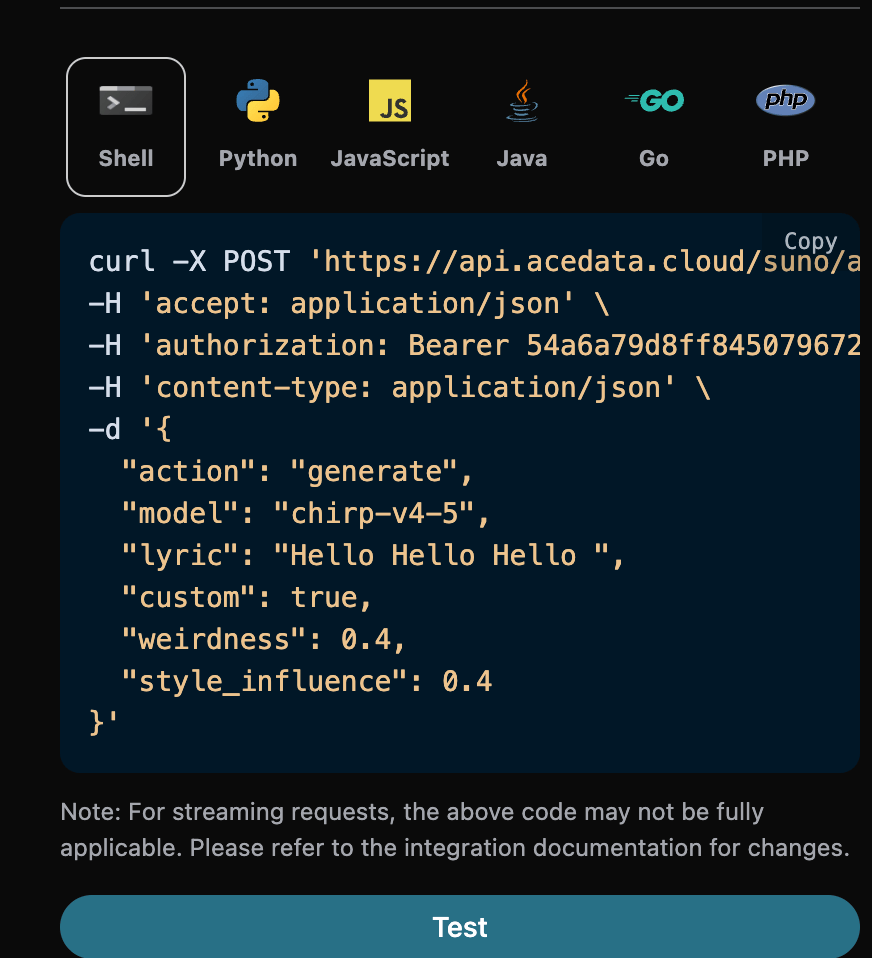
官方允许在自定义模式下使用高级参数weirdness==>Weirdness、style_influence==>Style Influence、audio_weight==>Audio Influence来进行生成,对应如下如的官方示例:
控制歌曲时长
默认情况下生成的歌曲时长由模型自行决定,通常在 30 秒到 4 分钟之间。如果需要更长或更短的成品,可以通过duration 参数指定期望时长,单位是秒,取值为 10 到 360 之间的整数。
该参数用于自定义模式(custom 为 true)的歌曲生成。需要特别说明的是,duration 是一个倾向性提示,而不是硬性约束:模型在创作时会参考这个值,但不保证达到,实测中实际时长通常明显短于期望值,同一次请求返回的两首歌曲时长也可能相差数倍。即使是完全相同的请求,多次提交得到的时长也可能有较大差异。因此不要把它当作精确的时长控制来使用,如果业务上需要固定时长,请在拿到成品后自行裁剪或重试。
对应的 Python 代码:
duration 是期望时长,而响应 data 中每首歌曲的 duration 字段是该首歌曲的实际时长。两者名称相同但含义不同,实际时长不保证等于期望值。歌词长度是影响成品时长的主要因素之一,若需要较长的成品,建议同时提供更完整的歌词。
接口会校验 duration 必须是 10 到 360 的整数;它仍然只是生成目标,不是成品长度保证。
Add Insterumental 功能
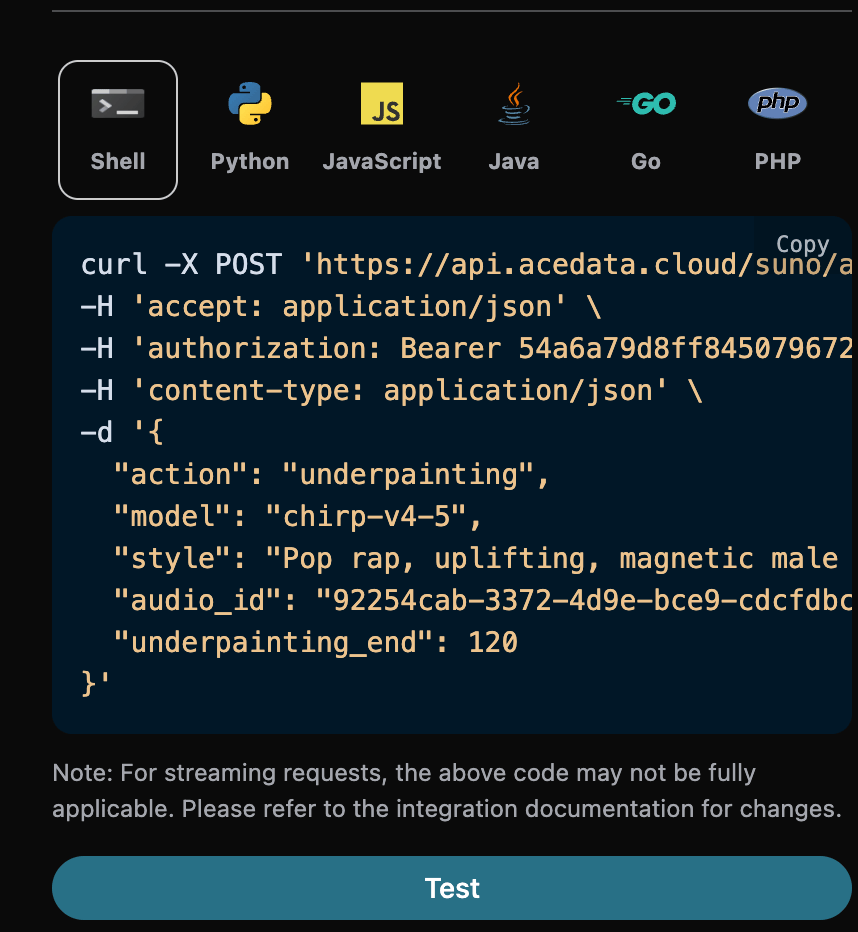
2025 年 8 月份 suno 新出 Add Insterumental 功能,首先需要上传一首清唱无配音的歌曲, 让 suno 帮你配乐,首先可以先到 Suno Upload API上传一首清唱无配乐的歌曲,对应如下如的操作如下图所示: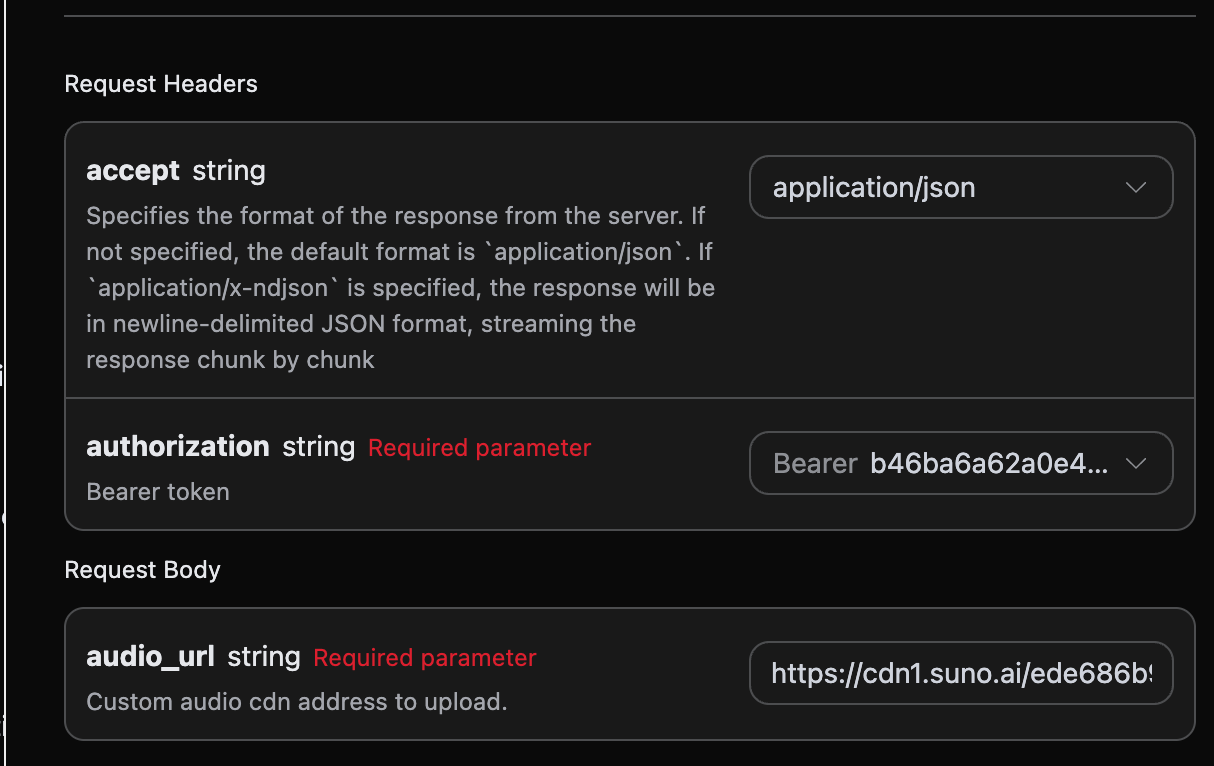
audio_id,具体的结果如下图所示:
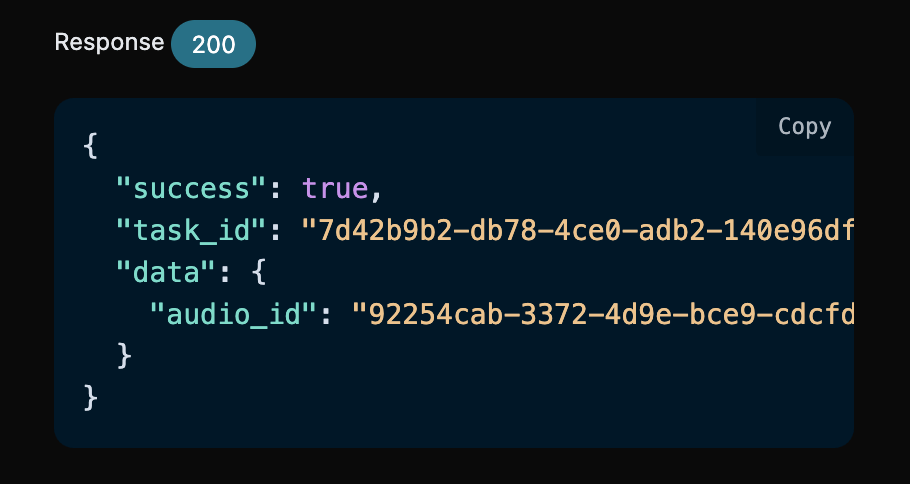
audio_id:92254cab-3372-4d9e-bce9-cdcfdbc39070,然后我们还需要填写如下参数:
- action:内容为
underpainting。 - underpainting_start:对上传的歌曲进行添加伴奏的起始时间,默认值是 0。
- underpainting_end:对上传的歌曲进行添加伴奏的终点时间,必须小于歌曲的总时长。
- audio_id:上传的清唱无配音的歌曲 ID。
- style:伴奏的风格,最好是不用歌词 毕竟是配音。
Add Vocals 功能
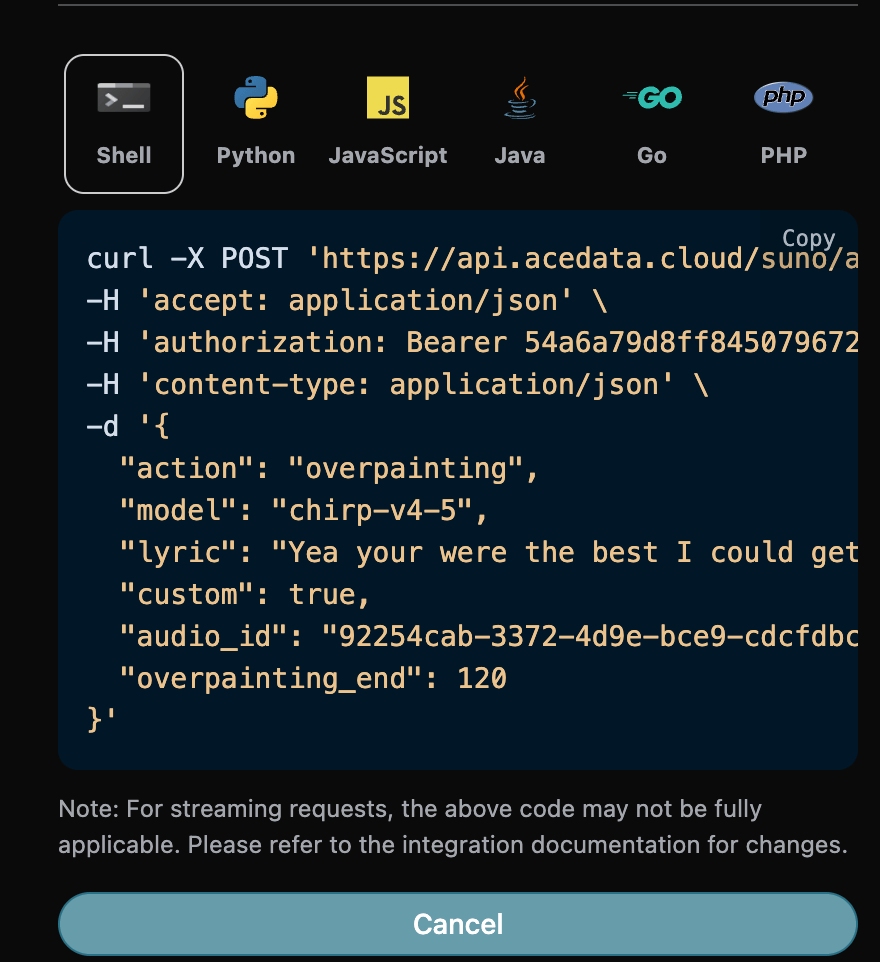
2025 年 8 月份 suno 新出 Add Vocals 功能,首先需要上传一首纯音乐,让 suno 填词、出人声歌唱,首先可以先到 Suno Upload API上传一首清唱无配乐的歌曲,对应如下如的操作如下图所示:
audio_id,具体的结果如下图所示:
audio_id:92254cab-3372-4d9e-bce9-cdcfdbc39070,然后我们还需要填写如下参数:
- action:内容为
overpainting。 - overpainting_start:对上传的歌曲进行添加人声的起始时间,默认值是 0。
- overpainting_end:对上传的歌曲进行添加人声的终点时间,必须小于歌曲的总时长。
- audio_id:上传的清唱无配音的歌曲 ID。
- custom:该模式下必须使用自定义模式填入歌词。
- lyric:自定义模式下填写的歌词。
- style:伴奏的风格。
Remaster 功能
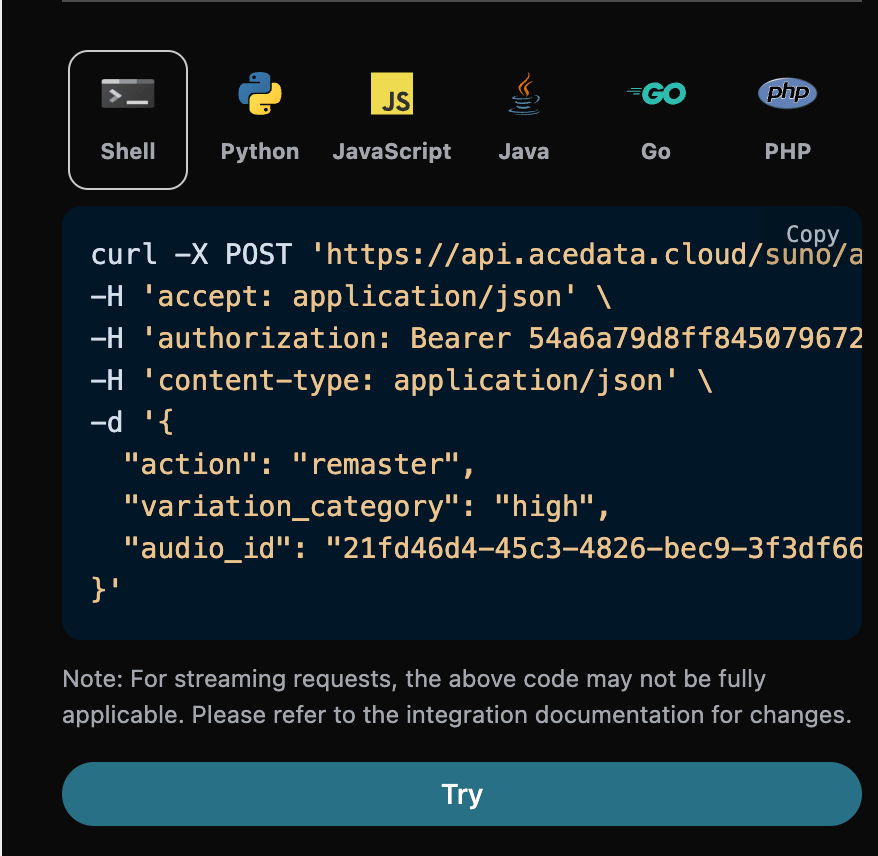
2025 年 12 月份 suno 新出 Remaster 功能,该功能可以重新生成歌曲,不可跨账号,然后我们还需要填写如下参数:- action:内容为
remaster。 - audio_id:需要重新生成的歌曲 ID。
- model:仅支持 v4.5+、v5。
- variation_category:仅在 v5 以上版本支持,而且只有 3 个值 high normal subtle。
Mashup 混曲生成功能
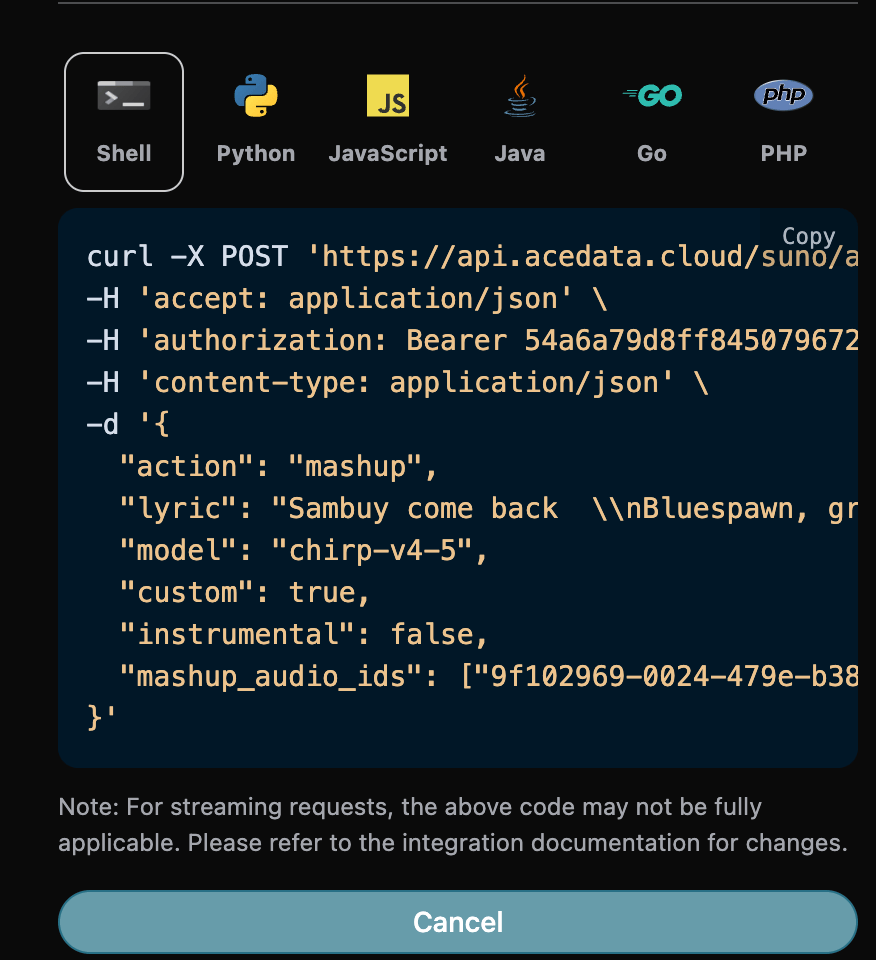
2025 年 12 月份 suno 新出 Mashup 功能,该功能可以根据俩首参考歌曲生成歌曲,然后我们还需要填写如下参数:- action:内容为
mashup。 - mashup_audio_ids:俩首参考歌曲的 ID。
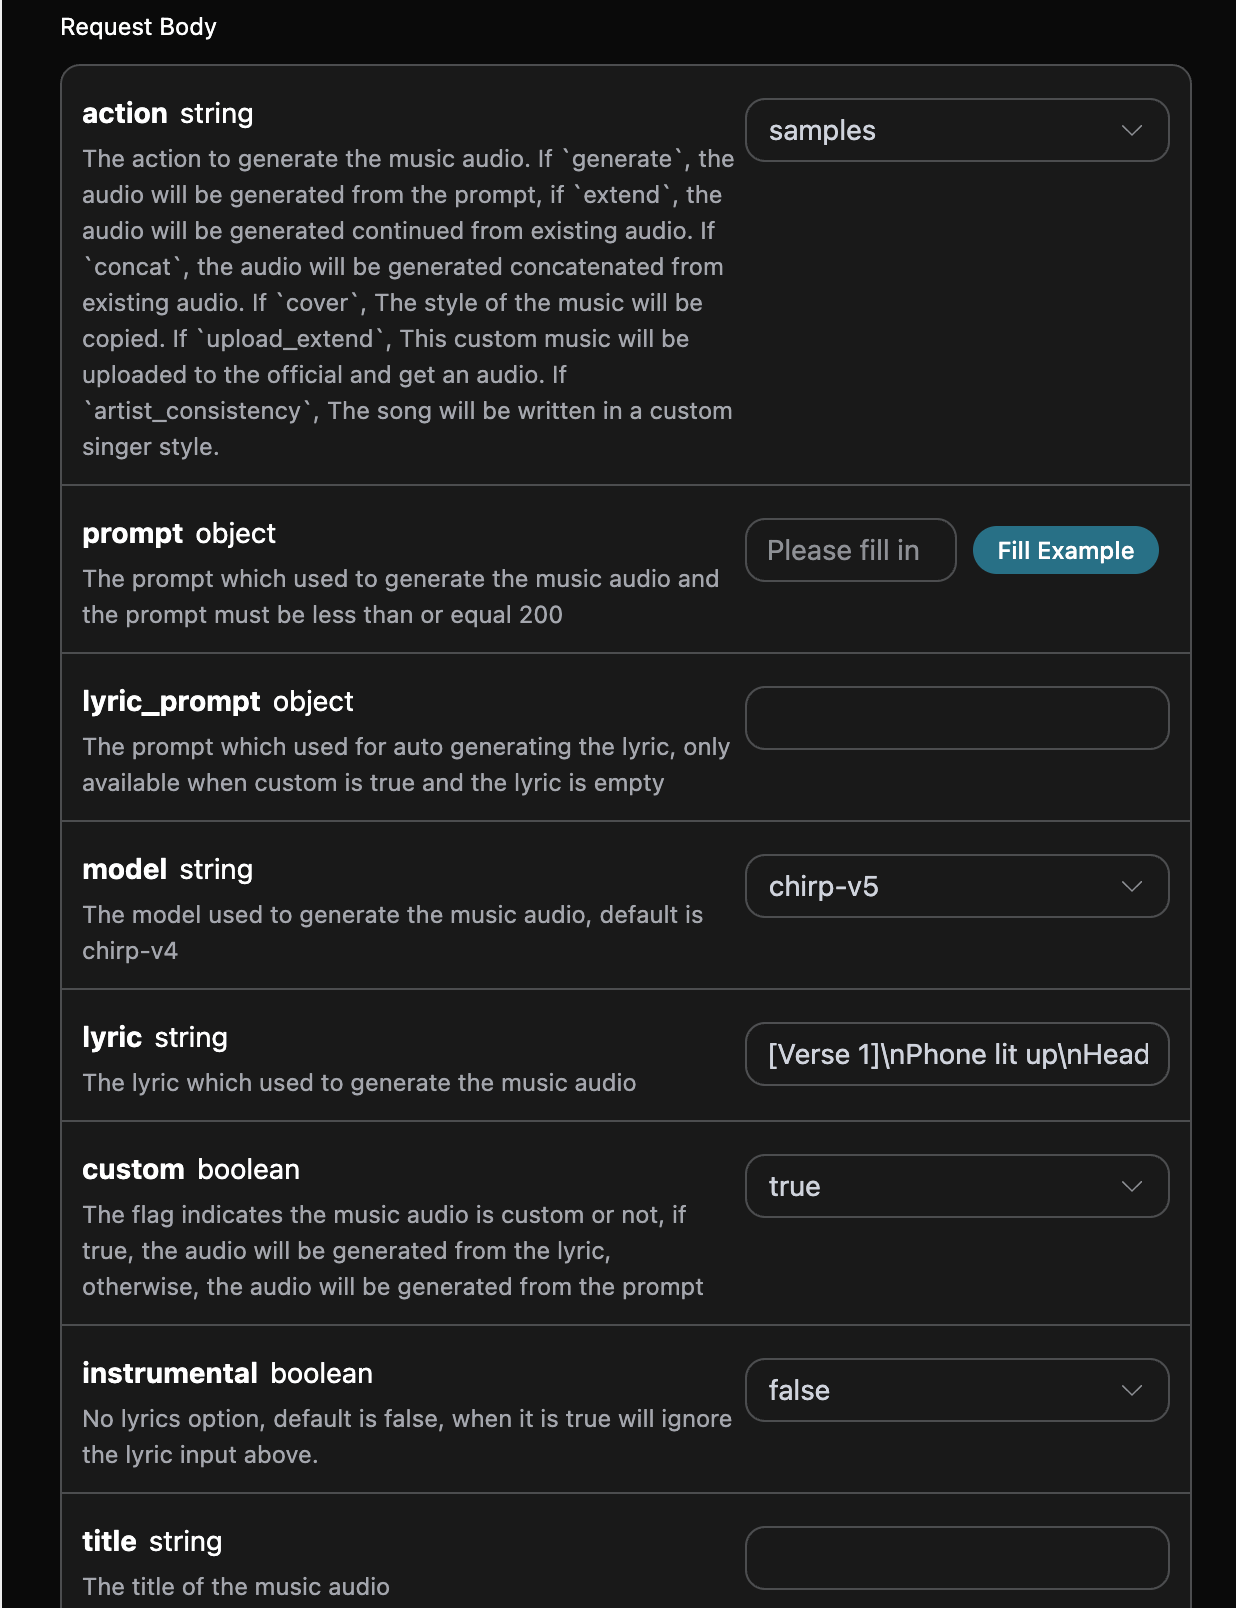
Samples 取样生成歌曲
这里的samples 是单音频区间取样:从一首已有音频中选择起止时间,将该片段作为采样素材进行创作。它不同于下文使用 1 到 4 段完整参考音频的 Inspo 灵感创作功能。需要填写如下参数:
- action:内容为
samples。 - samples_start:取样开始时间(秒),默认为 0,不得小于 0。
- samples_end:取样结束时间(秒),必填且必须大于开始时间。
- audio_id:需要取样的参考歌曲的 ID。
Inspo 灵感创作功能
Inspo 灵感创作功能可以根据 1 到 4 段完整参考音频生成新的音乐,支持拖拽或上传音频作为灵感来源。API 使用现有inspo action:客户端提供公开可访问的音频 URL,服务会自动完成参考音频准备和创作,无需客户端分别读取歌词、风格或时长再组装请求。它不同于上文的区间取样,也不同于复刻原曲风格的 Cover。使用时需要填写如下参数:
- action:内容为
inspo。 - audio_urls:参考音频的 URL 列表,需提供 1 到 4 个公开可访问的音频地址。
- model:使用的模型,推荐
chirp-v6。 - prompt:歌词或创作提示词(可选)。
- instrumental:设为
true时按纯音乐请求生成,不使用歌词。 - persona_id:在支持该组合的服务通道上使用指定声音;参考音频会在准备阶段绑定到该声音所需的资源环境。
- lyric_prompt:当
custom=true且未提供lyric时,用于自动生成歌词。
说明:参考音频需为公开可访问的音频文件。若参考音频与平台曲库中的已知录音完全匹配,Suno 可能会因版权校验而拒绝生成,建议使用自有或由 Suno 生成的音频作为灵感来源。对应的 Python 代码:
chirp-v5,当前请求示例推荐 chirp-v6,返回结构一致:
异步回调
由于 Suno 生成音乐的时间相对较长,大约需要 1-2 分钟,如果 API 长时间无响应,HTTP 请求会一直保持连接,导致额外的系统资源消耗,所以本 API 也提供了异步回调的支持。 整体流程是:客户端发起请求的时候,额外指定一个callback_url 字段,客户端发起 API 请求之后,API 会立马返回一个结果,包含一个 task_id 的字段信息,代表当前的任务 ID。当任务完成之后,生成音乐的结果会通过 POST JSON 的形式发送到客户端指定的 callback_url,其中也包括了 task_id 字段,这样任务结果就可以通过 ID 关联起来了。
下面我们通过示例来了解下具体怎样操作。
首先,Webhook 回调是一个可以接收 HTTP 请求的服务,开发者应该替换为自己搭建的 HTTP 服务器的 URL。此处为了方便演示,使用一个公开的 Webhook 样例网站 https://webhook.site/,打开该网站即可得到一个 Webhook URL,如图所示:
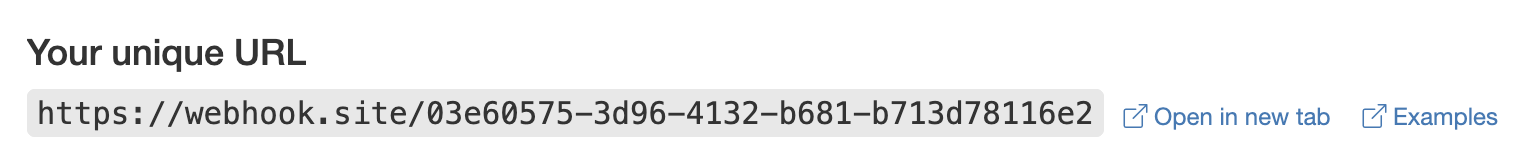 将此 URL 复制下来,就可以作为 Webhook 来使用,此处的样例为 https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2。
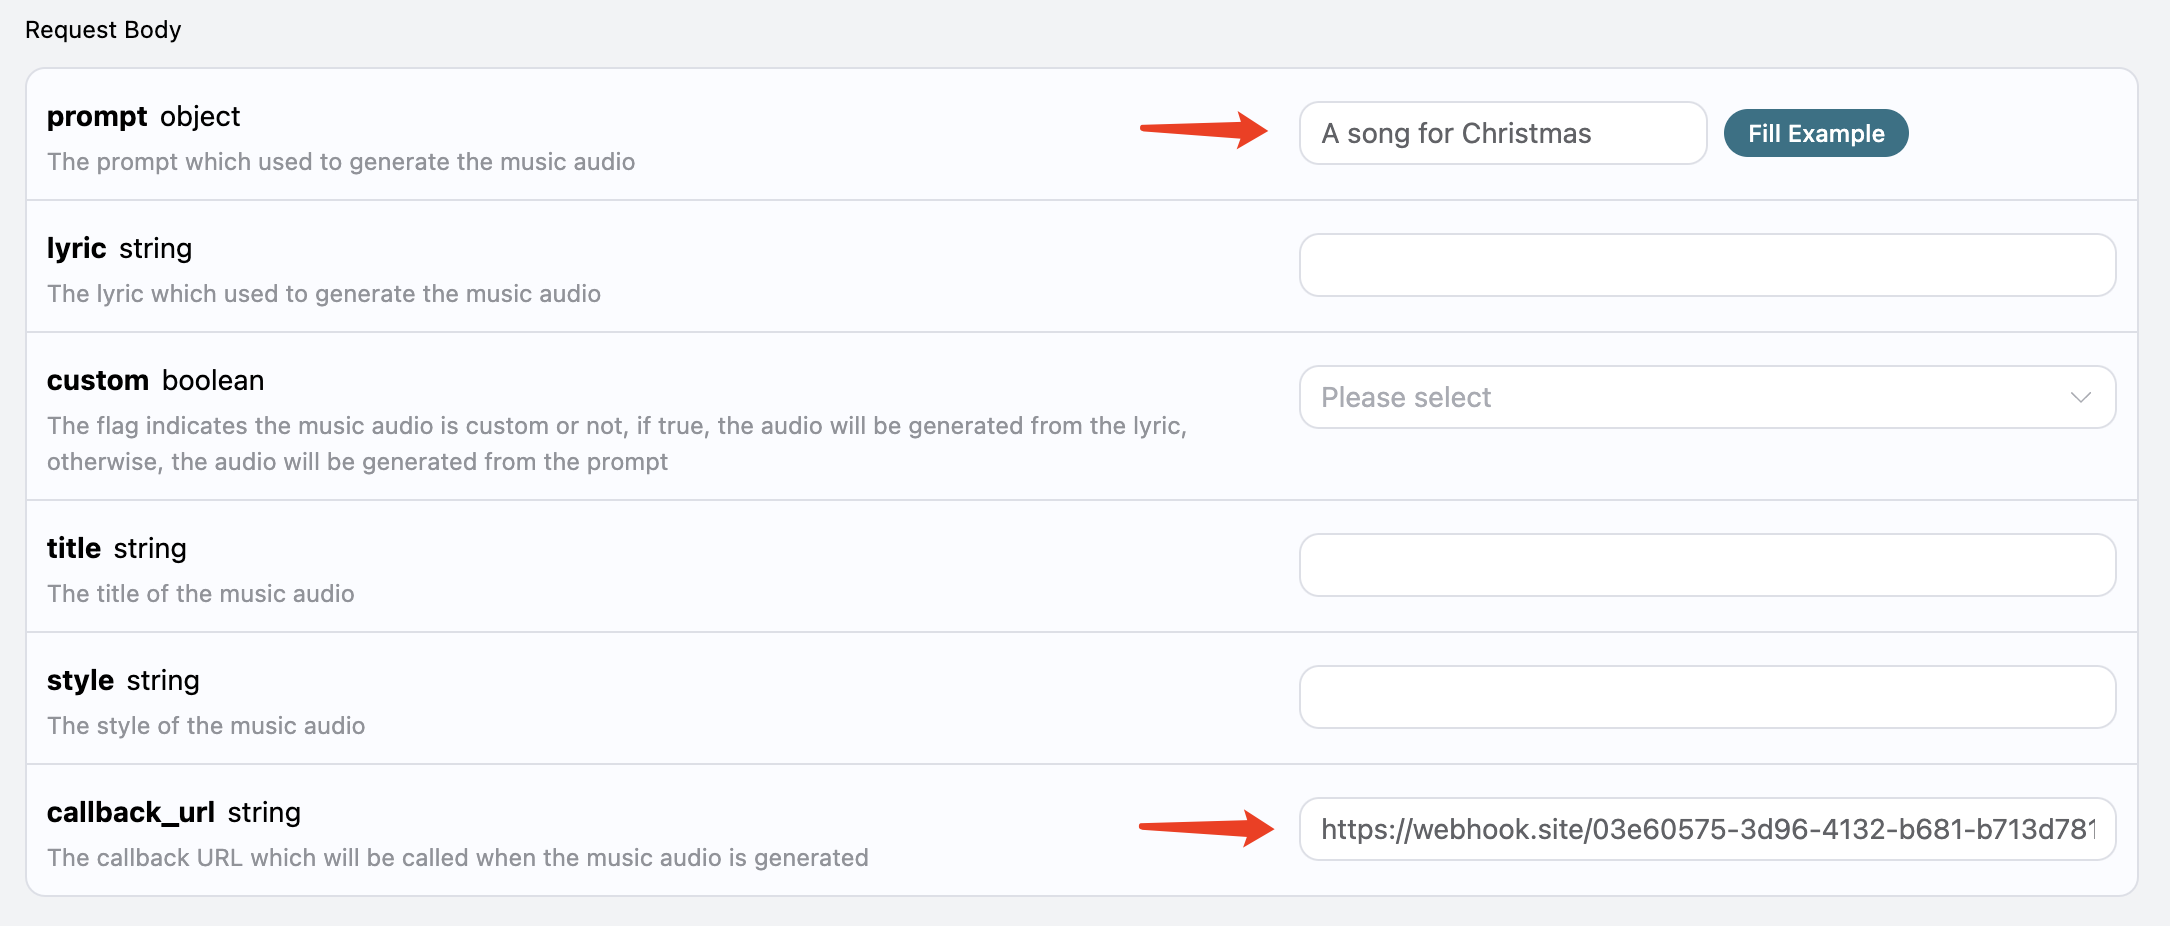
接下来,我们可以设置字段
callback_url 为上述 Webhook URL,同时填入 prompt,如图所示:
 点击运行,可以发现会立即得到一个结果,如下:
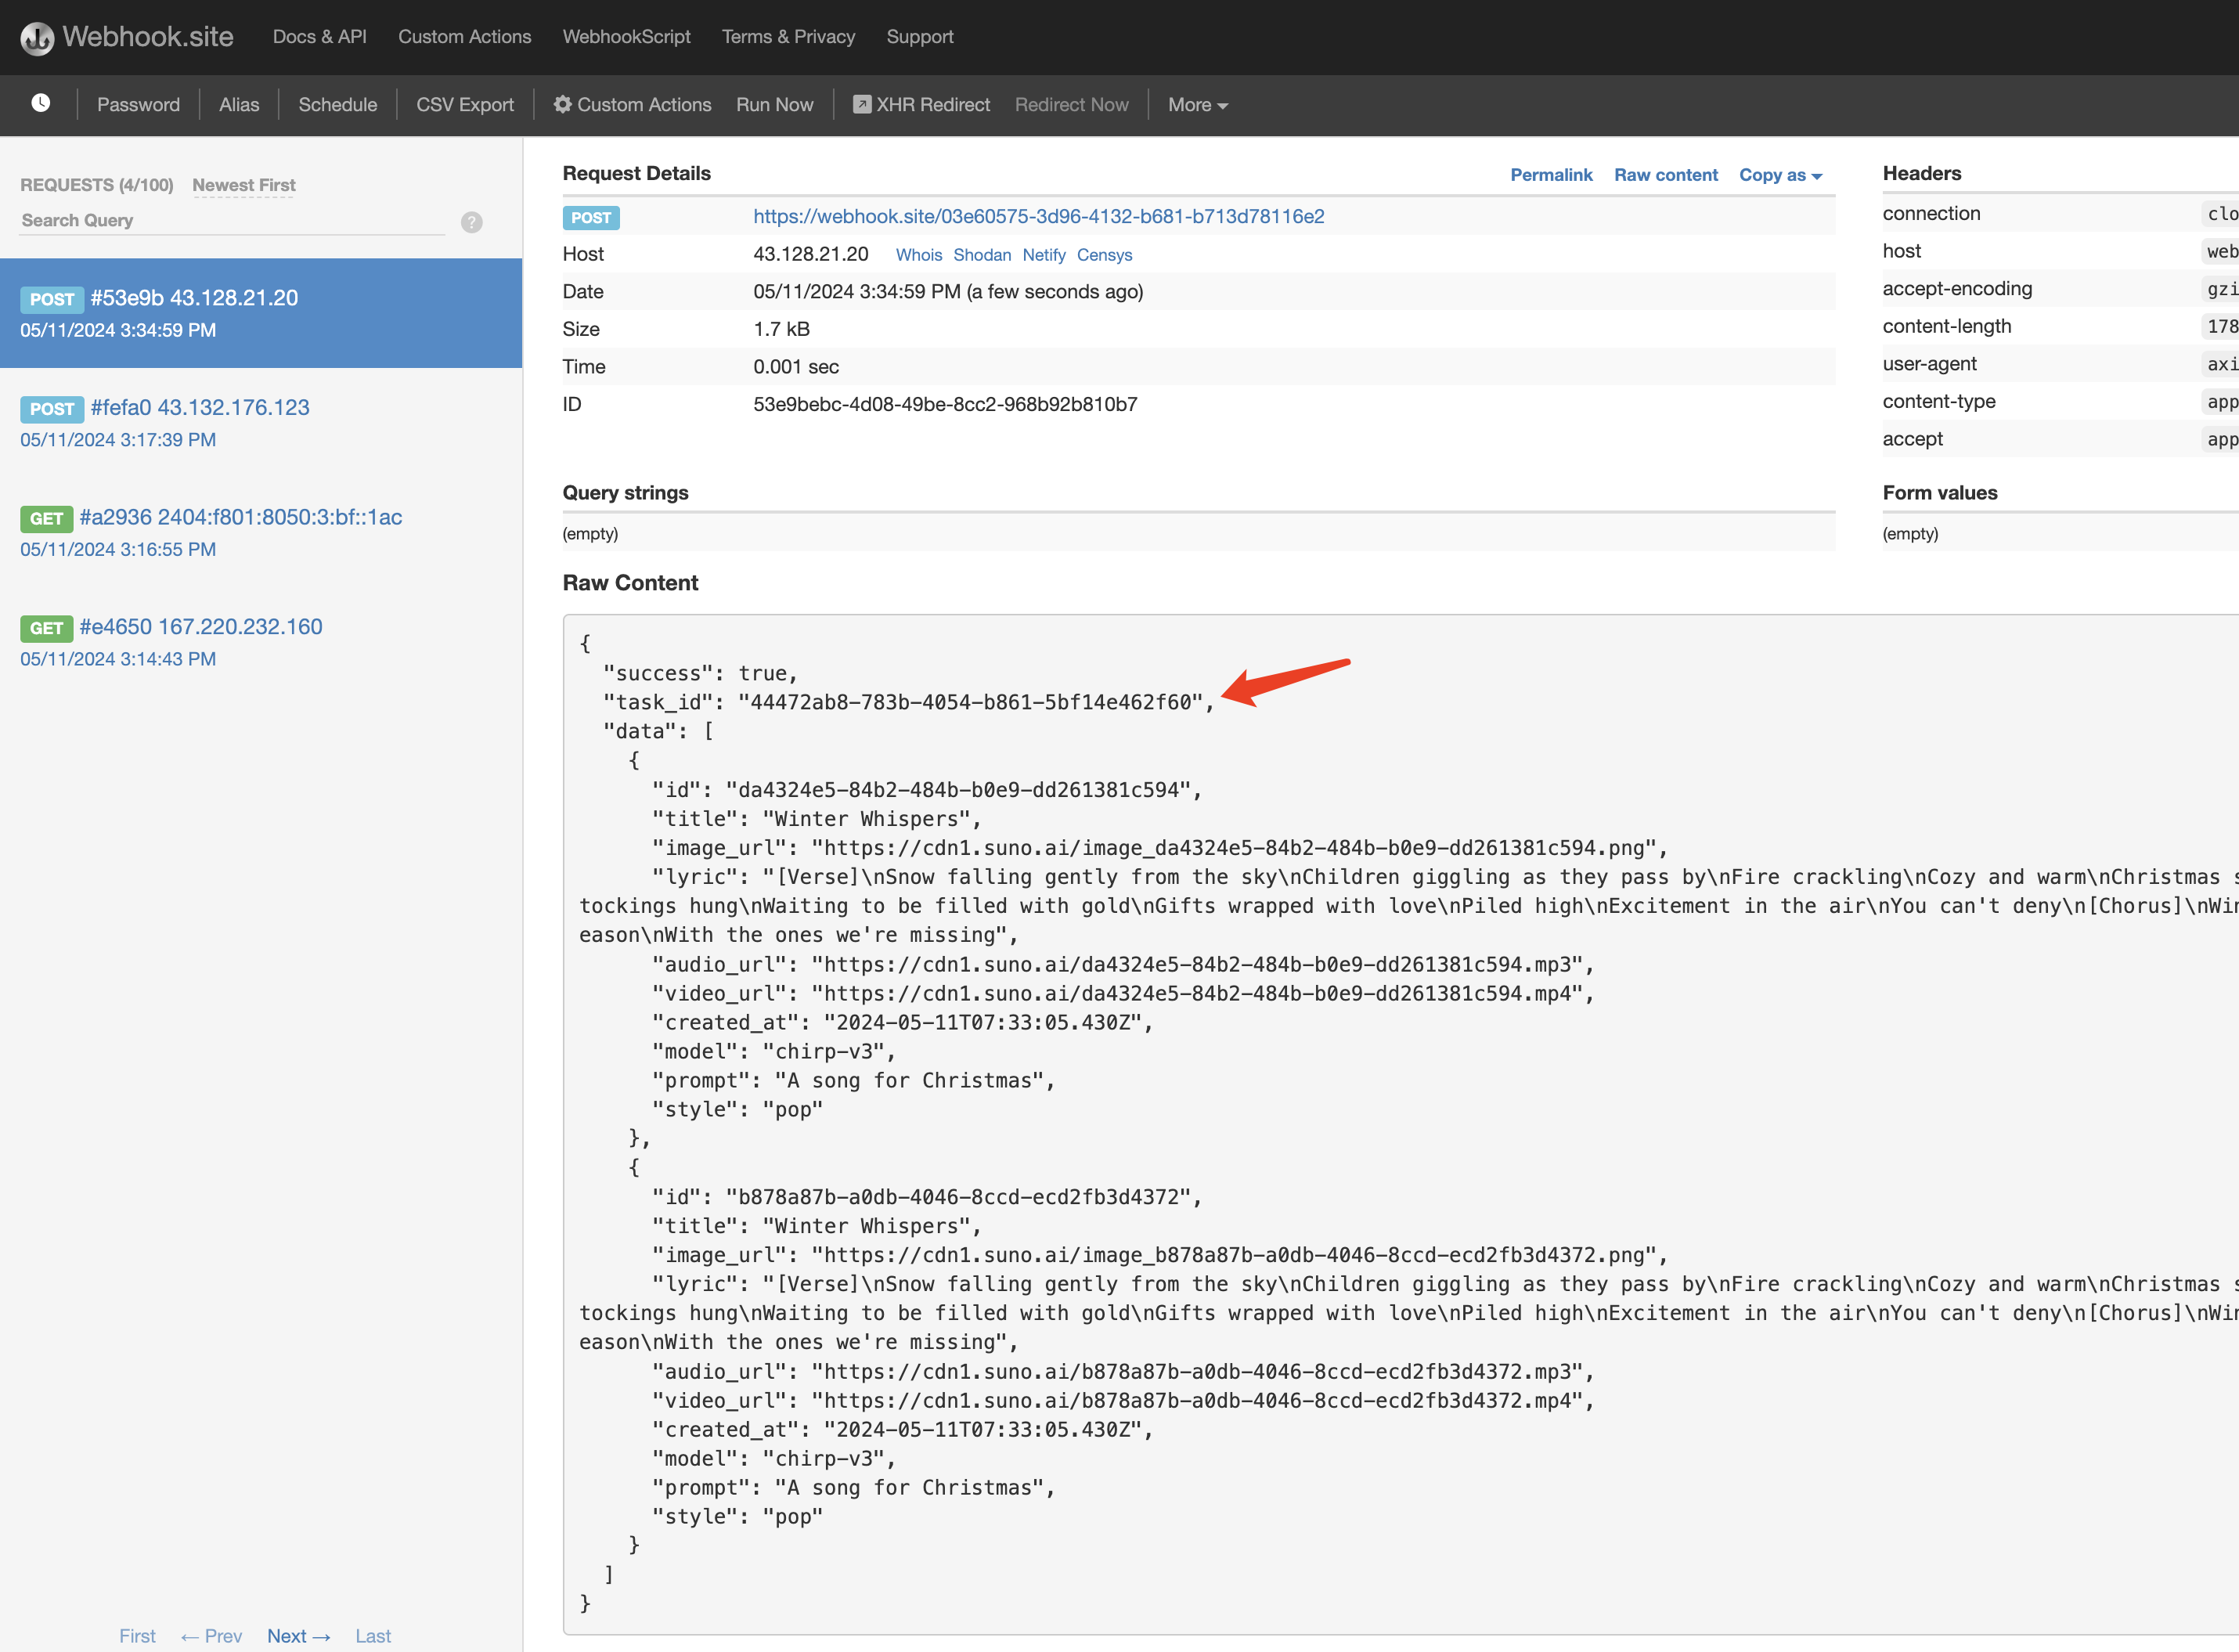 内容如下:
task_id 字段,其他的字段都和上文类似,通过该字段即可实现任务的关联。
当然我们也可以通过流式调用来获取结果,我们只需要将请求头里面的accept的值设置为application/x-ndjson即可,下面用一个示例输入作为示范:
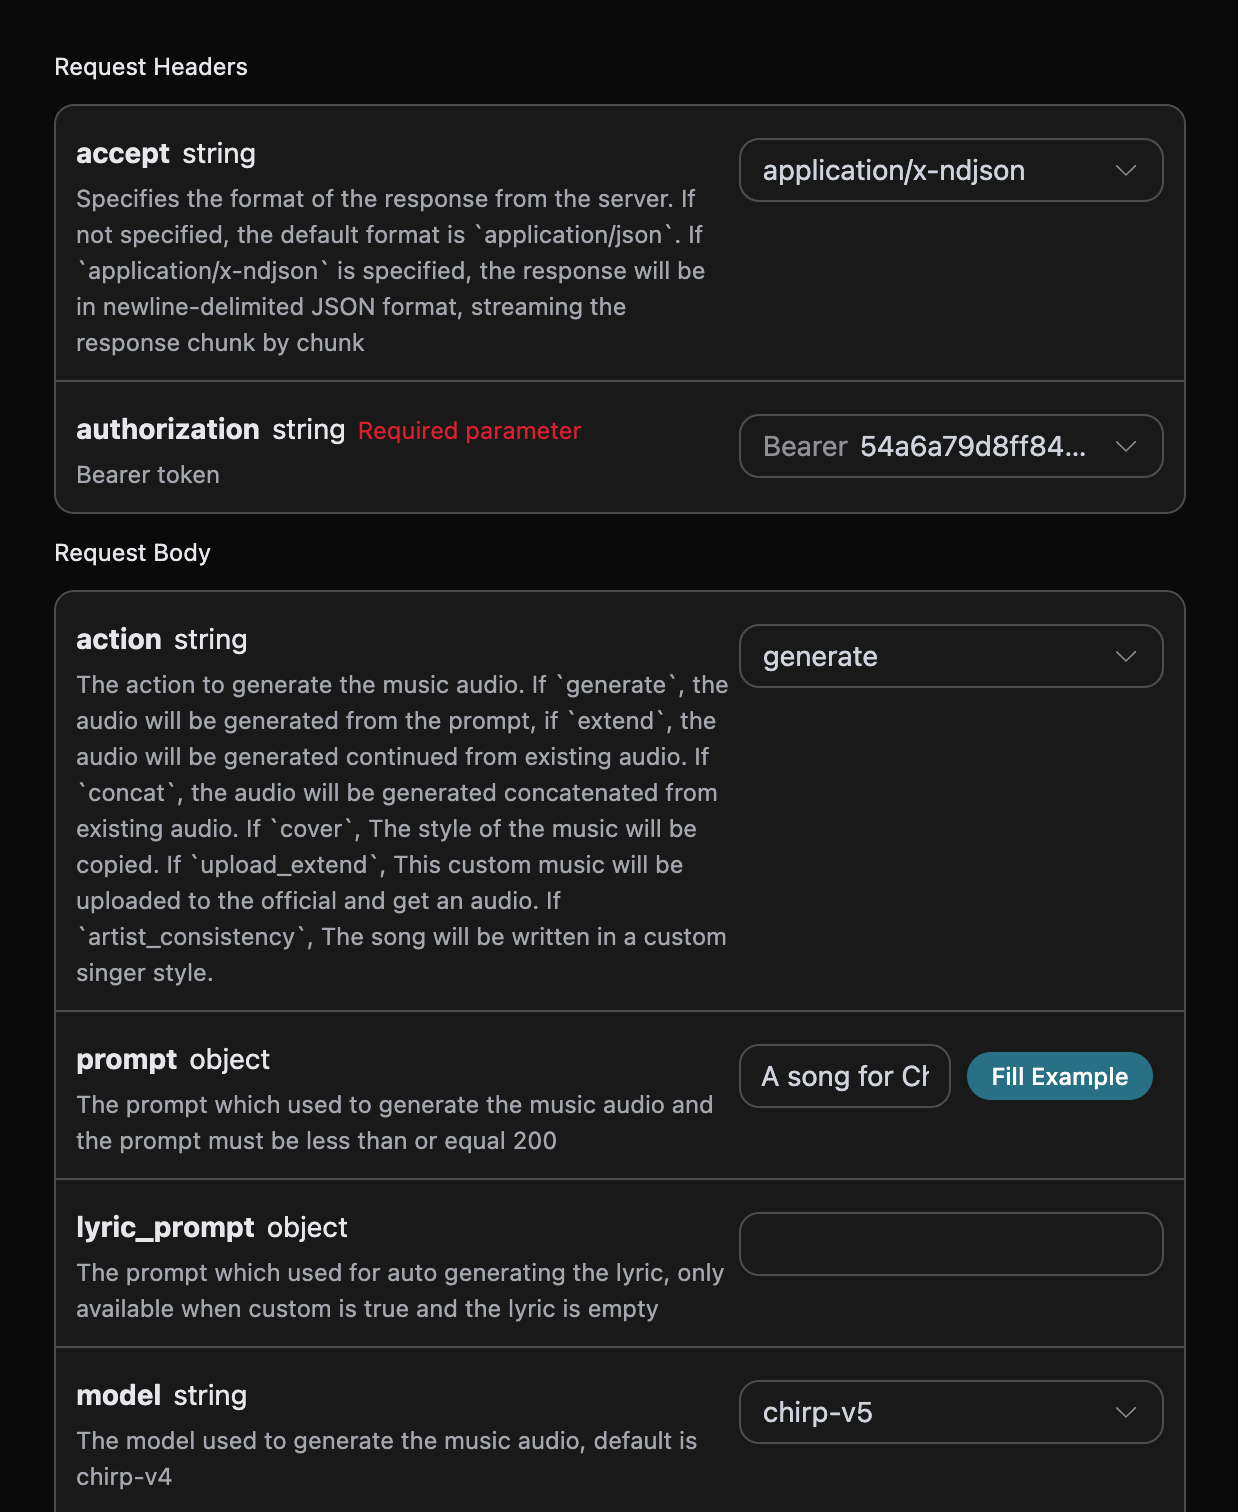
task_id 依次推送处理中状态和最终结果;上面仅保留首次与终态两条真实响应,省略重复的中间更新。
错误处理
如果发生错误,您将得到类似如下的错误信息:error.code, error.message 的列表:
说明:不同上游账号的限额和报错文案可能存在差异。通常chirp-v3-5/chirp-v4的style限制更低(200),chirp-v4-5及以上通常支持到 1000;当命中旧上游时,可能出现Tags too long.或style must be less than or equal 120等兼容文案。