Proceso de solicitud
Para utilizar Claude Messages API, primero obtenga su API Token en la consola de Ace Data Cloud y guárdelo como respaldo.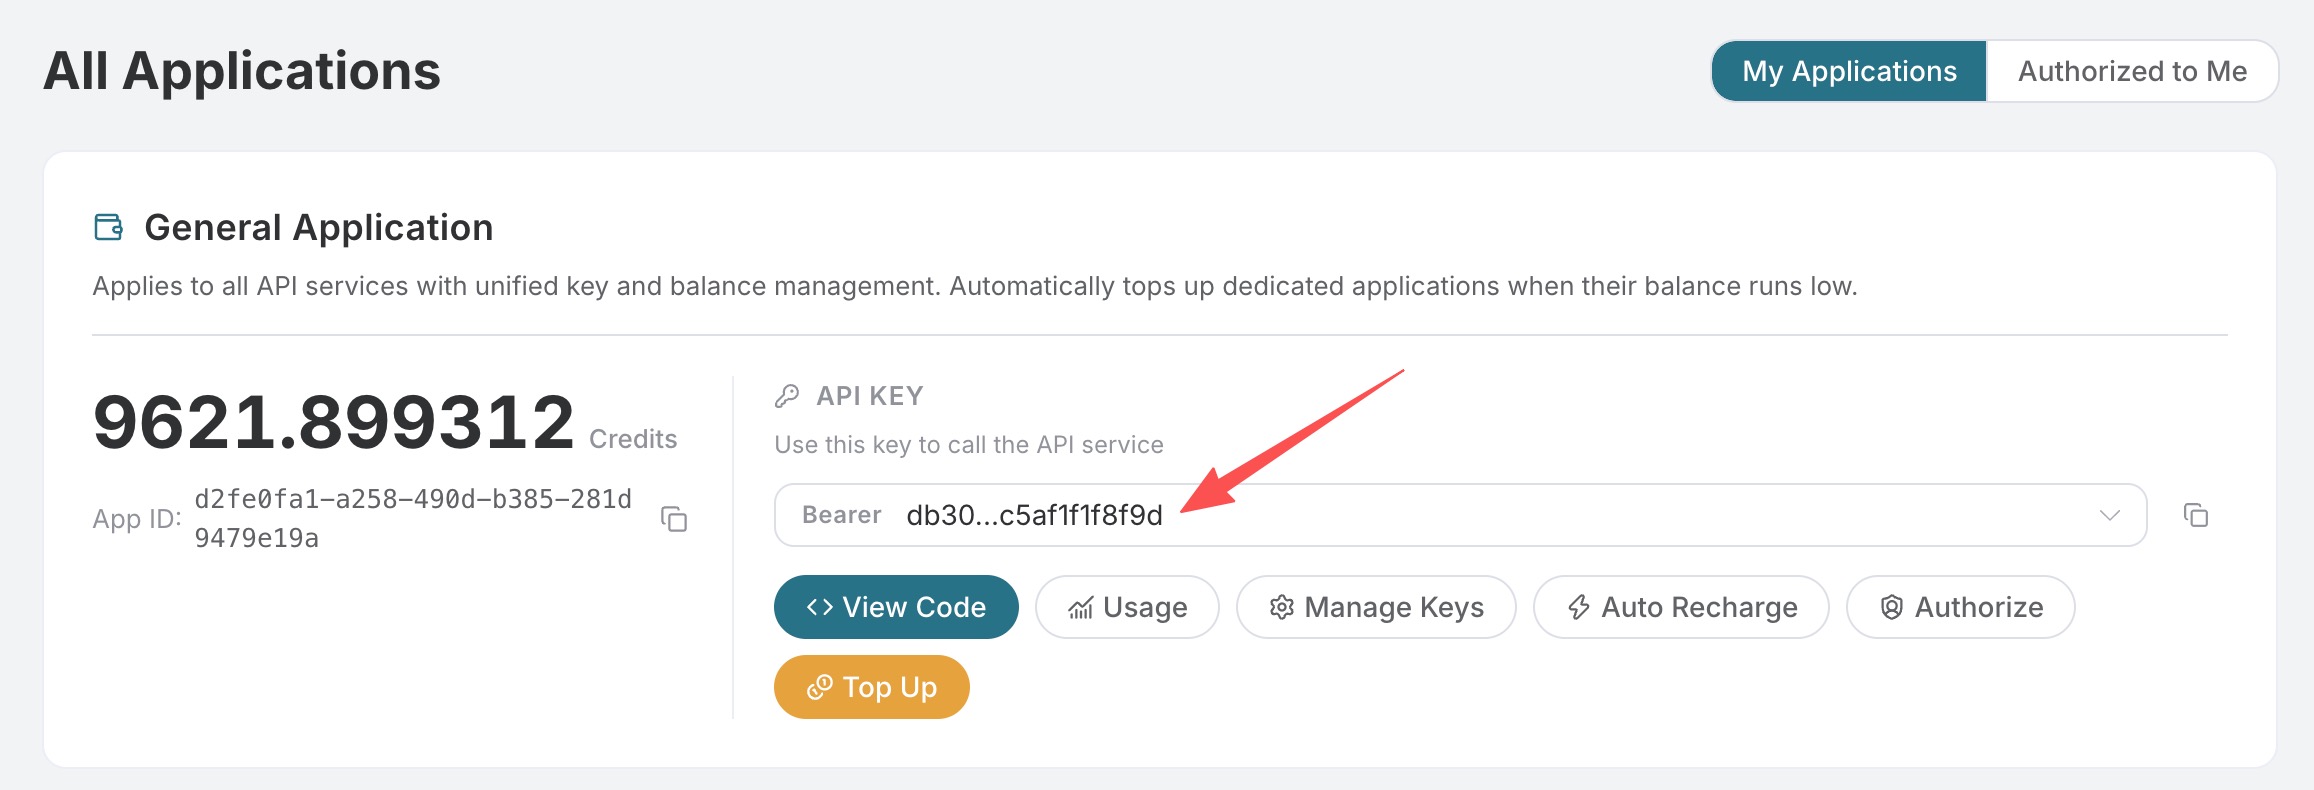 Si aún no ha iniciado sesión o no se ha registrado, será redirigido automáticamente a la página de inicio de sesión para invitarle a registrarse e iniciar sesión; al finalizar, volverá automáticamente a la página actual.
Un solo API Token puede invocar todos los servicios de la plataforma, sin necesidad de solicitar uno por separado para cada servicio. La primera solicitud incluirá crédito gratuito para una experiencia sin costo; cuando el crédito sea insuficiente, puede recargar saldo universal en la consola.
📘 Documentación completa: Claude Messages API →
Uso básico
La ruta de solicitud de Claude Messages API es/v1/messages, coherente con la API oficial de Anthropic. Necesitamos proporcionar al menos tres parámetros obligatorios:
model: Selecciona el modelo Claude que se utilizará.claude-opus-5-5solo se proporciona mediante Messages API, admite 1 millón de Token de contexto, una salida máxima de 128K Token y siempre habilita el pensamiento adaptativo. El último modelo insignia esclaude-fable-5-1(1 millón de Token de contexto, salida máxima de 128K Token); el anteriorclaude-fable-5sigue siendo compatible y se conserva.messages: El arreglo de mensajes de entrada; cada mensaje contienerole(rol) ycontent(contenido), donderoleadmiteuseryassistant.max_tokens: El número máximo de tokens de salida, utilizado para limitar la longitud de una sola respuesta.
system: Prompt del sistema, utilizado para establecer el comportamiento y el rol del modelo.temperature: Aleatoriedad de generación, entre 0 y 1; cuanto mayor sea el valor, más divergente será la respuesta.stream: Indica si se utiliza una respuesta en streaming; establecerlo entruepermite lograr un efecto de devolución carácter por carácter.stop_sequences: Secuencias de detención personalizadas; el modelo dejará de generar al encontrar estos textos.top_p: Parámetro de muestreo de núcleo, que controla la aleatoriedad de la generación junto con temperature.top_k: Solo realiza muestreo entre las K opciones con mayor probabilidad.tools: Definiciones de herramientas, utilizadas para permitir que el modelo invoque funciones externas.tool_choice: Controla cómo utiliza el modelo las herramientas proporcionadas.cache_control: Crea automáticamente un punto de interrupción de caché en el último bloque de contenido almacenable en caché de la solicitud; también puede escribirse en un bloque de contenido específico.
Ejemplo de cURL
Ejemplo de Python
id: Identificador único de este mensaje.type: Siempre esmessage.role: Siempre esassistant.content: Arreglo de contenido de respuesta; cada elemento contienetype(comotext) y el contenido correspondiente.model: Nombre del modelo que procesa la solicitud.stop_reason: Motivo de detención. Los valores estables incluyenend_turn,max_tokens,stop_sequence,tool_use,pause_turn(puede devolver el contenido actual de assistant sin cambios para continuar),refusalymodel_context_window_exceeded.stop_sequence: Si se detiene debido a una secuencia de detención personalizada, muestra el texto de la secuencia de detención coincidente.stop_details: Cuandostop_reasonesrefusal, puede incluir la categoría y la explicación del rechazo.usage: Estadísticas de uso de token.input_tokenses la entrada no almacenada en caché;cache_creation_input_tokensycache_read_input_tokensson respectivamente la escritura y lectura de caché;output_tokenses el número total de tokens de salida. Si se devuelveoutput_tokens_details.thinking_tokens, este valor es un subconjunto deoutput_tokens; no lo sume de nuevo al calcular el total o el costo. Este desglose puede sernullu omitirse cuando no haya un recuento autorizado.usage.cache_creation: Desglose opcional de TTL de escritura de caché, que incluyeephemeral_5m_input_tokensyephemeral_1h_input_tokens. Cuando el objeto existe, la suma de ambos es igual acache_creation_input_tokens; que el campo seanullu omitido indica que la respuesta actual no tiene un desglose de TTL disponible y no puede interpretarse como0.usage.cost: Las respuestas no streaming pueden incluir un objeto de consumo de crédito registrado por Ace Data Cloud, dondeamountes el consumo real de esta solicitud,currencyes la unidad de medida ylist_amountes el importe antes del descuento (si lo hubiera). El precio base oficial de lectura de caché de Fable 5.1 es de 12.50 y $20/millón de Token, respectivamente; el precio real de la plataforma se convierte según el descuento del plan.
Prompt del sistema
Claude Messages API admite configurar el prompt del sistema mediante el camposystem, utilizado para definir el comportamiento, el rol y el contexto del modelo.
Ejemplo de Python
system, se puede controlar con precisión el rol y el comportamiento de Claude.
Respuesta en streaming
Esta interfaz también admite respuestas en streaming; basta con establecer el parámetrostream en true para obtener resultados devueltos progresivamente, lo que resulta muy adecuado para implementar una visualización carácter por carácter en páginas web.
Ejemplo en Python
event: y data:. Los tipos de eventos de streaming incluyen:
message_start: inicio del mensaje, contiene la información básica del mensaje y el nombre del modelo.content_block_start: inicio del bloque de contenido.content_block_delta: actualización incremental del bloque de contenido, contiene el fragmento de texto recién generado.content_block_stop: finalización del bloque de contenido.message_delta: actualización incremental a nivel de mensaje, contienestop_reasony la información final deusage. El valor autorizado deoutput_tokens_details.thinking_tokenssolo debe leerse del últimomessage_delta.usage; no se debe acumular entre eventos.message_stop: finalización del mensaje.
content_block_delta de la respuesta en streaming contiene el contenido de texto generado progresivamente; al concatenar todos los text_delta se obtiene la respuesta completa.
Ejemplo en JavaScript
Conversación de múltiples turnos
Si desea integrar la función de conversación de múltiples turnos, debe alternar los mensajes con los rolesuser y assistant en el arreglo messages, y pasar también todo el historial de conversación anterior.
Ejemplo en Python
messages, Claude puede proporcionar respuestas precisas basadas en el contexto.
Modelo de razonamiento profundo
El thinking y el thinking summary de Claude son dos conceptos distintos: el modelo puede realizar razonamiento interno, pero la API no devuelve la cadena de pensamiento original. Cuando se necesita mostrar el proceso de razonamiento, la API devuelve un resumen procesado. Actualmente se recomienda utilizar adaptive thinking con el modelo actual y controlar el esfuerzo general de razonamiento medianteoutput_config.effort:
display: "summarized"devuelve un resumen legible del razonamiento; no es la cadena de pensamiento original.display: "omitted"devuelvethinking: "", pero aún conserva lasignatureopaca para admitir conversaciones posteriores.- El valor predeterminado de display para Fable 5.1, Fable 5, Opus 5, Sonnet 5, Opus 4.8 y Opus 4.7 es
omitted; Opus 4.6, Sonnet 4.6 y los modelos anteriores que admiten thinking usansummarizedde forma predeterminada. - Display solo afecta el contenido devuelto y la latencia de streaming, no desactiva el razonamiento ni reduce la facturación de los tokens de thinking.
- Si thinking está habilitado de forma predeterminada y el valor predeterminado de display son dos cuestiones independientes. Opus 5 y Sonnet 5 habilitan adaptive thinking de forma predeterminada; para Opus 5, omitir
thinkingequivale a adaptive, y omitiroutput_config.effortequivale ahigh. Opus 4.8, 4.7 y 4.6 requieren habilitación explícita. - Thinking y el cuerpo final comparten el presupuesto de salida de
max_tokens. Cuando el presupuesto es demasiado pequeño, thinking puede consumir la mayor parte de la cuota, dejando el cuerpo vacío o truncado; aumentemax_tokens, o use el esfuerzolow/mediumpara controlar la inversión de razonamiento. - Para los modelos que permiten desactivar thinking, se puede pasar
thinking: {"type":"disabled"}; disabled solo puede combinarse conlow,mediumohigh,xhigh/maxdevolverá 400. budget_tokenssolo se usa para modelos antiguos que aún admiten presupuestos de pensamiento fijos. Los modelos nuevos deben usarthinking.type=adaptiveyoutput_config.effort; thinking de Fable 5.1 siempre está activado y no puede desactivarse explícitamente.- En conversaciones de varias rondas y llamadas a herramientas, se deben devolver sin cambios los bloques completos de thinking y signature devueltos por assistant; no modifique ni genere signature por su cuenta.
- Algunas rutas compatibles no pueden procesar sin pérdida
redacted_thinkingo la desactivación explícita de thinking; en ese caso devolverán un error de parámetros, en lugar de descartar silenciosamente o cambiar la semántica de la solicitud.
summarized produce thinking_delta; omitted no produce thinking_delta, solo conserva el ciclo de vida del bloque thinking y signature_delta.
Modelos de visión
Claude admite entradas multimodales y puede procesar texto e imágenes al mismo tiempo. En la API de Messages, las capacidades de visión se pueden usar estableciendocontent en formato de matriz y pasando bloques de contenido de imagen.
Usar imágenes codificadas en Base64
Usar imágenes URL
Ejemplo de cURL
image/jpeg, image/png, image/gif, image/webp.
Documentos y PDF
Los PDF usan bloques de contenidodocument y admiten dos fuentes estables: Base64 y URL. Las fuentes Base64 deben usar application/pdf:
{"type":"url","url":"https://example.com/report.pdf"}. document también admite text/plain y fuentes content compuestas por bloques text/image; los campos opcionales incluyen title, context y citations. La fuente file_id de la API de Files pertenece a una función beta independiente y no forma parte del contrato estable de esta interfaz.
Caché de prompts
cache_control de nivel superior colocará automáticamente el punto de interrupción de caché en el último bloque almacenable en caché:
cache_control también puede escribirse en los bloques de contenido text, image, document, tool_use, tool_result o en las definiciones de herramientas. ttl admite 5m (predeterminado) y 1h; determine la escritura y los aciertos de caché mediante usage.cache_creation_input_tokens y usage.cache_read_input_tokens.
Cuando la respuesta proporciona usage.cache_creation, ephemeral_5m_input_tokens + ephemeral_1h_input_tokens = cache_creation_input_tokens. Si cache_creation es null o se omite, indica que solo existe el total de escrituras de caché y no un desglose de TTL autorizado; en ese caso, no trate ningún bucket como un 0 conocido, y la facturación y el total siguen basándose en el campo agregado.
Ejemplo de resultado devuelto:
Uso de herramientas (Tool Use)
La API de Mensajes de Claude admite de forma nativa la funcionalidad de llamada de herramientas, lo que permite al modelo llamar a sus herramientas/funciones predefinidas cuando sea necesario.Ejemplo de Python
tool_use en content:
stop_reason es tool_use, lo que indica que el modelo necesita llamar a una herramienta. Después de recibir este resultado, debe ejecutar la función de herramienta y devolver el resultado al modelo en forma de tool_result:
Diferencias con la API de Chat Completion
Ace Data Cloud proporciona simultáneamente dos formatos de API de Claude; las principales diferencias entre ambos son las siguientes: Elusage.input_tokens de la API de Mensajes solo representa la entrada no almacenada en caché; cache_read_input_tokens y cache_creation_input_tokens son grupos de facturación independientes; los tres se calcularán por separado según los precios correspondientes.
Si su sistema ya está integrado con una API en formato OpenAI, puede utilizar la API de Chat Completion para realizar un cambio sin interrupciones. Si necesita utilizar todas las capacidades nativas de Claude, se recomienda utilizar la API de Mensajes.
Manejo de errores
Las respuestas de error de las interfaces públicas utilizan el envelope de la plataforma Ace Data Cloud:error.code es un código de error estable, error.message es una descripción y trace_id se utiliza para investigar solicitudes. Los estados HTTP comunes incluyen:
400: Los parámetros de la solicitud o el contenido del protocolo no son válidos.401: El token de autorización no es válido, falta o ha expirado.403: Acceso prohibido, saldo insuficiente o cuota restringida.404: La API o el modelo no existe.413: El cuerpo de la solicitud es demasiado grande.429: Demasiadas solicitudes.500/503/504: Error del servicio, no disponible temporalmente o tiempo de procesamiento agotado.
Ejemplo de respuesta de error
error.code.